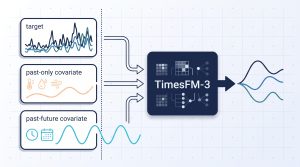
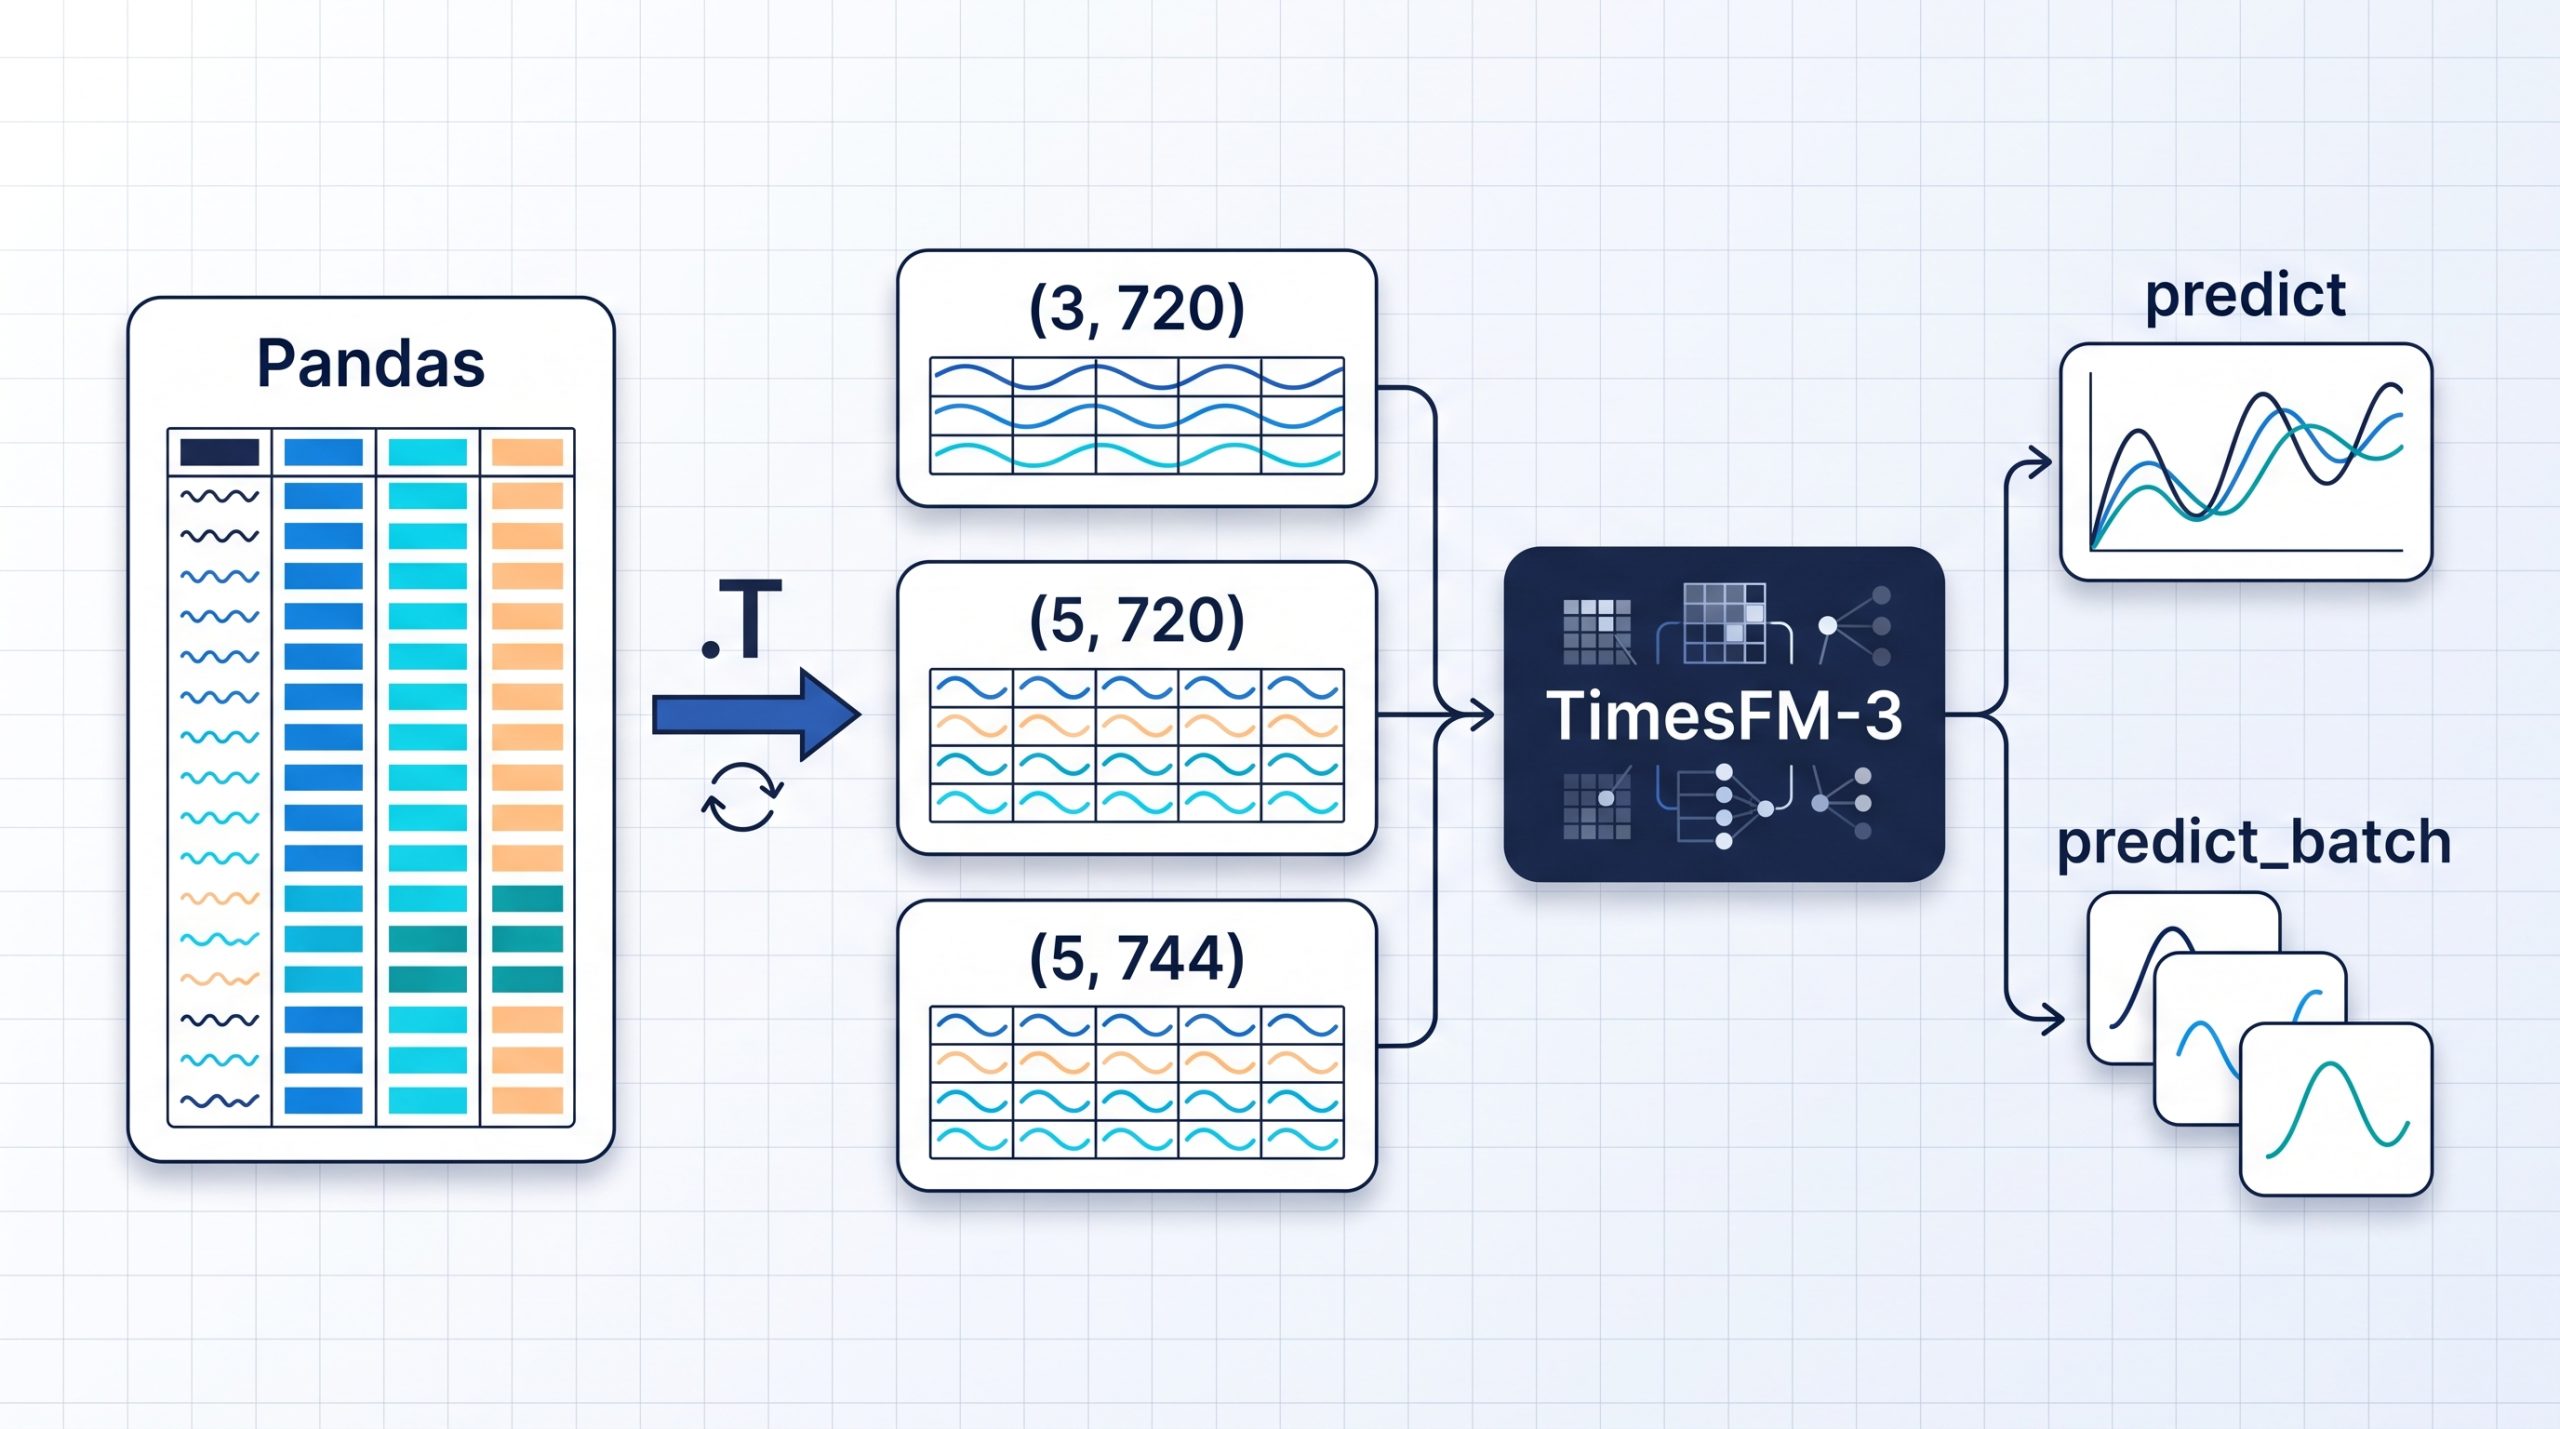
TimesFM-3へ時系列データを渡すには、DataFrameを(系列数, 時点数)のNumPy配列へ変換します。
本記事では、テトゥアン市の電力消費データから3種類の入力配列を作成し、predictとpredict_batchで予測するところまで実装します。
入力の分類基準や単変量・多変量予測の違いは、入門編で説明しています。
| 入力 | 必要な時間範囲 | 今回のshape |
|---|---|---|
| target | context | (3, 720) |
| past-only covariate | context | (5, 720) |
| past-future covariate | context + horizon | (5, 744) |
Python・Pandas・NumPyの基本操作ができ、TimesFM-3へ渡す入力配列を再現可能な形で作りたい読者を想定しています。
TimesFM-3の入力配列を作る手順
ここからは、コードを上から順に実行できるように、次の順番で入力データを作ります。
- CSVを読み込み、日時indexを作る
- 10分値を1時間値へ集計し、欠損を検査する
- contextとhorizonの日時範囲を決める
- カレンダー特徴をDataFrameとして作る
- NumPy配列へ変換し、shapeを検査する
今回の設定は、2017年2月1日0時を予測開始時刻とし、直前30日間から次の24時間を予測するものです。
context = 30日 × 24時間 = 720
horizon = 1日 × 24時間 = 24
context + horizon = 744
① CSVを読み込み、日時indexを作る
まず、CSVを読み込み、日時と使用列を確定します。
※Zone 2とZone 3の元列名には空白が2つ含まれるため、実際のCSVと同じ文字列を指定します。(6行目のカラム名)
UCI Machine Learning Repositoryで公開されている「Power Consumption of Tetouan City」データセットを使用します。CSVファイルをダウンロードし、data/Tetuan City power consumption.csvとして配置してください。別の場所に保存した場合は、DATA_PATHを変更してください。
import numpy as np
import pandas as pd

DATA_PATH = "data/Tetuan City power consumption.csv"

ZONE_COLUMNS = [
    "Zone 1 Power Consumption",
    "Zone 2  Power Consumption",
    "Zone 3  Power Consumption",
]
WEATHER_COLUMNS = [
    "Temperature",
    "Humidity",
    "Wind Speed",
    "general diffuse flows",
    "diffuse flows",
]
VALUE_COLUMNS = ZONE_COLUMNS + WEATHER_COLUMNS

raw = pd.read_csv(DATA_PATH)
raw["date"] = pd.to_datetime(
    raw["DateTime"],
    format="%m/%d/%Y %H:%M",
    errors="raise",
)

missing_columns = set(VALUE_COLUMNS) - set(raw.columns)
if missing_columns:
    raise ValueError(f"必要な列がありません: {sorted(missing_columns)}")

indexed = (
    raw.set_index("date")[VALUE_COLUMNS]
    .apply(pd.to_numeric, errors="raise")
    .sort_index()
)

if not indexed.index.is_unique:
    raise ValueError("日時に重複があります")
時系列の間隔と欠損を確認できるように、日時indexを持つDataFrameのまま前処理を進めます。
② 10分値を1時間値へ集計し、欠損を検査する
TimesFM-3には時間間隔を指定する引数がないため、利用者側で入力を等間隔にそろえます。
今回は、1時間ごとの代表的な電力消費水準を扱うため平均値を使用します。区間電力量を求める場合は、元データの単位を確認したうえで集計方法を選んでください。
また、10分間隔のデータであるため、1時間につき6件あることを確認してから平均します。
expected_index = pd.date_range(
    start=indexed.index.min(),
    end=indexed.index.max(),
    freq="10min",
)
if not indexed.index.equals(expected_index):
    raise ValueError("10分間隔で連続していない日時があります")

counts = indexed.resample("1h").count()
if not counts.eq(6).all().all():
    raise ValueError("1時間あたり6観測でない区間があります")

hourly = indexed.resample("1h").mean()

if hourly.isna().any().any():
    missing = hourly.isna().sum()
    raise ValueError(f"1時間値に欠損があります:\n{missing[missing > 0]}")

if not np.isfinite(hourly.to_numpy(dtype=float)).all():
    raise ValueError("NaNまたは無限値が含まれています")
欠損を自動補完すると処理内容を追跡しにくくなるため、今回はNaNや無限値が見つかった時点で処理を停止します。
③ contextとhorizonの日時範囲を決める
1時間値が完成してから、contextとhorizonの境界を決めます。
この順序にすることで、未定義のhourlyを参照する問題を防げます。
CONTEXT_LENGTH = 30 * 24
HORIZON = 24
forecast_start = pd.Timestamp("2017-02-01 00:00:00")

context_dates = pd.date_range(
    end=forecast_start - pd.Timedelta(hours=1),
    periods=CONTEXT_LENGTH,
    freq="1h",
)
forecast_dates = pd.date_range(
    start=forecast_start,
    periods=HORIZON,
    freq="1h",
)

missing_context = context_dates.difference(hourly.index)
if not missing_context.empty:
    raise ValueError(f"contextに存在しない日時があります: {missing_context[:5]}")

context_frame = hourly.loc[context_dates]未来24時間の電力実績は、入力配列には含めません。forecast_datesは、未来まで既知のカレンダー特徴を作るために使います。
④ カレンダー特徴をDataFrameとして作る
カレンダー特徴もDataFrameとして列を追加し、最後にまとめてNumPy配列へ変換します。
この形なら、特徴名、index、値を変換直前まで確認でき、後段のバックテストでも同じ関数を再利用できます。
CALENDAR_COLUMNS = [
    "hour_sin",
    "hour_cos",
    "dow_sin",
    "dow_cos",
    "is_weekend",
]

def make_calendar_frame(index: pd.DatetimeIndex) -> pd.DataFrame:
    hour = index.hour.to_numpy()
    day_of_week = index.dayofweek.to_numpy()

    values = np.column_stack(
        [
            np.sin(2 * np.pi * hour / 24),
            np.cos(2 * np.pi * hour / 24),
            np.sin(2 * np.pi * day_of_week / 7),
            np.cos(2 * np.pi * day_of_week / 7),
            (day_of_week >= 5).astype(float),
        ]
    )

    return pd.DataFrame(
        values,
        index=index,
        columns=CALENDAR_COLUMNS,
        dtype=np.float32,
    )

all_dates = context_dates.append(forecast_dates)
calendar = make_calendar_frame(all_dates)
カレンダー特徴は未来の日時から事前に計算できるため、context 720時間とhorizon 24時間を合わせた744時点を持ちます。
未来情報の漏洩に注意
未来側へ入力するのは、予測時点で確定しているカレンダー特徴だけです。未来の電力実績や、後から観測された気象実績は入力しません。
⑤ NumPy配列へ変換し、shapeを検査する
前処理と特徴量作成が終わった段階で、DataFrameをNumPy配列へ変換します。
DataFrameは「行=時刻、列=系列」ですが、TimesFM-3へ渡す2次元配列は「行=系列、列=時刻」です。
そのため、最後に.Tで転置します。
targets = (
    context_frame[ZONE_COLUMNS]
    .to_numpy(dtype=np.float32)
    .T
)
past_weather = (
    context_frame[WEATHER_COLUMNS]
    .to_numpy(dtype=np.float32)
    .T
)
known_calendar = (
    calendar[CALENDAR_COLUMNS]
    .to_numpy(dtype=np.float32)
    .T
)

expected_shapes = {
    "targets": (3, 720),
    "past_weather": (5, 720),
    "known_calendar": (5, 744),
}

arrays = {
    "targets": targets,
    "past_weather": past_weather,
    "known_calendar": known_calendar,
}

for name, array in arrays.items():
    assert array.shape == expected_shapes[name]
    assert array.dtype == np.float32
    assert np.isfinite(array).all()
以上で、target、過去の気象、既知のカレンダー特徴をTimesFM-3の入力shapeへ変換できました。
TimesFM-3を初期化する
以降のforecaster.predictを実行するには、先にパッケージをインストールし、モデルを初期化します。
PyTorch版の最小例は次のとおりです。
python -m pip install "timesfm[torch]==3.0.2" "torch==2.14.1" "pandas==2.2.3" "numpy==2.1.3"import platform
from importlib.metadata import version
from timesfm3 import TimesFM3Forecaster
MODEL_ID = "google/timesfm-3.0-pytorch"
MODEL_REVISION = "43046b85ec22d584a13f8098c2ed39c889e129c2"
print("Python:", platform.python_version())
print("timesfm:", version("timesfm"))
print("torch:", version("torch"))
print("pandas:", version("pandas"))
print("numpy:", version("numpy"))
print("OS:", platform.platform())
forecaster = TimesFM3Forecaster.from_pretrained(
MODEL_ID,
revision=MODEL_REVISION,
device="cpu", # 本記事ではMac上のCPU実行に固定
)
print("device:", forecaster.device)
print("model revision:", MODEL_REVISION)実行結果は次のとおりです。
Python: 3.11.16
timesfm: 3.0.2
torch: 2.14.1
pandas: 2.2.3
numpy: 2.1.3
OS: macOS-26.6-arm64-arm-64bit
device: cpu
model revision: 43046b85ec22d584a13f8098c2ed39c889e129c2
本記事では、Apple Silicon搭載MacのCPUで上記環境を確認しました。
モデルrevisionを固定しているため、Hugging Face上のモデルが更新された後も同じモデルウェイトを取得できます。
初回実行時はHugging Faceから重みを取得するため、ネットワーク接続と十分な保存容量が必要です。
利用条件の注意
2026年10月時点で、TimesFM-3のモデルウェイトには非商用・非本番利用を前提としたライセンスが適用されています。業務利用やサービスへの組み込みを検討する場合は、必ず最新のモデルカードとTimesFM-3公式ライセンスを確認してください。
predictとpredict_batchを使い分ける
predictとpredict_batchの引数一覧
predictとpredict_batchは、ほぼ同じ引数を持ちます。
大きな違いは、predictが1件の予測問題を受け取り、predict_batchが複数件をlistで受け取る点です。
| 引数 | predict | predict_batch | 役割 | 本記事の設定 |
|---|---|---|---|---|
context / contexts | np.ndarray | list[np.ndarray] | 予測対象となる過去のtarget系列 | 下表「contextとcontextsの入力shapeの違い」を参照 |
horizon | 整数 | 整数 | 予測する時点数 | 24 |
past_only_covariates | NumPy配列またはNone | NumPy配列またはNoneを要素に持つlist、もしくはNone | 過去区間だけ利用できる共変量 | 過去720時間の気象5系列 |
past_future_covariates | NumPy配列またはNone | NumPy配列またはNoneを要素に持つlist、もしくはNone | 過去と未来の両方で利用できる共変量 | 744時間のカレンダー5系列 |
ts_id / ts_ids | strまたはNone | list[str]またはNone | 出力へ付ける系列ID | 指定しない |
return_quantiles | bool | bool | 分位点予測も返すか | False |
use_symmetric_averaging | bool | bool | 元の入力と符号反転した入力の予測を平均するか | 既定値のFalse |
make_positive | bool | bool | 非負の入力系列に対して予測値を0以上へ補正するか | 既定値のFalse |
sort_quantiles | bool | bool | 分位点予測を値の小さい順に並べるか | 既定値のTrue |
use_znorm | bool | bool | 推論前に各系列をZ正規化するか | False |
padding_mode | "none"または"edge" | "none"または"edge" | 未来共変量の右側を末尾値で補うか | "none" |
本記事では入力shapeの違いを明確にするため、分位点配列は返さず(return_quantiles=False)、対称平均、非負補正、追加のZ正規化も使用しません。sort_quantilesは既定値のTrueとします。
contextとcontextsの入力shapeの違い
predict_batchでは、外側のlistの各要素が1件の予測問題です。一方、各配列の先頭軸は、その1件に含まれるtarget系列を表します。
| 呼び出し方 | 本記事で渡す入力 | 意味 |
|---|---|---|
多変量predict | targets:(3, 720) | 3系列を含む1件として 共同予測 |
単変量predict_batch | [targets[0], targets[1], targets[2]]:各要素は (720,) | 1系列ずつの3件として 独立予測 |
単変量predict_batchでは共変量もバッチ件数分そろえる
3地域を独立した単変量問題として処理する場合、targetだけでなく共変量も3要素のlistにします。
各要素のshapeと順序を対応させることが重要です。
同一の気象・カレンダー配列を全地域で共有する場合、呼び出し側で数値データをディープコピーする必要はありません。
次のように、推論中に変更しない同じ配列への参照をlistへ並べます。
# target: 各要素はtargetsの1行を参照する1次元配列 (720,)
independent_contexts = [
    targets[i]
    for i in range(targets.shape[0])
]

# 共通の共変量は、同じ配列への参照をバッチ件数分並べる
independent_past_weather = [
    past_weather
    for _ in independent_contexts
]
independent_known_calendar = [
    known_calendar
    for _ in independent_contexts
]
このlistは同じオブジェクトを参照するため、推論前後に配列をin-place更新しないことが前提です。
地域ごとに共変量を変更する場合だけ、その要素を個別に生成します。
3つのlistを対応させてpredict_batchへ渡します。
independent_outputs = list(
    forecaster.predict_batch(
        contexts=independent_contexts,
        horizon=HORIZON,
        past_only_covariates=independent_past_weather,
        past_future_covariates=independent_known_calendar,
        return_quantiles=False,
        use_znorm=False,
        padding_mode="none",
    )
)

assert len(independent_outputs) == 3
assert all(out.forecast.shape == (24,) for out in independent_outputs)

print(
    "predict_batch:",
    [out.forecast.shape for out in independent_outputs],
)
実行結果は次のとおりです。
predict_batch: [(24,), (24,), (24,)]3地域それぞれについて、24時間分の予測が返されました。
contextsだけをlist化し、共変量を(5, 720)や(5, 744)の2次元配列のまま渡してはいけません。
この誤りは、必ずshapeエラーになるとは限りません。
公開実装では共変量にlist(...)を適用するため、(5, 720)の5行が5つのバッチ要素として分解され、先頭3行だけが3地域へ1本ずつ誤って割り当てられる可能性があります。
predict_batchはpast_only_covariates[idx]とpast_future_covariates[idx]を各contextに対応付けるため、3つの引数は外側の要素数と順序を明示的にそろえます。
多変量predictでは共変量をlist化しない
3地域を共同予測する場合は、1件の多変量問題として2次元配列を直接渡します。
joint_output = forecaster.predict(
    context=targets,                         # (3, 720)
    horizon=HORIZON,
    past_only_covariates=past_weather,       # (5, 720)
    past_future_covariates=known_calendar,   # (5, 744)
    return_quantiles=False,
    use_znorm=False,
    padding_mode="none",
)

assert joint_output.forecast.shape == (3, 24)

print("predict:", joint_output.forecast.shape)
実行結果は次のとおりです。
predict: (3, 24)出力shapeは(3, 24)となり、3地域それぞれについて24時間分の予測が返されました。
TimesFM-3固有のパディングとスケーリング
本記事では、最初の検証条件としてpadding_mode="none"、use_znorm=False を指定します。
context長の調整はAPIが内部で行うため、720時点の配列を利用者側でパディングする必要はありません。
また、入力特徴を意図した値のまま確認できるように、追加のZ正規化は無効にします。
それぞれの内部動作を確認したい場合は、以下を展開してください。
【詳細】TimesFM-3のパディングとpadding_mode
公開中のgoogle/timesfm-3.0-pytorchは入力パッチ長32を基本単位としますが、context長を利用者が32の倍数へ加工する必要はありません。
predict_batchへ異なるcontext長の配列を渡すと、同じバッチ内の最大長を32の倍数へ切り上げ、短い系列を左側からゼロで埋めたうえでマスクします。
この公開実装の最大contextは15,360時点で、それより長い場合は古い側が切り捨てられます。
720時間は32で割り切れないため、内部では736時点分の領域へ左パディングされますが、利用者がゼロを追加する必要はありません。
なお、padding_mode="none" | "edge"は、このcontext用パディングを切り替える引数ではありません。
予測horizonを出力パッチ長64へ内部で切り上げた際、past-future covariateの未来側を末尾値で右パディングするかを指定する引数です。
今回のhorizon 24では、padding_mode="edge"なら不足する40時点が末尾値で補われ、既定の"none"なら補われません。
【詳細】use_znormの対象と手動標準化との違い
TimesFM-3はモデル内部でも系列ごとの正規化を行うため、気温・電力・sin/cosを同じ尺度へ手作業でそろえることは、API利用上の必須条件ではありません。
これとは別に、公開APIには推論前の追加処理としてuse_znormがあります。
既定値はFalseです。
Trueにすると、target、past-only covariate、past-future covariateの各行が、それぞれの平均と標準偏差でZ正規化されます。
targetの予測だけは、推論後に元の尺度へ戻されます。
past-future covariateの平均・標準偏差は、入力として渡したcontextとhorizonを合わせた全区間から計算されます。未来側も予測時点で既知の値ですが、foldごとに週末の比率などが変われば変換結果も変わります。
重要なのは、use_znormに「気温だけ正規化し、is_weekendは正規化しない」といった特徴別の指定がないことです。
0/1フラグをZ正規化しても2値性そのものが消えるわけではなく、sin/cosもアフィン変換だけで周期情報が直ちに失われるわけではありません。
ただし、値の中心・振幅・2つの状態間の距離は変わります。
特に、短い窓で週末の割合が異なる場合や、sin/cosが整数周期を含まない場合は、窓ごとに変換結果が変化します。
そのため、数値特徴とバイナリ・周期特徴が混在する今回の構成では、次を透明性の高い初期設定とします。
use_znorm=Falseを基準にする- 追加のスケーリングが必要なら、気温など対象列だけを自前で変換する
is_weekendとsin/cosは意図した表現のまま入力するuse_znorm=Trueは別条件としてバックテストし、結果で採否を決める
# 特徴ごとの前処理を自分で制御する場合の考え方
scaled_past_weather = past_weather.copy()

# 例: 統計量はcontext内の各気象系列だけから計算する
weather_mean = scaled_past_weather.mean(axis=1, keepdims=True)
weather_std = scaled_past_weather.std(axis=1, keepdims=True)
weather_std = np.where(weather_std < 1e-7, 1.0, weather_std)
scaled_past_weather = (scaled_past_weather - weather_mean) / weather_std

output = forecaster.predict(
    context=targets,
    horizon=HORIZON,
    past_only_covariates=scaled_past_weather,
    past_future_covariates=known_calendar,  # 0/1・sin/cosはそのまま
    use_znorm=False,  # API側で全系列を再度Z正規化しない
    padding_mode="none",
)
上のコードは「必ず手動標準化すべき」という意味ではありません。
TimesFM-3内部にも正規化があるため、手動変換なしの条件と同じfoldで比較します。
自前で標準化する場合は、未来のtarget実績から統計量を計算しないこと、定数に近い系列でゼロ除算を起こさないこと、バックテストと本番で同じ規則を使うことが必要です。
TimesFM-3の入力配列作成のまとめ
Tetouan Cityデータから、TimesFM-3へ渡す3種類の入力配列を作成しました。
- target:
(3, 720) - past-only covariate:
(5, 720) - past-future covariate:
(5, 744)
predict_batchでは3地域を独立した予測として処理し、predictでは3地域を1件の多変量問題として共同予測しました。
次の検証編では、ここで作成した配列を使い、入力条件による予測精度の違いを比較します。
参考文献
- TimesFM-3: A zero-shot foundation model for multivariate forecasting(Google Research)
- TimesFM GitHubリポジトリ(インストール、版別仕様、ライセンス)
- TimesFM-3 PyTorch Forecasterの実装(API shape、内部配列化)
- google/timesfm-3.0-pytorch(Hugging Face)
データセット