

機械学習– tag –
-
 データ分析 ナレッジ
BERTテキスト分類 ― 英語の映画レビューを「肯定・否定」に分けてみる
1.はじめに 「このメールは迷惑メールか」「このレビューは褒めているか、けなしているか」「このニュースはスポーツか、経済... -
 データ分析 ナレッジ
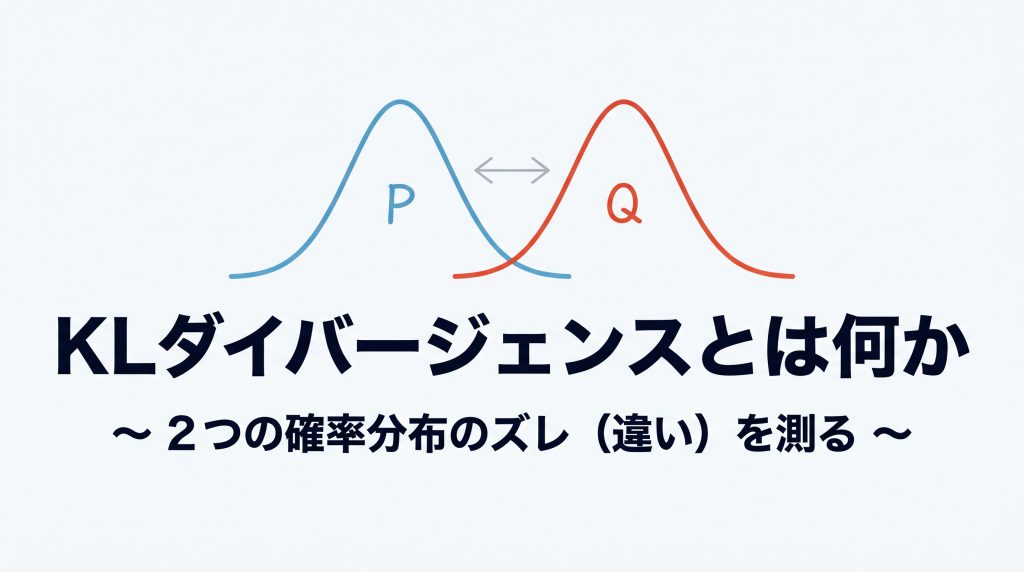
KLダイバージェンスとは何か: コイン投げで確かめる「分布のずれ」
公平なコイン PP(表の確率 0.5)と、表が出やすいコイン QQ(表の確率 0.8)を考える。QQ が本物のコインだと信じたまま、実... -
 ナレッジ
Prediction-Powered Inference(PPI):AIの予測を、統計的に正しく使う方法
1. 概要 Prediction-Powered Inference(PPI) は、機械学習モデルやLLMの予測を大量に使いつつ、少量の正解データでそ... -
 ナレッジ
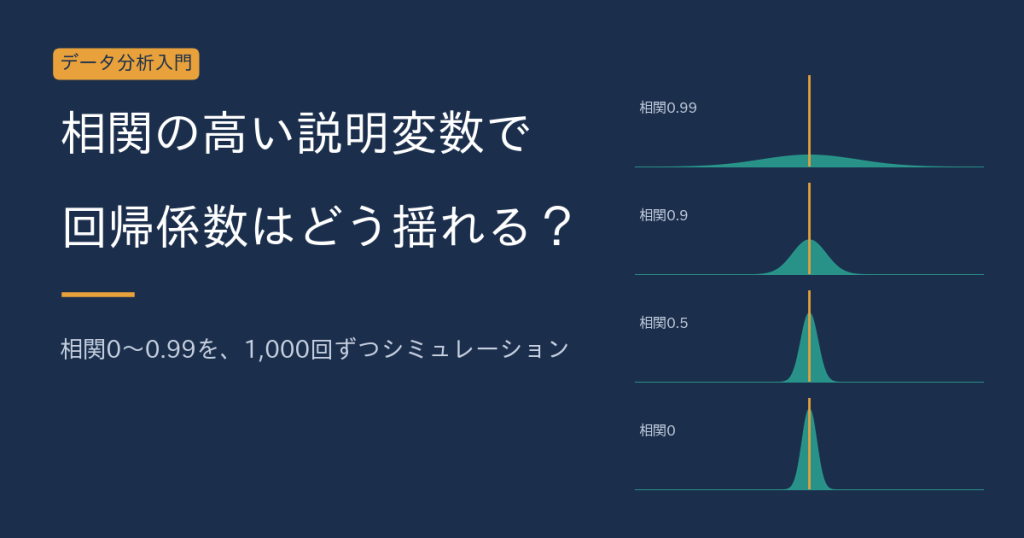
多重共線性とは回帰係数の解釈が壊れる理由について解説
はじめに 重回帰分析で、相関の高い説明変数を一緒に入れたことはありませんか。係数の符号が想定と逆になったり、重要そうな... -
 データ分析 ナレッジ
LightGBM・XGBoostのパラメータを徹底解説 ― 数値を変えるとどうなる?
はじめに LightGBM や XGBoost でモデルを作るとき、learning_rate や num_leaves などのパラメータを「よく使われる値」のま... -
 データ分析
LightGBM・XGBoost・CatBoostをオープンデータで比較してみた
はじめに テーブルデータの予測では、XGBoost・LightGBM・CatBoost の3つが定番です。それぞれ「LightGBM は速い」「CatBoost... -
 データ分析
負例のデータがなくても分類器は作れる?──Positive-confidence分類
イントロダクション 購入の予測モデルを作りたいとします。自社の顧客のデータ(購入した人)は簡単に集められます。しかし、... -
 データ分析 ナレッジ
精度が良すぎるとき、テストの情報はどこから混ざったのか:データリークの整理
はじめに 検証で、予想よりずっと高い精度が出た。うれしい反面、少し不安になる。そんな経験はないでしょうか。精度が良すぎ... -
データ分析
不均衡データの少数派を「合成」で増やす──SMOTEとは
イントロダクション 解約予測のモデルを作って、正解率を測ったら95%でした。優秀なモデルでしょうか? 実は、顧客1,000人の... -
 ナレッジ
正解ラベルがまちがっていると、モデルはどこまで耐えられるか
はじめに 目的と背景 機械学習では「正解ラベルは正しい」という前提でモデルを学習します。しかし実際のデータでは、この前...