

分析– tag –
-
 データ分析 ナレッジ
BERTテキスト分類 ― 英語の映画レビューを「肯定・否定」に分けてみる
1.はじめに 「このメールは迷惑メールか」「このレビューは褒めているか、けなしているか」「このニュースはスポーツか、経済... -
 ナレッジ
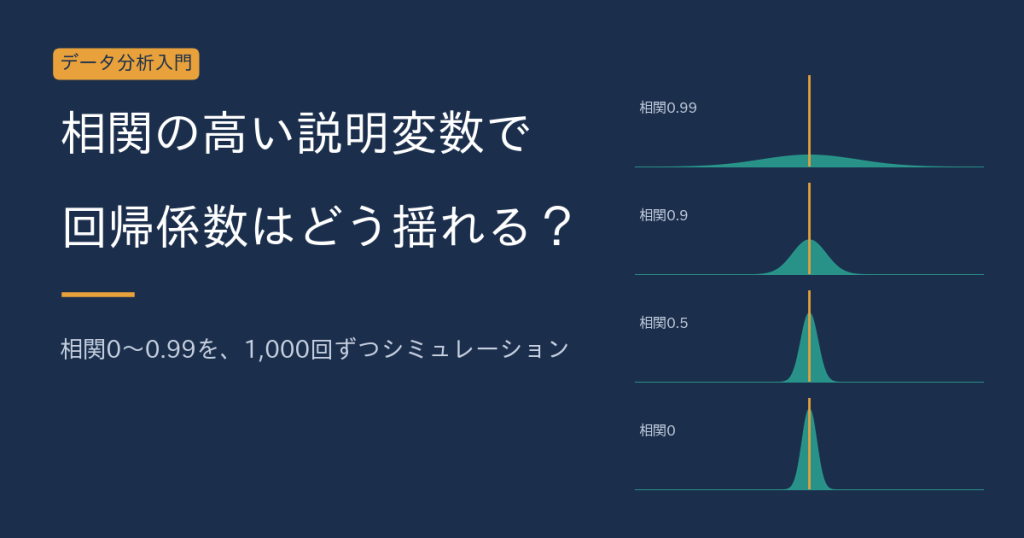
多重共線性とは回帰係数の解釈が壊れる理由について解説
はじめに 重回帰分析で、相関の高い説明変数を一緒に入れたことはありませんか。係数の符号が想定と逆になったり、重要そうな... -
 データ分析 ナレッジ
LightGBM・XGBoostのパラメータを徹底解説 ― 数値を変えるとどうなる?
はじめに LightGBM や XGBoost でモデルを作るとき、learning_rate や num_leaves などのパラメータを「よく使われる値」のま... -
 データ分析
LightGBM・XGBoost・CatBoostをオープンデータで比較してみた
はじめに テーブルデータの予測では、XGBoost・LightGBM・CatBoost の3つが定番です。それぞれ「LightGBM は速い」「CatBoost... -
 データ分析 ナレッジ
「何が原因か」を探すのかと「どれだけ効くか」を測るのか──因果探索と因果推論の違い
イントロダクション クーポンをもらった顧客は、購入額が多い。ここから、2種類の問いが生まれます。 問い①: クーポンは購入... -
 データ分析
偶然に近い「境目」を使う因果推論──回帰不連続デザイン(RDD)
イントロダクション ゴールド会員になった顧客は翌月の購入額が多い。これは、会員特典の効果でしょうか? そうとは限りませ... -
 データ分析 ナレッジ
精度が良すぎるとき、テストの情報はどこから混ざったのか:データリークの整理
はじめに 検証で、予想よりずっと高い精度が出た。うれしい反面、少し不安になる。そんな経験はないでしょうか。精度が良すぎ... -
 ナレッジ
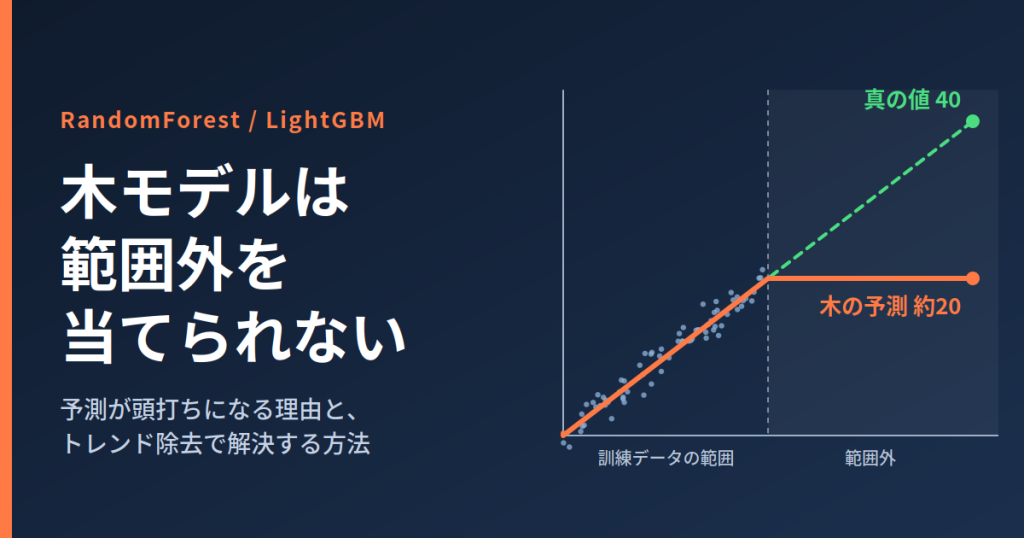
木モデルは外挿できない:RandomForestとLightGBMは、みたことのない範囲で頭打ちになる
はじめに RandomForestやLightGBMは、表形式のデータの予測で強力です。では、訓練データより大きい値を予測させると、どうな... -
 ナレッジ
特徴量重要度は信用していいのか:RandomForestは、無関係なランダム列を「最重要」と答える
はじめに RandomForestには、feature_importances_という、特徴量の重要度を返す機能があります。「どの列が予測に効いている... -
ナレッジ
薬を飲んだら血圧が下がった。それでも『効いた』と言えない理由
はじめに 血圧が高い人を集めて、ある薬を二週間飲んでもらったところ、平均血圧が下がっていました。この薬は効いたといえる...