はじめに
検証で、予想よりずっと高い精度が出た。うれしい反面、少し不安になる。そんな経験はないでしょうか。精度が良すぎるときは、まずデータリークを疑います。
ただ、リークには名前が多く、一覧にして並べても、「結局どこを確かめればいいのか」が分かりにくくなります。この記事では、リークをどこから混ざるかで4つに分け、7つの型として整理します。最後に、疑う順番の目安も示します。
データリークとは
データリークとは、学習の時に、本番の予測時には手に入らない情報が混ざることです。
混ざり方は、大きく2つあります。1つは、特徴量の中に、答えそのものや、答えの手がかりが入っている場合です。もう1つは、テストデータの情報が、学習の過程に影響している場合です。どちらも、検証では高い精度が出ますが、本番では出ません。
4つの入口と7つの型
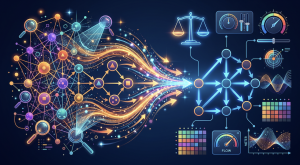
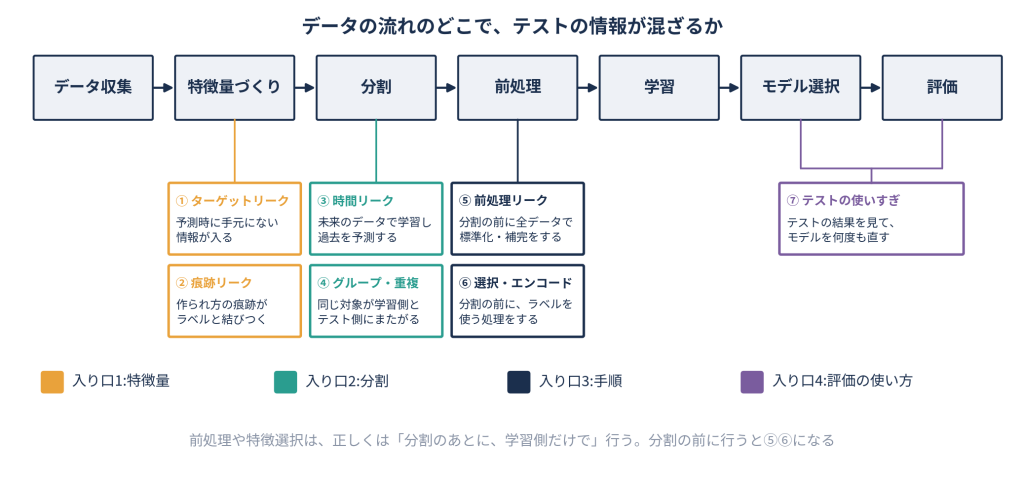
リークは、データが流れる順に見ると、どこで起きるかが分かります。下の図は、その流れと、混ざる型の位置です。
| 入り口 | 型 | 一言でいうと |
| 特徴量 | ターゲットリーク | 予測時に手元にない情報が入る |
| 特徴量 | 痕跡リーク | データの作られ方と痕跡が、ラベルと結びつく |
| 分割 | 時間リーク | 未来のデータで学習し、過去を予測する |
| 分割 | グループ・重複リーク | 同じ対象が、学習側とテスト側にまたがる |
| 手順 | 前処理リーク | 分割の前に、ラベルを使う処理をする |
| 手順 | 特徴量選択・エンコーディングのリーク | 分割の前に、ラベルを使う処理をする |
| 評価の使い方 | テストの使いすぎ | テストの結果を見て、モデルを何度もなおす |
ターゲットリーク
予測する時点ではわからないはずの情報が、特徴量に入っています。解約の予測に「解約手続き済み」のフラグを使う、貸し倒れの予測に「催促の回数」を使うなどです。結果が起きた後に記録される情報には要注意です。
- 見つけ方:特徴量を1つずつ、「予測する時点で手元にあるか」で確かめます。1つの特徴量だけで、異様に高い精度が出ないかも見ます
- 防ぎ方:特徴量ごとに、いつ取得される情報かを一覧にしておきます
痕跡リーク
ラベルとは関係のない、データの「作られ方」の痕跡が、ラベルと結びついています。IDの採番順、ファイル名、撮影した機器、測定した根拠などです。例えばある機器で撮った画像は不良品が多く、別の機器で撮った画像は良品が多いと、モデルは中身ではなく、機器の違いを覚えます。
- 見つけ方:重要度の高い特徴量の意味を、説明できるか確かめます。ID、日時、拠点などの列を外して、精度がどれだけ変わるかを見ます。画像なら、ラベルと関係のない部分だけで予測できないかを見ます
- 防ぎ方:作られ方の違いが、ラベルと偏っていないかを、データを集める段階で確かめます
時間リーク
時間の順序があるデータを、ランダムに分割すると、未来のデータで学習して、過去のデータを予測することになります。売り上げの予測で、予測日より後のデータを使った集計(その月の平均など)を、特徴量にしてしまう場合も同じです。
- 見つけ方:学習を過去、テストを未来にして、時間順に分割します。ランダム分割と精度を比べて、差が大きければ疑います。集計時間が、予測時点までになっているかも確かめます
- 防ぎ方:時間のあるデータは、時間順に分けます(scilit-learnのTimeSeriesSplitなど)
重複リーク
同じ顧客の複数の行、同じ画像の切り抜きや回転版、重複した行が、学習側とテスト側の両方に入っています。モデルは、新しい対象に当てはめているのではなく、見たことのある対象を思い出しているだけです。
- 見つけ方:重複した行を数えます。グループ単位で分割し直して、精度が下がるかを見ます
- 防ぎ方:顧客やユーザーなどのグループ単位で分割します(GroupKFoldなど)。データの拡張は、分割の後に行います
前処理リーク
分割の前に、全データを使って、標準化、欠損値の補完、次元削減、オーバーサンプリングなどを行うと、テストデータの情報(平均や分布)が、学習側に入ります。分割の前にオーバーサンプリングをすると、同じ元データの複製が、学習側とテスト側の両方に入ることもあります。
- 見つけ方:分割の前に、データ全体を使って学習(fit)する処理がないか、コードを確かめます
- 防ぎ方:前処理は、分割のあとに、学習側だけで学習して、テスト側には変換だけを当てます。パイプラインにまとめると、順序を間違えにくくなります
エンコーディングのリーク
ラベルを使う処理を、分割の前に行う型です。全データでラベルと相関が高い特徴量を選ぶ、カテゴリをラベルの平均値で置き換える(ターゲットエンコーディング)、などがあたります。ラベルそのものを使うので、前処理リークより影響が大きくなりやすいと考えられます。特に、特徴量が多くて、サンプルが少ないときは注意が必要です。
- 見つけ方:特徴量選択やエンコーディングが、分割の内側で行われているか、コードを確かめます
- 防ぎ方:前処理リークと同じく、パイプラインの中に入れて、学習側だけで行います
テストの使いすぎ
テストの結果を見ながら、モデルやパラメータを何度も直す型です。1回の変更は小さくても、繰り返すほど、モデルはテストに合わせ込まれます。広い意味でリークとして扱います。
- 見つけ方:テストの結果を何回見たか数えます
- 防ぎ方:調整に使う検証用のデータと、最終評価に使うテストデータを分けます。テストは、最後に1回だけ使います
疑う順番
精度が良すぎる、または本番で大きく落ちたときは、次の順番で確かめます。下の図は、その流れです。
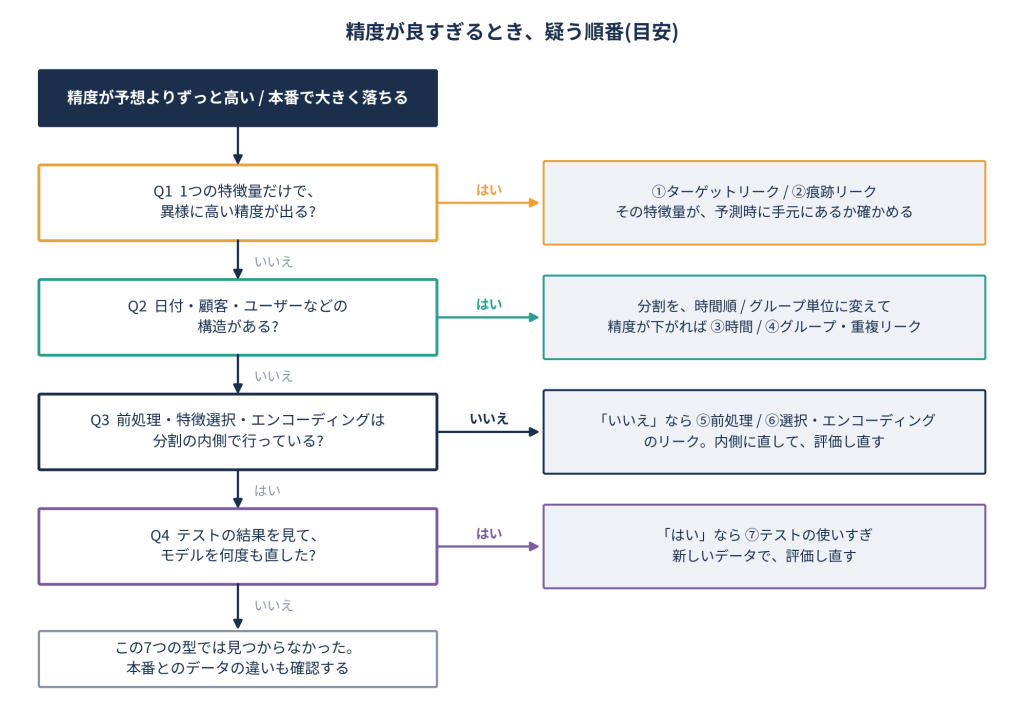
- 特徴量:1つの特徴料だけで、異様に高い精度が出ないか。データを見るだけで確かめられるためです
- 分割:日付けや顧客などの構造があるなら、分割を時間順やグループ単位に変えて精度が下がるか
- 手順:前処理、特徴量選択、エンコーディングが分割の内側にあるか
- 評価の使い方:テストを見て、モデルを何度も直していないか
この順番は目安です。コードをすぐ読める状態なら、3から確かめても構いません。
まとめ
- リークは、特徴量、分割、手順、評価の使い方の4つの入り口から混ざる
- 型の名前を覚えるより、「データの流れのどこで、テストの情報が混ざりうるか」を考える方が見つけやすい
- 前処理や、ラベルを使う処理は、分割の後に、学習側だけで行う
- 精度が良すぎるときは、まず特徴量を疑い、次に分割、手順、評価の使い方の順に確かめる
補足
- この記事の型の名前は、この記事での呼び方です。文献や現場では、呼び方が違うことがあります
- 7つの型は、すべてのリークを網羅したものではありません
- リークが精度にどれだけ影響するかは、データやモデルによって変わります。