1.はじめに
「このメールは迷惑メールか」「このレビューは褒めているか、けなしているか」「このニュースはスポーツか、経済か」。こうした文章をいくつかのグループに振り分ける作業を テキスト分類 と呼びます。これは、身の回りの多くのサービスで使われている技術です。
この記事では、自然言語処理の定番モデル BERT を使い、英語の映画レビューを「肯定(POSITIVE)」と「否定(NEGATIVE)」に分けるところまで、実際に手を動かしながら体験します。
この記事のゴールは次の3つです。
- BERTが何をしているのか、ざっくり説明できるようになる
- 公開データを使って、BERTを分類用に学習させる(ファインチューニング)
- 自分で書いた英文を入力し、肯定か否定かを予測させる
GPUのないパソコンでも動く よう、計算量を抑えています。会社のパソコンでも安心して試せるよう、安全な進め方もあわせて紹介します。
2. BERTとは?
従来の手法との違い
BERTが登場する前は、文章中の単語の出現回数を数えて分類する方法がよく使われていました。「great」が多ければ肯定、「boring」が多ければ否定、という考え方です。
この方法は単純でわかりやすい一方で、文脈を読み取れないという弱点があります。
- 「This movie is not good.」には「good」が含まれますが、意味は否定です
- 「bank」は「銀行」とも「川の土手」とも読めます
BERT(Bidirectional Encoder Representations from Transformers)は、2018年にGoogleが発表したモデルです。文の 前後の両方向 を同時に見ながら、各単語の意味を文脈に合わせてとらえます。そのため「not good」のような言い回しも正しく扱えます。
「事前学習」と「ファインチューニング」
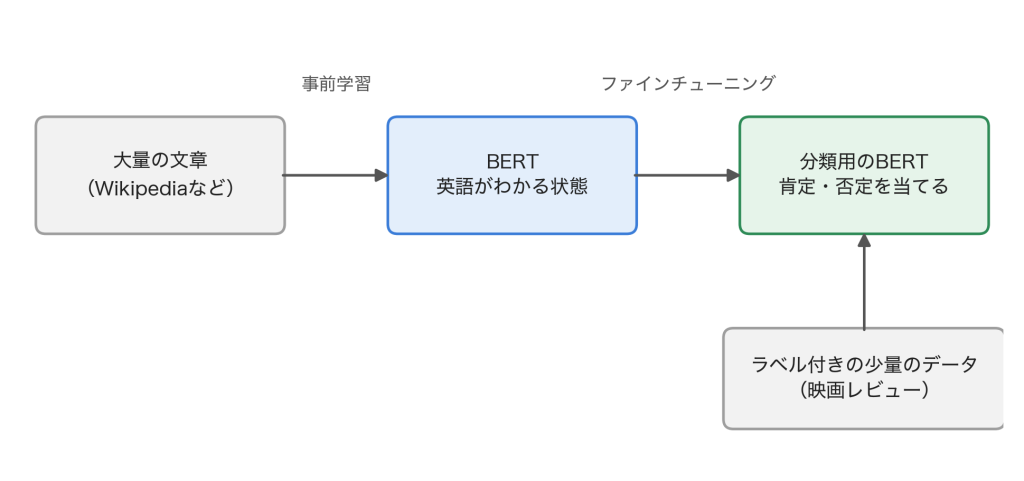
- 事前学習:Wikipediaなどの大量の文章を読み、「英語とはこういうものだ」という一般的な知識を身につけます。この工程はGoogleなどがすでに済ませて公開しているため、私たちが行う必要はありません。
- ファインチューニング:事前学習済みのBERTに、目的に合った少量のデータ(今回は映画レビューとその正解ラベル)で追加の学習を行います。
たとえるなら、幅広く基礎を学んだ人が、就職後に専門の練習問題を少し解くだけで仕事をこなせるようになるイメージです。土台となる知識があるため、少ないデータでも高い精度が得られます。
分類に使うのは[CLS]
BERTに文章を入れるとき、先頭に [CLS] という特別な記号をつけます。BERTの中で文全体を読み終えると、この [CLS] の位置の出力が 文全体の要約 のような役割を持ちます。
この要約の上に小さな「分類用の層」を1枚のせて、「肯定である確率」と「否定である確率」を出させます。これがBERTでテキスト分類をする仕組みです。
今回使うのは「DistilBERT」
本家のBERTは大きく、GPUがないパソコンでは学習に時間がかかります。そこで今回は、BERTを小さく作り直した DistilBERT を使います。
- 大きさは約40%小さく、処理は約60%速い
- 性能は元のBERTの約97%を保つ
使い方は本家のBERTとまったく同じです。記事の最後に、本家のBERTに替える方法も紹介します。
3. 分類の流れ(全体像)
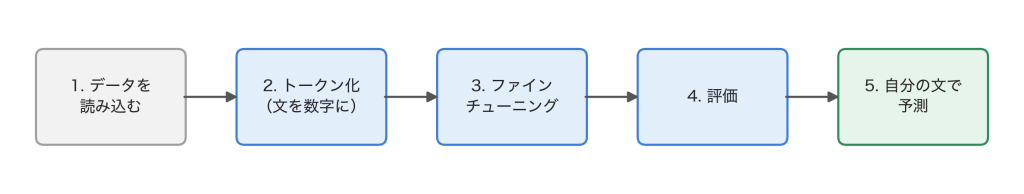
4. 準備
安全に進めるための決まり
この記事では次の決まりを守ります。
| 決まり | 理由 |
|---|---|
| 仮想環境(venv)を作って、その中にだけライブラリを入れる | パソコン全体の環境を汚さず、終わったらフォルダごと消せる |
| ライブラリは公式の配布元(PyPI)から、バージョンを固定して入れる | 似た名前の偽物や、思わぬ更新を避ける |
| モデルとデータは、Hugging Face の公式のものだけを使う | 出どころのはっきりしたものだけを使う |
trust_remote_code=True は使わない | 外部のコードを実行してしまう設定のため |
| ログインやアクセストークンは使わない | 公開モデルと公開データなので不要 |
作業フォルダと仮想環境を作る
mkdir -p ~/bert-blog && cd ~/bert-blog
python3 -m venv .venv
source .venv/bin/activate
行の先頭に (.venv) と出れば、仮想環境に入れています。
ライブラリを入れる
pip install --upgrade pip
pip install "torch==2.5.1" "transformers==4.46.3" "datasets==3.1.0" "accelerate==1.1.1" "scikit-learn==1.5.2"
| ライブラリ | 役割 |
|---|---|
torch | 深層学習の計算をする土台(PyTorch) |
transformers | BERTなどのモデルを簡単に使えるようにするライブラリ |
datasets | 公開データを読み込むライブラリ |
accelerate | 学習を動かす Trainer が内部で使う |
scikit-learn | 正解率などの評価指標を計算する |
GPU(MPS)が使えるか確かめる
Apple シリコン(M1〜M4など)の Mac では、PyTorch の MPS という仕組みで、Mac に内蔵されたGPUを使えます。
python -c "import torch; print('MPS:', torch.backends.mps.is_available())"
MPS: True なら内蔵GPU、False ならCPUで計算します。どちらでもこの記事のコードはそのまま動きます。 学習を動かす Trainer が、使えるほうを自動で選びます。
5. データを見てみる
ここからのコードは、bert_imdb.py という1つのファイルに上から順に書いていきます(記事の最後に全文を載せています)。
使うデータは IMDb の映画レビューです。英語のレビュー5万件に「肯定(1)」か「否定(0)」のラベルがついています。
import os

# Hugging Face への利用状況の送信を止める(ライブラリを読み込む前に設定する)
os.environ["HF_HUB_DISABLE_TELEMETRY"] = "1"

from collections import Counter

import numpy as np
import torch
from datasets import load_dataset
from sklearn.metrics import accuracy_score, confusion_matrix, f1_score
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    DataCollatorWithPadding,
    Trainer,
    TrainingArguments,
    set_seed,
)

set_seed(42)  # 毎回同じ結果になるように乱数を固定する

MODEL_NAME = "distilbert/distilbert-base-uncased"
MAX_LENGTH = 128   # 1件あたりのトークン数の上限
N_TRAIN = 2000     # 学習に使う件数
N_TEST = 500       # 評価に使う件数

# データを読み込む
imdb = load_dataset("stanfordnlp/imdb")
print(imdb)
初回は、Hugging Face からデータ(合わせて約84MB)がダウンロードされます。2回目からは手元に保存されたものが使われます。
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 25000
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 25000
    })
    unsupervised: Dataset({
        features: ['text', 'label'],
        num_rows: 50000
    })
})
学習用(train)と評価用(test)が、それぞれ25,000件ずつあることがわかります。unsupervised はラベルのついていないレビューで、今回は使いません。
件数を減らす
- 25,000件すべてを使うと、CPUで計算するパソコンでは何時間もかかります。今回は 学習用2,000件、評価用500件 に絞ります。
IMDb のデータは ラベル順に並んでいる ので、先頭から取ると全部「否定」になってしまいます。必ずシャッフルしてから取り出します。
train_ds = imdb["train"].shuffle(seed=42).select(range(N_TRAIN))
test_ds = imdb["test"].shuffle(seed=42).select(range(N_TEST))

print("学習用のラベルの数:", Counter(train_ds["label"]))
print("評価用のラベルの数:", Counter(test_ds["label"]))
print("レビューの例:", train_ds[0]["text"][:300])
print("ラベル:", train_ds[0]["label"])
学習用のラベルの数: Counter({1: 1000, 0: 1000})
評価用のラベルの数: Counter({0: 254, 1: 246})
レビューの例: There is no relation at all between Fortier and Profiler …(以下略)
ラベル: 1
学習用はちょうど1,000件ずつ、評価用は254件と246件で、肯定と否定がほぼ半分ずつになっています。偏りがないので、このまま使えます。
6. トークン化(文を数字に変える)
BERTは文字をそのまま読めません。文を トークン(単語や、単語の切れ端)に分けて、それぞれを番号に変える必要があります。この作業を トークン化 と呼び、モデルとセットで公開されている トークナイザー が行います。
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

sample = tokenizer("This movie is not good.")
print(sample)
print(tokenizer.convert_ids_to_tokens(sample["input_ids"]))
{'input_ids': [101, 2023, 3185, 2003, 2025, 2204, 1012, 102], 'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1]}
['[CLS]', 'this', 'movie', 'is', 'not', 'good', '.', '[SEP]']
出力の意味は次のとおりです。
input_ids:トークンの番号の並び。先頭に[CLS](番号101)、最後に[SEP](番号102)が自動で入ります。「This」が小文字の「this」になっているのは、今回のモデルが大文字と小文字を区別しない(uncased)ためですattention_mask:「ここは本物のトークン(1)」「ここは長さをそろえるための詰め物(0)」の目印
長い文と短い文の扱い
レビューの長さはばらばらで、中には数千語の長いものもあります。そこで次の2つの処理をします。
- 切り捨て(truncation):上限(今回は128トークン)を超えた部分を切り捨てます。BERT自体の上限は512トークンですが、短くするほど計算が速くなります
- 詰め物(padding):まとめて計算するときに、短い文の後ろを詰め物で埋めて長さをそろえます。これは学習のときに
DataCollatorWithPaddingが自動でやってくれます
def tokenize(batch):
    return tokenizer(batch["text"], truncation=True, max_length=MAX_LENGTH)

train_tok = train_ds.map(tokenize, batched=True, remove_columns=["text"])
test_tok = test_ds.map(tokenize, batched=True, remove_columns=["text"])
data_collator = DataCollatorWithPadding(tokenizer=tokenizer)
128トークンで切り捨てると、レビューの後半は読まれません。それでも冒頭だけで肯定・否定がわかるレビューが多いので、十分な精度が出ます。
7. ファインチューニング
7-1. モデルを読み込む
id2label = {0: "NEGATIVE", 1: "POSITIVE"}
label2id = {"NEGATIVE": 0, "POSITIVE": 1}

model = AutoModelForSequenceClassification.from_pretrained(
    MODEL_NAME,
    num_labels=2,
    id2label=id2label,
    label2id=label2id,
    use_safetensors=True,  # 安全な保存形式のファイルだけを読み込む
)
初回は、モデル本体(約268MB)がダウンロードされます。
実行すると「一部の重みが初期化されていない(Some weights … newly initialized)」という警告が出ます。これは 2-3 で説明した「分類用の層」がまだ何も学んでいない、という意味なので問題ありません。これから学習させる部分です。
7-2. 評価のしかたを決める
def compute_metrics(eval_pred):
    logits, labels = eval_pred
    preds = np.argmax(logits, axis=-1)
    return {
        "accuracy": accuracy_score(labels, preds),
        "f1": f1_score(labels, preds),
    }
7-3. 学習の設定をして、動かす
args = TrainingArguments(
    output_dir="out",
    num_train_epochs=1,               # データ全体を何周学習するか
    per_device_train_batch_size=16,   # 一度にまとめて計算する件数
    per_device_eval_batch_size=32,
    learning_rate=5e-5,               # 1回の学習でどれだけ重みを動かすか
    weight_decay=0.01,                # 学習しすぎ(過学習)を抑える
    eval_strategy="epoch",            # 1周ごとに評価する
    save_strategy="no",               # 途中経過のモデルは保存しない
    logging_steps=20,                 # 20回ごとに損失を表示する
    report_to="none",                 # 外部の記録サービスに送らない
    seed=42,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=train_tok,
    eval_dataset=test_tok,
    data_collator=data_collator,
    compute_metrics=compute_metrics,
)

trainer.train()
設定のポイントは次のとおりです。
- エポック数(
num_train_epochs):2,000件を1周だけ学習させます。BERTの土台がしっかりしているので、1周でもかなり精度が出ます - バッチサイズ(
per_device_train_batch_size):16件ずつまとめて計算します。メモリが足りないときは8に下げます - 学習率(
learning_rate):ファインチューニングでは2e-5〜5e-5がよく使われます report_to="none":初期設定のままだと、入っている記録サービスに学習の経過を送ろうとすることがあるので、明示的に止めます
学習中は loss(損失。モデルの予測が正解からどれだけずれているか。小さいほどよい)が20回ごとに表示されます。
{'loss': 0.6839, 'grad_norm': 1.6404471397399902, 'learning_rate': 4.2e-05, 'epoch': 0.16}
{'loss': 0.5438, 'grad_norm': 6.623847007751465, 'learning_rate': 3.4000000000000007e-05, 'epoch': 0.32}
{'loss': 0.4542, 'grad_norm': 8.676435470581055, 'learning_rate': 2.6000000000000002e-05, 'epoch': 0.48}
{'loss': 0.4555, 'grad_norm': 6.553205966949463, 'learning_rate': 1.8e-05, 'epoch': 0.64}
{'loss': 0.4173, 'grad_norm': 2.6448168754577637, 'learning_rate': 1e-05, 'epoch': 0.8}
{'loss': 0.3684, 'grad_norm': 8.67974853515625, 'learning_rate': 2.0000000000000003e-06, 'epoch': 0.96}
{'train_runtime': 151.9394, 'train_samples_per_second': 13.163, 'train_steps_per_second': 0.823, 'train_loss': 0.4850738296508789, 'epoch': 1.0}
読み取れることは次のとおりです。
- loss が 0.68 から 0.37 まで下がっています。最初の0.68は、2択を当てずっぽうで答えたときとほぼ同じ値です。そこから学習が進み、だんだん正しく当てられるようになっていく様子がわかります
- 学習率(
learning_rate)が少しずつ小さくなっています。最初は大きく重みを動かし、終わりに近づくほど細かく調整する、というTrainerの初期設定の動きです - 学習にかかった時間は約2分32秒(
train_runtimeが151.9秒)でした。Apple シリコンの Mac の内蔵GPU(MPS)で、2,000件を16件ずつ125回に分けて学習しています
8. 評価
8-1. 正解率とF1スコア
metrics = trainer.evaluate()
print(metrics)
{'eval_loss': 0.3923969566822052, 'eval_accuracy': 0.796, 'eval_f1': 0.7829787234042553, 'eval_runtime': 5.3985, 'eval_samples_per_second': 92.619, 'eval_steps_per_second': 2.964, 'epoch': 1.0}
- 正解率(Accuracy):500件のうち、何割を正しく当てたか
- F1スコア:「肯定と予測したもののうち、本当に肯定だった割合(適合率)」と「本当の肯定のうち、肯定と当てられた割合(再現率)」のバランスを見る指標。1に近いほどよい
私の環境(Apple シリコンの Mac)では、正解率は79.6%、F1スコアは0.783 でした。500件のうち398件を正しく当てています。
当てずっぽうなら50%なので、学習データをたった2,000件、文の長さを128トークンに絞っても、しっかり学習できていることがわかります。精度を上げる方法は、記事の最後で紹介します。
8-2. 混同行列で、どこを間違えたか見る
pred = trainer.predict(test_tok)
pred_labels = np.argmax(pred.predictions, axis=-1)
cm = confusion_matrix(pred.label_ids, pred_labels)

print("                予測:NEGATIVE  予測:POSITIVE")
print(f"正解:NEGATIVE    {cm[0][0]:>10}  {cm[0][1]:>12}")
print(f"正解:POSITIVE    {cm[1][0]:>10}  {cm[1][1]:>12}")
                予測:NEGATIVE  予測:POSITIVE
正解:NEGATIVE           214            40
正解:POSITIVE            62           184
左上と右下が「正しく当てた件数」、右上と左下が「間違えた件数」です。
- 否定のレビュー254件のうち、214件(84%)を正しく否定と当てました
- 肯定のレビュー246件のうち、正しく肯定と当てたのは184件(75%)で、62件を否定と間違えました
このモデルは、肯定のレビューを否定と取り違えるほうが多い ことがわかります。映画レビューには「前半は退屈だったが、後半はすばらしい」のように、悪い点にふれてから褒める書き方がよくあります。今回は先頭の128トークンしか読んでいないので、褒めている後半が切り捨てられて否定と判定された可能性があります。
9. 自分の文章で試す
学習したモデルに、自分で書いた英文を入れてみましょう。
def predict(texts):
    model.eval()
    inputs = tokenizer(
        texts, truncation=True, max_length=MAX_LENGTH,
        padding=True, return_tensors="pt",
    ).to(model.device)
    with torch.no_grad():
        probs = model(**inputs).logits.softmax(dim=-1)
    for text, p in zip(texts, probs):
        label = id2label[int(p.argmax())]
        print(f"{label:8s} ({float(p.max()):.1%})  {text}")

predict([
    "This movie was absolutely wonderful. I loved every minute of it.",
    "The plot was boring and the acting was terrible.",
    "This movie is not good.",
    "I expected to hate it, but it turned out to be great.",
    "Oh great, another two hours of my life I will never get back.",
])
POSITIVE (93.3%)  This movie was absolutely wonderful. I loved every minute of it.
NEGATIVE (94.0%)  The plot was boring and the acting was terrible.
NEGATIVE (92.0%)  This movie is not good.
POSITIVE (81.7%)  I expected to hate it, but it turned out to be great.
POSITIVE (63.6%)  Oh great, another two hours of my life I will never get back.
かっこの中の数字は、モデルがその判定にどれだけ自信を持っているか(確率)です。
- 1つ目と2つ目のわかりやすい文は、どちらも90%以上の自信で正しく当てました
- 3つ目の「not good」は、「good」が入っていても 否定(92.0%) と正しく判定できました。単語を数えるだけの昔の方法では難しかった文です
- 4つ目の「嫌いだと思っていたけれど、よかった」という 逆転 の文も、肯定と当てました。ただ、自信は81.7%と少し下がっています
いちばん面白いのは5つ目です。「Oh great(いやあ、すばらしい)」と言いながら、「二度と戻らない2時間」と嘆いている 皮肉 の文です。人が読めば明らかに否定ですが、モデルは 肯定(63.6%) と間違えました。
ただし、自信は63.6%と低く、モデルも「迷っている」ことがわかります。言葉の表面と本当の意味が逆になる皮肉は、BERTでも苦手なことが多い文です。2,000件の学習データでは、ここまで読み取るのは難しかったようです。
10. つまずきやすいポイント
| 困りごと | 対処 |
|---|---|
| メモリ不足のエラーが出る | per_device_train_batch_size を8や4に下げる。MAX_LENGTH を64に下げる |
| 学習がとても遅い | N_TRAIN を1,000に減らす。筆者の環境(Apple シリコン、MPS)では学習は約2分半だったが、CPUだけで計算する場合はその何倍もかかることがある |
| MPS で動かすとエラーが出る | 実行前にターミナルで export PYTORCH_ENABLE_MPS_FALLBACK=1 を打つ(MPSが対応していない計算だけCPUで行う) |
| 正解率が50%前後のまま | データをシャッフルしたか確かめる(5. の「件数を減らす」) |
| 長いレビューの判定がずれる | 後半を切り捨てているため。MAX_LENGTH を256〜512に増やす(計算は遅くなる) |
11. まとめと次の一歩
この記事では、次のことをしました。
- BERTが 前後の文脈を読む モデルであること、事前学習+ファインチューニング の2段階で使うことを確認した
- 軽量版の DistilBERT を、IMDb の映画レビュー2,000件でファインチューニングした
- GPUを積んだ専用のマシンがなくても、手元の Mac で 学習約2分半、正解率79.6% の分類ができた
- 「not good」は正しく否定と判定できた一方で、皮肉 はまだ見抜けなかった
次の一歩としては、こんなことを試してみてください。
- 本家のBERTに替える:
MODEL_NAMEを"google-bert/bert-base-uncased"に変えるだけで動きます(計算は約1.6倍かかります) - 件数や長さを増やす:
N_TRAINを5,000件、MAX_LENGTHを256に増やすと、精度が上がる見込みです。特にMAX_LENGTHを増やすと、後半で褒めているレビューを読めるようになり、8-2 で見た「肯定を否定と取り違える」間違いが減るはずです(計算時間は長くなります) - 3つ以上に分ける:ニュースを4つのジャンル(世界・スポーツ・経済・科学技術)に分ける AG News など、多クラスの分類に挑戦する。
num_labelsとid2labelを変えるだけで、コードの形はほぼ同じです - 日本語で試す:日本語に対応したBERTも公開されています
参考
- Devlin et al. (2018) “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”
- Sanh et al. (2019) “DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter”
- Maas et al. (2011) “Learning Word Vectors for Sentiment Analysis”(IMDb データセット)
- Hugging Face Transformers の公式ドキュメント
付録:コード全文(bert_imdb.py)
"""BERT(DistilBERT)で IMDb の映画レビューを肯定・否定に分類する。

GPU のない Mac でも動くよう、件数と文の長さを絞っている。
使うのは公開モデル・公開データだけ。ログインやトークンは使わない。
"""
import os

# Hugging Face への利用状況の送信を止める(ライブラリを読み込む前に設定する)
os.environ["HF_HUB_DISABLE_TELEMETRY"] = "1"

from collections import Counter

import numpy as np
import torch
from datasets import load_dataset
from sklearn.metrics import accuracy_score, confusion_matrix, f1_score
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    DataCollatorWithPadding,
    Trainer,
    TrainingArguments,
    set_seed,
)

set_seed(42)  # 毎回同じ結果になるように乱数を固定する

MODEL_NAME = "distilbert/distilbert-base-uncased"
MAX_LENGTH = 128   # 1件あたりのトークン数の上限
N_TRAIN = 2000     # 学習に使う件数
N_TEST = 500       # 評価に使う件数

print("MPS:", torch.backends.mps.is_available())

# ---- 5. データを見てみる ----
imdb = load_dataset("stanfordnlp/imdb")
print(imdb)

# IMDb はラベル順に並んでいるので、シャッフルしてから取り出す
train_ds = imdb["train"].shuffle(seed=42).select(range(N_TRAIN))
test_ds = imdb["test"].shuffle(seed=42).select(range(N_TEST))

print("学習用のラベルの数:", Counter(train_ds["label"]))
print("評価用のラベルの数:", Counter(test_ds["label"]))
print("レビューの例:", train_ds[0]["text"][:300])
print("ラベル:", train_ds[0]["label"])

# ---- 6. トークン化 ----
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

sample = tokenizer("This movie is not good.")
print(sample)
print(tokenizer.convert_ids_to_tokens(sample["input_ids"]))

def tokenize(batch):
    return tokenizer(batch["text"], truncation=True, max_length=MAX_LENGTH)

train_tok = train_ds.map(tokenize, batched=True, remove_columns=["text"])
test_tok = test_ds.map(tokenize, batched=True, remove_columns=["text"])
data_collator = DataCollatorWithPadding(tokenizer=tokenizer)

# ---- 7. ファインチューニング ----
id2label = {0: "NEGATIVE", 1: "POSITIVE"}
label2id = {"NEGATIVE": 0, "POSITIVE": 1}

model = AutoModelForSequenceClassification.from_pretrained(
    MODEL_NAME,
    num_labels=2,
    id2label=id2label,
    label2id=label2id,
    use_safetensors=True,  # 安全な保存形式のファイルだけを読み込む
)

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    preds = np.argmax(logits, axis=-1)
    return {
        "accuracy": accuracy_score(labels, preds),
        "f1": f1_score(labels, preds),
    }

args = TrainingArguments(
    output_dir="out",
    num_train_epochs=1,               # データ全体を何周学習するか
    per_device_train_batch_size=16,   # 一度にまとめて計算する件数
    per_device_eval_batch_size=32,
    learning_rate=5e-5,               # 1回の学習でどれだけ重みを動かすか
    weight_decay=0.01,                # 学習しすぎ(過学習)を抑える
    eval_strategy="epoch",            # 1周ごとに評価する
    save_strategy="no",               # 途中経過のモデルは保存しない
    logging_steps=20,                 # 20回ごとに損失を表示する
    report_to="none",                 # 外部の記録サービスに送らない
    seed=42,
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=train_tok,
    eval_dataset=test_tok,
    data_collator=data_collator,
    compute_metrics=compute_metrics,
)

trainer.train()

# ---- 8. 評価 ----
metrics = trainer.evaluate()
print(metrics)

pred = trainer.predict(test_tok)
pred_labels = np.argmax(pred.predictions, axis=-1)
cm = confusion_matrix(pred.label_ids, pred_labels)

print("                予測:NEGATIVE  予測:POSITIVE")
print(f"正解:NEGATIVE    {cm[0][0]:>10}  {cm[0][1]:>12}")
print(f"正解:POSITIVE    {cm[1][0]:>10}  {cm[1][1]:>12}")

# ---- 9. 自分の文章で試す ----
def predict(texts):
    model.eval()
    inputs = tokenizer(
        texts, truncation=True, max_length=MAX_LENGTH,
        padding=True, return_tensors="pt",
    ).to(model.device)
    with torch.no_grad():
        probs = model(**inputs).logits.softmax(dim=-1)
    for text, p in zip(texts, probs):
        label = id2label[int(p.argmax())]
        print(f"{label:8s} ({float(p.max()):.1%})  {text}")

predict([
    "This movie was absolutely wonderful. I loved every minute of it.",
    "The plot was boring and the acting was terrible.",
    "This movie is not good.",
    "I expected to hate it, but it turned out to be great.",
    "Oh great, another two hours of my life I will never get back.",
])
ターミナルで次を打つと動きます。
python bert_imdb.py