はじめに
生成AIの話題といえば、ChatGPT のようなLLM(大規模言語モデル)が中心です。一方で、文章を種類ごとに分ける、決まった項目を抜き出す、といった作業では、今も BERT のような小さめのモデルが使われています。軽くて速く、手元のパソコンでも動かせるのが強みです。
BERT には、医療や金融など、特定の分野の文章で学習させた「分野特化」版があります。この記事では、日本語の分野特化BERTを比べたうえで、金融版を実際に動かし、汎用版(特定の分野に限らない、一般的な文章で学習した版)との違いを確かめます。
分野特化BERTとは
BERT は、大量の文章で「文の中で隠された言葉を当てる」練習を重ねて、言葉の使われ方を覚えたモデルです。今回使う汎用BERTは、日本語 Wikipedia の文章で学習しています。
分野特化BERTは、その分野の文章(論文、カルテ、決算書など)で学習したものです。作り方は大きく2通りあります。
- ゼロから学習する:分野の文章で最初から学習します。語彙(モデルが1つの単位として扱える言葉の一覧)も、その文章から作ります。
- 汎用BERTに追加で学習させる:できあがった汎用BERTに、分野の文章を追加で読ませます。語彙は汎用のままです。
どちらが良いかは場合によります。たとえば法律分野の研究では、判決書を使った穴埋めなどのタスクで、汎用BERTに追加で学習させたモデルの正解率がいちばん高かったと報告されています。
日本語の分野特化BERTを比べる
| 分野 | モデル | 作ったところ | 学習に使った文章 | 公開先 | ライセンス |
|---|---|---|---|---|---|
| 医療(論文) | JMedRoBERTa | 国立情報学研究所(NII)相澤研究室 | 科学技術振興機構(JST)が集めた医学論文の抄録・本文(約1,100万文) | Hugging Face | CC BY-NC-SA 4.0(非営利のみ) |
| 医療(カルテ) | UTH-BERT | 東京大学 | 東大病院の電子カルテの文章(約1億2,000万行) | 公式サイト | CC BY-NC-SA 4.0(非営利のみ) |
| 法律 | 法律分野のBERT | 東京工業大学(現・東京科学大学)の研究グループ | 民事事件の判決書 | 確認できず | - |
| 金融 | bert-small-japanese-fin など | 東京大学 和泉研究室 | Wikipedia(約2,000万文)+決算短信・有価証券報告書(約2,700万文) | Hugging Face | CC BY-SA 4.0(商用利用も可) |
- 決算短信と有価証券報告書は、上場企業が決算の内容を公表する資料です。
- 公開先の Hugging Face は、AIのモデルを公開・共有するサイトです。
- ライセンスの「CC BY-NC-SA 4.0」「CC BY-SA 4.0」は、クリエイティブ・コモンズという、作品の利用条件を示す決まった形式の名前です。
- 医療の2つは、ライセンスが「非営利のみ」です。会社の仕事で使う場合は注意が必要です。
- 金融のモデルは CC BY-SA 4.0 で、クレジット(作った人とライセンス)を書けば商用でも使えます。改変したものを配布するときは、同じライセンスにする必要があります。
- 法律分野は研究の報告はありますが、モデルが公開されているかは確認できませんでした。
- 金融には、ゼロから学習した small 版(小さめの構成)のほかに、東北大学の汎用BERTに追加で学習させた base 版(標準的な大きさの構成、
bert-base-japanese-fin-additional)もあります。 - JMedRoBERTa の RoBERTa は、BERT の学習方法を改良したモデルです。
金融BERTを使ってみた
比べた2つのモデル
| 汎用 | 金融 | |
|---|---|---|
| モデル | izumi-lab/bert-small-japanese | izumi-lab/bert-small-japanese-fin |
| 学習に使った文章 | 日本語 Wikipedia | 日本語 Wikipedia+決算短信・有価証券報告書 |
どちらも東京大学 和泉研究室が、同じ作り(BERT small という小さめの構成)・同じ設定で学習したモデルです。違うのは「金融の文章を読んだかどうか」だけなので、比べやすい組み合わせです。大きさは1つ約72MBで、ノートPCのCPUでもすぐに動きます。
動かし方はこれだけです。
pip install transformers torch fugashi ipadic
from transformers import pipeline

fill = pipeline("fill-mask", model="izumi-lab/bert-small-japanese-fin", device="cpu")
fill("のれんの[MASK]損失を計上しました。")
transformers と torch は BERT などのモデルを動かすためのライブラリ、fugashi と ipadic は日本語の文を単語に区切るための部品です。「fill-mask」は穴埋めのことです。
(実行環境:Python 3.13、transformers 5.22.1、PyTorch 2.15.0、Mac の CPU)
試したのは次の3つです。
- 金融の用語を、モデルがどこで区切って読むか(トークン分割)
- 決算書によくある文の一部を隠して、入る言葉を当てさせる(穴埋め)
- 長い文の名詞を1語ずつ自動で隠して、当てられた割合を比べる(正解率)
① 用語の区切り方
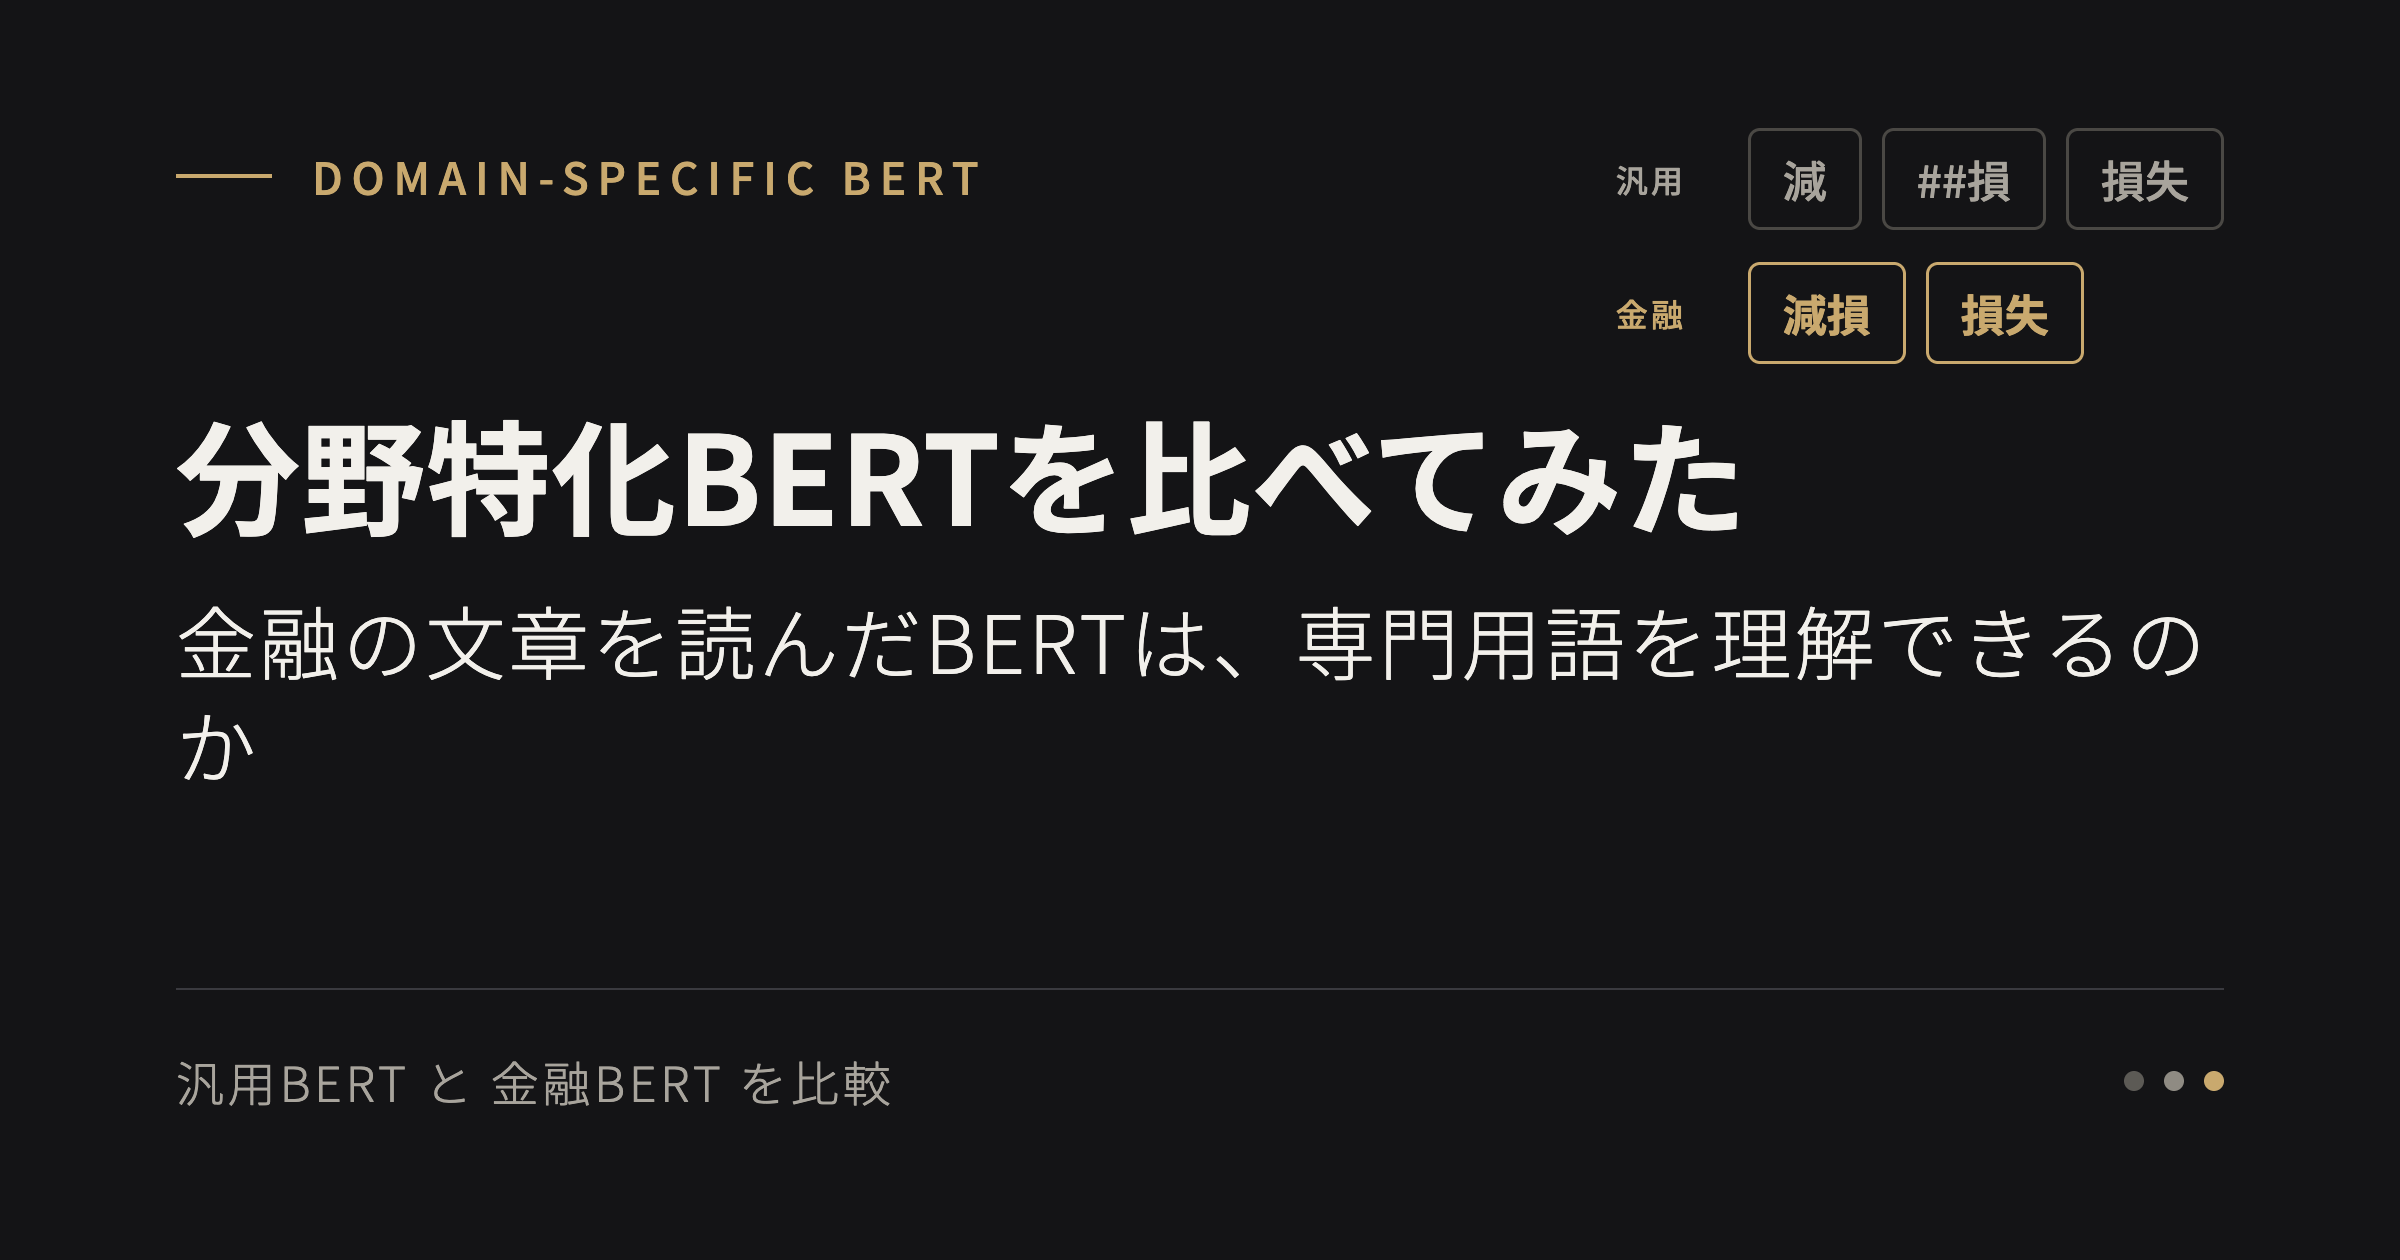
モデルは、文章を「トークン」という単位に区切って読みます。語彙(トークンの一覧)にない言葉は、知っている部品に分けて読みます。表の「##」は「前の部品にくっつく」という印で、「の / ##れん」は「の」と「れん」をつなげて「のれん」と読む、という意味です。汎用BERTの語彙には「のれん」がないので、2つに分けています。
見た目は同じ「のれん」でも、汎用BERTは1つ目の「の」を、「会社の利益」の「の」(助詞)と同じ部品として読み始めます。そこから後ろの「##れん」と前後の文を手がかりに、「のれん」という1つの言葉だと組み立て直す必要があります。「のれん」専用の部品を持つ金融BERTとは、ここが違います。
| 用語 | 汎用 | 金融 |
|---|---|---|
| のれん | の / ##れん | のれん |
| 減損損失 | 減 / ##損 / 損失 | 減損 / 損失 |
| 繰延税金資産 | 繰 / ##延 / 税金 / 資産 | 繰延 / 税金 / 資産 |
| 引当金 | 引 / ##当 / 金 | 引当 / 金 |
| 有価証券報告書 | 有 / ##価 / 証券 / 報告 / 書 | 有価 / 証券 / 報告 / 書 |
| 連結子会社 | 連結 / 子会社 | 連結 / 子会社 |
| 自己株式 | 自己 / 株式 | 自己 / 株式 |
表の用語は、どれも決算書によく出てくる会計用語です。たとえば「のれん」は企業を買収したときに生まれるブランド力などの目に見えない価値、「減損」は資産の価値が下がったときに帳簿上の金額を減らすことです。汎用BERTは、「のれん」のほか「減損」「繰延」「引当」なども部品に分けています。金融BERTは、決算書によく出てくるこうした言葉を1つのトークンとして持っています。
一方で、「連結子会社」「自己株式」のように Wikipedia にも出てくる言葉は、どちらも同じ区切り方でした。
② 穴埋め
文の一部を [MASK](隠した部分を表す記号)で隠して、入る言葉を予測させました。表には、確率の高い順に3つ載せています。( )内の%は、その言葉が [MASK] に入る確率としてモデルが出した値です。
| 文 | 汎用の予測(確率) | 金融の予測(確率) |
|---|---|---|
| のれんの[MASK]損失を計上しました。 | 大きな(15.7%)、累積(4.5%)、大(3.2%) | 減損(99.9%以上)、特別(0.1%未満)、減少(0.1%未満) |
| [MASK]キャッシュ・フローは、30億円の収入となりました。 | この(69.6%)、その(8.5%)、そして(1.6%) | 営業(35.1%)、各(31.1%)、フリー(25.1%) |
| 純[MASK]は、前期末に比べて3億円増加しました。 | 利益(25.9%)、##度(11.2%)、##銀(10.7%) | 利益(87.5%)、資産(6.2%)、損益(1.8%) |
| 当社は、自己[MASK]の取得を決議しました。 | 株式(29.7%)、資本(8.1%)、証明(8.0%) | 株式(99.9%以上)、株(0.1%未満)、株券(0.1%未満) |
| 売上高は、前年同期比5.2%[MASK]の120億円となりました。 | 増(77.0%)、減(17.7%)、上回る(0.4%) | 増(48.2%)、減(39.4%)、増収(3.5%) |
| 週末は家族と[MASK]に行きました。(金融と関係ない文) | 一緒(35.6%)、会い(8.0%)、ニューヨーク(1.9%) | 一緒(53.2%)、会い(8.4%)、旅(1.8%) |
- のれんの[MASK]損失:金融BERTは99.9%以上の確率で「減損」と答えました。汎用BERTの答えは「大きな」「累積」で、決算書らしい答えではありません。①で見たとおり、汎用BERTは「減損」を1つのトークンとして持っていないので、1つの[MASK]に「減損」を入れることがそもそもできません。語彙の違いが、そのまま答えの違いになっています。
- [MASK]キャッシュ・フロー(キャッシュ・フロー=会社のお金の出入り):汎用BERTは「この」「その」と答えました。金融BERTは「営業」「各」「フリー」と、決算書でよく見る言い方を出しています。
- 純[MASK]:どちらも1位は「利益」で、確率は25.9%と87.5%でした。ただ、「前期末に比べて」は純資産(資産から負債を引いた残り)のような期末の残高によく使う言い方なので、この文には「資産」のほうが合います。金融BERTでも「資産」は2位(6.2%)でした。汎用BERTの2位・3位は「##度」「##銀」(「純度」「純銀」)でした。
- 自己[MASK](自己株式=会社が買い戻した自社の株):どちらも1位は「株式」ですが、確率は29.7%と99.9%以上で大きく違います。
- 前年同期比5.2%[MASK]:どちらも「増」「減」が上位で、大きな差はありませんでした。
- 週末は家族と[MASK]に行きました:どちらも「一緒」が1位でした。金融BERTは Wikipedia も学習しているので、この例では金融と関係ない文も問題なく扱えていました。
③ 長い文で、名詞を1語ずつ隠す
②は隠す場所を人が選んでいるので、差が出やすい例ばかりを選んでしまうおそれがあります。そこで、名詞を自動で1語ずつ隠す方法でも比べました。
- 使った文は、財務省「令和6年度 国の財務書類」(国の決算書にあたる資料)の注記(数字の説明書き)から取った10文(決算書の文)と、気象庁の天候の資料から取った3文(一般の文)です(出典は記事の最後に載せています)。どちらも2026年に公表された資料なので、2つのモデルの学習には入っていません。
- 文を形態素解析(文を単語に区切る処理。今回は MeCab という道具を使いました)で語に分け、名詞を1語ずつ [MASK] にして当てさせました。数字、「円」「率」のような接尾語、代名詞、「こと」「ため」のような形式的な名詞は隠していません。
- 1語が複数のトークンに分かれる場合(汎用BERTの「原価」→「原 / ##価」など)は、そのトークンをすべて [MASK] にして、すべて当たったときだけ正解としました。
例(決算書の文。太字は隠した名詞):未収金、貸付金等のうち一般債権については、過去3年間の貸倒実績率に基づく回収不能見込額を計上している。
正解率は、隠した名詞のうち、モデルが元の語を当てられた割合です。
| 文の種類 | 対象の名詞 | 汎用の正解率 | 金融の正解率 |
|---|---|---|---|
| 決算書の文 | すべて | 22.8%(123語中28語) | 65.9%(123語中81語) |
| 決算書の文 | どちらのモデルでも1トークンの語 | 26.4%(91語中24語) | 67.0%(91語中61語) |
| 決算書の文 | 汎用だけ複数のトークンに分かれる語 | 12.9%(31語中4語) | 64.5%(31語中20語) |
| 一般の文 | すべて | 46.4%(28語中13語) | 42.9%(28語中12語) |
- 決算書の文では、正解率が汎用BERT 22.8%、金融BERT 65.9% と大きく違いました。ただし、汎用BERTだけが当てた語も7語ありました。
- 汎用BERTだけ複数のトークンに分かれる語(「原価」「借入金」「利息」など31語)は、汎用BERTが4語、金融BERTが20語を当てました。
- 金融BERTが外した語の中には、「国債」を「当社」、「ソフトウェア」を「のれん」と答えるなど、会社の決算書で使う言葉で答えたものがありました。国の財務書類は、金融BERTが学習した会社の決算書とは言い回しが少し違います。
- 一般の文では、汎用BERT 46.4%、金融BERT 42.9%で、差は1語でした。
まとめ
- 今回試した例では、金融の文章を読んだBERTは、汎用のBERTに比べて、①金融の用語を1つの言葉として持っている、②決算書の決まった言い回しを知っている、という2点で違いがはっきり出ました。名詞を自動で隠した③でも、決算書の文の正解率は22.8%と65.9%で大きく違いました。
- 一方で、「〜%増」のような言い回しや、金融と関係ない文では、差は小さくなりました。③の一般の文では、正解率はほぼ同じでした。
- 分野特化モデルを使う前には、ライセンスの確認が欠かせません。今回調べた医療のモデルはどちらも非営利のみで、金融のモデルは商用でも使えます。
今回は穴埋めで違いを見ただけなので、文章の分類などの実際の作業でどのくらい差が出るかは、別に確かめる必要があります。とはいえ、大量の決算書を読み分けるような作業では、LLMより軽い選択肢として、こうした分野特化モデルも検討する価値がありそうです。
出典・参考
- 使ったモデル:izumi-lab/bert-small-japanese、izumi-lab/bert-small-japanese-fin(東京大学 和泉研究室、CC BY-SA 4.0)
- ③で使った文:財務省「令和6年度 国の財務書類」の注記(PDFの10〜11・20ページ)、気象庁「2026年夏の天候と大気の流れ」(PDFの3・5ページ)。文は、PDFから取り出すときに入った空白と行頭の「・」だけ整えています。
- 表のモデル:JMedRoBERTa(Hugging Face)、UTH-BERT(公式ページ)