1. 概要
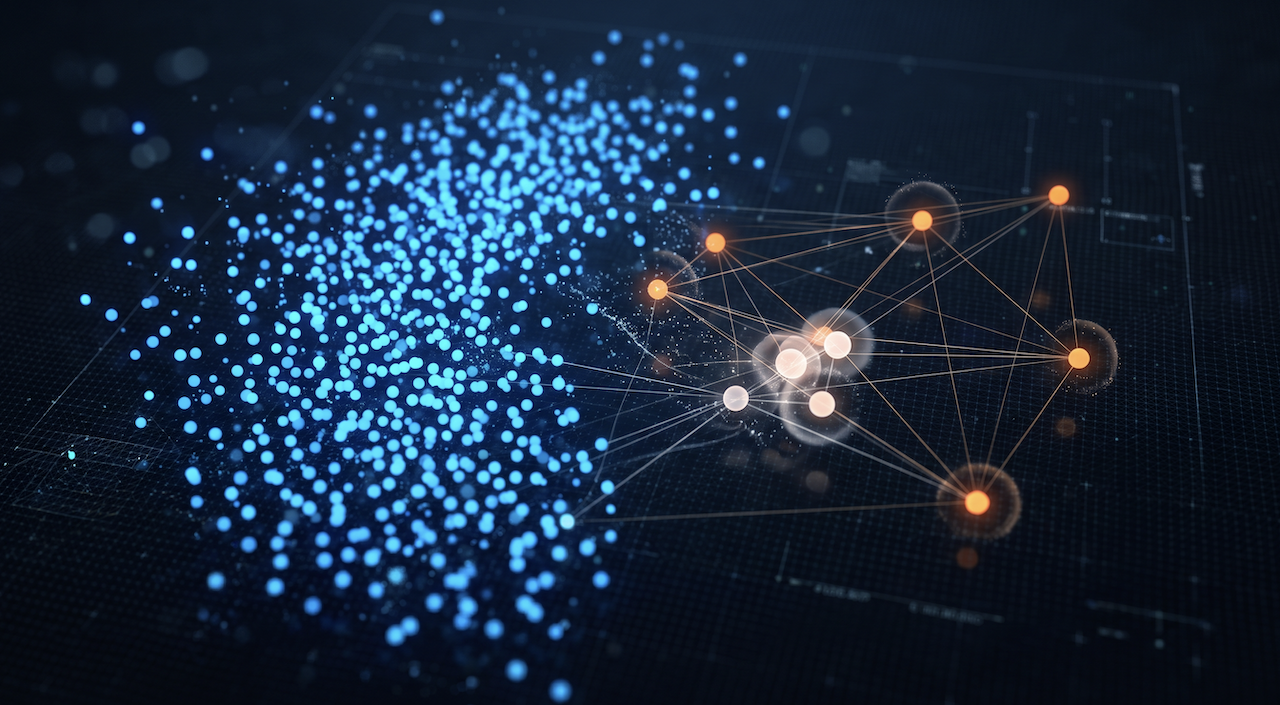
Prediction-Powered Inference(PPI) は、機械学習モデルやLLMの予測を大量に使いつつ、少量の正解データでその誤差を補正 する統計手法です。こうすることで、統計的に正しい信頼区間やp値 を得られます。
2023年に、カリフォルニア大学バークレー校のAnastasios Angelopoulos、Michael I. Jordanらが Science 誌に発表しました。
一言でいえば、次の考え方です。
「AIの予測で推定し、少数の正解データでAIのクセ(バイアス)を測り、差し引く」
PPIには次の性質があります。
- AIの予測が どれだけ不正確でも、得られる信頼区間は正しい(設定した確率で真の値を含む)
- AIの予測が 正確なほど、信頼区間が狭くなる(=少ない正解データで精度の高い結論が出せる)
2. 背景
AIの予測を「データ」として使う時代
近年は、正解ラベルを人手で付ける代わりに、AIの予測を使う場面が急増しています。
- タンパク質の立体構造を、実験ではなくAlphaFoldで予測する
- 衛星画像から森林破壊の有無をモデルで判定する
- アンケートの自由記述をLLMで分類する
- LLMの出力の良し悪しを、LLMに評価させる(LLM-as-a-Judge)
問題:予測を「正解」として扱うと結論が歪む
AIの予測をそのまま本物のデータとして集計すると(素朴な代入法)、次のような問題が起きます。
- 予測にバイアスがあれば、推定値もその分ずれる
- データ数が多いため信頼区間は非常に狭くなり、「ずれた値に自信満々」 という最悪の状態になる
一方で、少量の正解データだけを使う 古典的な方法 は正しい結果を出しますが、データが少ないため信頼区間が広く、はっきりした結論が出せません。
PPIの位置づけ
PPIは、この両者のいいとこ取りを狙った手法です。考え方自体には先行研究があり、主に次の流れに位置づけられます。
- 調査統計の モデル補助推定、差分推定量
- 半教師ありの統計的推論(Zhang, Brown & Cai 2019など)
- 欠測データ理論の 拡張逆確率重み付け(AIPW)
- 制御変量法(control variates)
- 予測値を使った推論の補正(Wang, McCormick & Leek 2020)
PPIは、これらの考え方を 現代の機械学習・AIの予測を使う文脈 で、汎用的かつ使いやすい枠組みとして整理した点が画期的でした。
3. 手法の内容
設定
- ラベル付きデータ:n件(少ない)。正解 Y と AIの予測 f(X) の両方がある
- ラベルなしデータ:N件(多い)。AIの予測 f(X̃) だけがある
- 前提:ラベル付きデータは、全体から ランダムに選ばれている こと
平均を推定する場合
最もシンプルな「平均値の推定」では、PPI推定量は次の式で表されます。
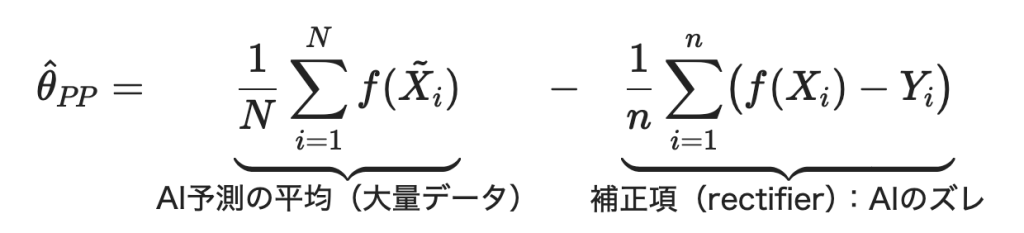

- 第1項:大量のAI予測による推定。分散は小さいが、バイアスを含む
- 第2項:正解データで測った「AIが平均的にどれだけずれているか」。これを引くことでバイアスを打ち消す
信頼区間
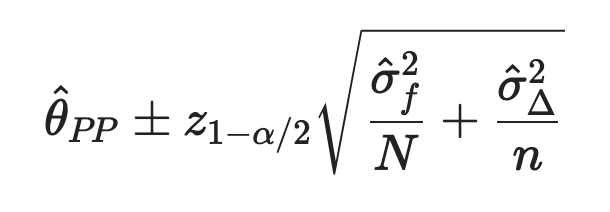
ここで σf2 はAI予測の分散、σΔ2 は 予測誤差(f(X) − Y)の分散 です。
ポイント: 古典的な方法では、正解 Y そのものの分散 σY2 が効いてきます。PPIでは、それが 予測誤差の分散 σΔ2 に置き換わります。AIが優秀なら σΔ2 ≪ σY2 となり、信頼区間が狭くなります。
平均以外への一般化
論文では、凸なM推定 全般に拡張されています。
- 平均、分位点(中央値など)
- 線形回帰・ロジスティック回帰の係数
- その他、凸な損失関数で定義できる推定量
実験内容(論文の主な応用例)
論文では、複数の科学分野の実データで有効性が検証されています。代表例は次のとおりです。
| 分野 | 内容 | 使われた予測 |
|---|---|---|
| タンパク質科学 | 天然変性領域とリン酸化の関連(オッズ比) | AlphaFoldの構造予測 |
| 天文学 | 渦巻銀河の割合 | 銀河画像の分類モデル |
| 遺伝子発現 | 発現量の分位点 | Transformerによる発現予測 |
| 社会科学(国勢調査) | 年齢・性別などと所得の回帰係数 | 勾配ブースティング(XGBoost) |
| 環境 | アマゾンの森林破壊の割合 | 衛星画像モデル |
| 生態学 | プランクトンの個体数 | 画像分類モデル |
これらで3つの方法が比較されました。
- 古典的推論(正解データだけを使う)
- 素朴な代入法(AI予測を正解とみなす)
- PPI
4. 結果
主な結果は次の3点です。
- PPIの信頼区間は、設定した確率で真の値を含んだ(統計的妥当性が保たれた)
- 古典的推論より信頼区間が狭くなった。同じ幅の信頼区間を得るのに必要な正解データの数が、大きく減った
- 素朴な代入法は、信頼区間こそ狭いものの、真の値を外すことが多かった(自信満々で間違えるパターン)
💡 各実験での具体的な削減率や信頼区間の幅は、論文の図(特に Fig. 2 前後)を直接確認し、引用することをおすすめします。
その後の改良
| 手法 | 改良点 |
|---|---|
| PPI++(Angelopoulos, Duchi & Zrnic 2023) | AI予測をどの程度信頼するかの重み λ をデータから自動で調整する。古典的推論より悪くならないことを保証し、計算も効率化 |
| Cross-PPI(Zrnic & Candès 2024) | 学習済みモデルがなくても、ラベル付きデータを交差検証的に使ってモデルの学習と推論を両立する |
| Active Statistical Inference(Zrnic & Candès 2024) | AIが自信のないデータを優先して人間がラベル付けし、さらに効率を上げる |
| Stratified PPI(Fisch et al. 2024) | データを層別化して補正し、LLM評価などで精度を向上させる |
5. 将来性
期待される応用
- LLMによるアノテーションの統計的な活用:社会科学やマーケティング調査で、LLMに大量のテキストを分類させ、人手確認は数百件に抑える。そのうえで、論文や意思決定に使える水準の推定を行う。
- LLM・AIモデルの評価:LLM-as-a-Judgeの評価結果を、少量の人間評価で補正する。モデル間の順位付けにも応用されています。
- 医療・ヘルスケア:電子カルテからの予測と、少数の確定診断を組み合わせて、有病率などを推定する。
- A/Bテスト・ビジネス指標:短期的な代理指標や予測モデルを活用し、実験期間の短縮やサンプル数の削減を図る。
- リモートセンシング、科学全般:衛星画像、顕微鏡画像、シミュレーションなど、「予測は安いが正解は高い」あらゆる分野。
課題と注意点
- ランダム性の前提:ラベル付きデータは、全体からランダムに選ぶ必要があります。都合のよいデータだけにラベルを付けると保証が崩れます(分布がずれる場合の拡張も研究されています)。
- モデルとの独立性:AIの学習に使ったデータを、補正用の正解データとして使い回してはいけません。
- 劇的な改善は、AIが優秀なときだけ:予測精度が低ければ、古典的推論とほぼ同じ結果になります(ただし、間違った結論にはなりません)。
- 因果推論への拡張:観察データでの因果効果推定と組み合わせる研究が進んでいます。
まとめ:なぜ重要か
「AIの出力を科学的・統計的な結論に使ってよいのか?」という問いは、生成AIの普及でますます重要になっています。PPIはこの問いに対して、「少量の正解データがあれば、数学的な保証付きで使える」 という明快な答えを出しました。AIと統計学をつなぐ基盤技術として、今後さらに普及していくと考えられます。
実際に試すには
公式のPythonライブラリ ppi_py が公開されています。
pip install ppi-pythonimport numpy as np
from ppi_py import ppi_mean_ci, classical_mean_ci
# Y: 正解ラベル(少量)
# Yhat: 正解があるデータに対するAI予測
# Yhat_unlabeled: 正解がないデータに対するAI予測(大量)
lower, upper = ppi_mean_ci(Y, Yhat, Yhat_unlabeled, alpha=0.05)
c_lower, c_upper = classical_mean_ci(Y, alpha=0.05)
print(f"PPI : [{lower:.3f}, {upper:.3f}]")
print(f"Classical: [{c_lower:.3f}, {c_upper:.3f}]")ppi_logistic_ci(ロジスティック回帰)や ppi_quantile_ci(分位点)なども用意されています。
6. 参考文献
PPIの原論文・発展
- Angelopoulos, A. N., Bates, S., Fannjiang, C., Jordan, M. I., & Zrnic, T. (2023). Prediction-powered inference. Science, 382(6671), 669–674. arXiv:2301.09633
- Angelopoulos, A. N., Duchi, J. C., & Zrnic, T. (2023). PPI++: Efficient prediction-powered inference. arXiv:2311.01453
- Zrnic, T., & Candès, E. J. (2024). Cross-prediction-powered inference. PNAS. arXiv:2309.16598
- Zrnic, T., & Candès, E. J. (2024). Active statistical inference. ICML 2024. arXiv:2403.03208
- Fisch, A., et al. (2024). Stratified prediction-powered inference for hybrid language model evaluation. NeurIPS 2024.
LLMアノテーションへの応用・関連
- Egami, N., Hinck, M., Stewart, B. M., & Wei, H. (2023). Using imperfect surrogates for downstream inference: Design-based supervised learning for social science applications of large language models. NeurIPS 2023.
- Gligorić, K., Zrnic, T., Lee, C., Candès, E. J., & Jurafsky, D. (2024). Can unconfident LLM annotations be used for confident conclusions? arXiv:2408.15204
先行研究・理論的背景
- Wang, S., McCormick, T. H., & Leek, J. T. (2020). Methods for correcting inference based on outcomes predicted by machine learning. PNAS, 117(48).
- Zhang, A., Brown, L. D., & Cai, T. T. (2019). Semi-supervised inference: General theory and estimation of means. Annals of Statistics, 47(5).
- Robins, J. M., Rotnitzky, A., & Zhao, L. P. (1994). Estimation of regression coefficients when some regressors are not always observed. JASA, 89(427).