はじめに
「社内の問い合わせを自動で振り分けたい」「大量のテキストをカテゴリに分類したい」——こうしたニーズは業務の中でよく出てきます。
最初に思いつくのは、「専用のモデルをゼロから学習させる」という方法です。しかし実際にやってみると、いくつかの壁にぶつかります。
- データ不足:モデルに言語を一から覚えさせるには、数十万〜数百万件規模のデータが必要になる
- 計算コスト:GPUを使っても数日〜数週間かかることがある
- それでも精度が出ない:少ないデータでは汎化できず、テストで崩れる
この記事では、こうした問題を解決する「事前学習モデルのFine-tuning」という手法を紹介します。
事前学習モデルとは、大量のテキストデータであらかじめ言語の構造・意味を学習済みのモデルです。このモデルから追加学習を行うことで、少ないデータ・短時間でも高い精度を実現できます。
実験では、同じBERTアーキテクチャを使って 「事前学習モデルをFine-tuningしたケース」 と 「ゼロから学習させたケース」 を比較し、その差を数値で確認します。
事前学習モデルの取得
使用モデル
今回は cl-tohoku/bert-base-japanese-v3 を使用します。東北大学が公開している日本語特化のBERTモデルで、日本語の大規模コーパスで事前学習されています。
| 項目 | 内容 |
|---|---|
| モデル名 | cl-tohoku/bert-base-japanese-v3 |
| パラメータ数 | 約1億1100万(111M) |
| 学習言語 | 日本語 |
| アーキテクチャ | BERT-base(12層・12ヘッド・隠れ層768次元) |
| 取得元 | Hugging Face Hub |
なぜこのモデルか
ローカルPC(GPU非搭載・RAM 16GB)での実行を前提としているため、モデルサイズは重要な選定基準です。BERT-baseは約440MBと比較的軽量で、CPUのみの環境でも推論・学習が現実的に動作します。
モデルの取得手順
Hugging FaceのTransformersライブラリを使って1行でダウンロードできます。
from transformers import AutoTokenizer, AutoModelForSequenceClassification

MODEL_NAME = "cl-tohoku/bert-base-japanese-v3"
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
model = AutoModelForSequenceClassification.from_pretrained(
    MODEL_NAME,
    num_labels=4
)
ダウンロードしたモデルはローカルに保存しておくことで、以降はオフラインで利用できます。
Fine-tuningの実施
BERTによるテキスト分類の仕組み
BERTはテキストを入力すると、[CLS]と呼ばれる特殊トークンに文章全体の意味を凝縮した768次元のベクトルを出力します。このベクトルに対してシンプルな全結合層(分類ヘッド)を追加することで、分類タスクに応用できます。
入力テキスト
    ↓
[ BERT ] ← 文章の意味を理解・特徴を抽出
    ↓
[CLS] ベクトル(768次元)
    ↓
[ 分類ヘッド(全結合層)]
    ↓
クラスラベル(返品・支払い・配送・その他)
Fine-tuningとスクラッチ学習の違い
今回は同じBERT構造で2つのモデルを比較します。
| Fine-tuningモデル | スクラッチモデル | |
|---|---|---|
| 初期重み | 日本語事前学習済み | ランダム初期化 |
| 学習データ | 1000件 | 1000件(同じ) |
| 学習手順 | 同じ | 同じ |
| アーキテクチャ | 同じBERT-base | 同じBERT-base |
唯一の違いは初期重みだけです。これにより「事前学習の効果」を純粋に測定できます。
学習パラメータ
MAX_LEN    = 128   # 最大トークン長
BATCH_SIZE = 16    # バッチサイズ
EPOCHS     = 3     # エポック数
LR         = 2e-5  # 学習率
損失関数にはクロスエントロピー損失を使用し、スケジューラーによる学習率の線形減衰を適用しています。
実験シナリオの設定
タスク定義
ECサイトや問い合わせ窓口に届くカスタマーサポートの問い合わせ文を4つのカテゴリに自動分類します。
| ラベル | カテゴリ | 例 |
|---|---|---|
| 0 | 返品・交換 | 「開封したら思っていたものと違いました」 |
| 1 | 支払い | 「明細に見覚えのない金額が記載されていました」 |
| 2 | 配送 | 「注文から1週間経ちますがまだ来ていません」 |
| 3 | その他 | 「ログインできなくなりました」 |
データセット
キーワードに頼らず文脈で判断が必要な表現を意図的に採用しています。
| 件数 | 各クラス | |
|---|---|---|
| 学習データ | 1,000件 | 250件ずつ |
| テストデータ | 100件 | 25件ずつ |
評価指標
- Accuracy:全件中の正解率
- F1-score(macro):各クラスのF1スコアの平均(クラス不均衡に強い)
精度比較
実験では、事前学習モデルをFine-tuningしたケースとゼロから学習させたケース(スクラッチモデル) を比較し、その差を数値で確認します。
結果サマリー
| モデル | Accuracy | F1-score(macro) |
|---|---|---|
| 事前学習 Fine-tuning | 100.0% | 1.0000 |
| スクラッチ学習 | 53.0% | 0.4931 |
| 改善幅 | +47.0% | +0.5069 |
クラス別の詳細(スクラッチ学習)
| カテゴリ | Precision | Recall | F1 |
|---|---|---|---|
| 返品・交換 | 0.61 | 0.80 | 0.69 |
| 支払い | 0.83 | 0.20 | 0.32 |
| 配送 | 0.44 | 0.32 | 0.37 |
| その他 | 0.47 | 0.80 | 0.59 |
バッチごとのLoss推移
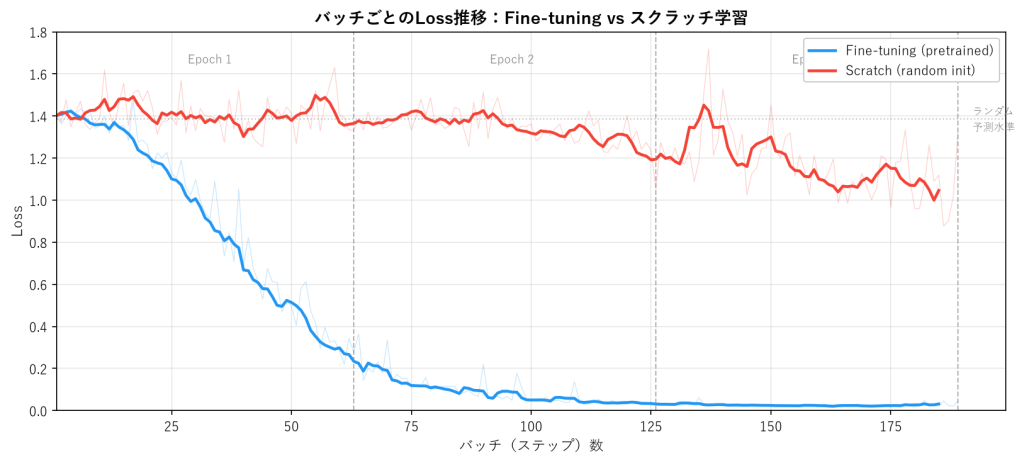
グラフを見ると、2つのモデルの学習の様子が対照的であることがわかります。
Fine-tuning(青) は学習開始直後からlossが急速に低下しています。Epoch 1の途中(Step 30前後)にはすでに1.0を下回り、Epoch 2には0.1を切るまで収束しています。事前学習によって日本語の意味理解がすでに備わっているため、分類ルールの学習だけに集中でき、効率よく精度が上がっていきます。
スクラッチ(赤) は3エポック189ステップを通じて、lossがほとんど下がりません。グラフ上部の点線はランダム予測の水準(約1.386)を示していますが、スクラッチモデルはEpoch 2の終わりになってようやくその水準を下回り始める程度です。1000件のデータでは「日本語とは何か」を学びながら分類タスクを同時にこなすことは難しく、学習が収束しきれていません。
この差が、最終的なAccuracyの100% vs 53%という結果に直結しています。
考察
Fine-tuningモデルはAccuracy 100%、スクラッチは53% という大きな差が生まれました。
スクラッチモデルのクラス別結果を見ると、「支払い」と「配送」のF1スコアが特に低いことがわかります。これらはキーワードに頼らず文脈で判断が必要なカテゴリであり、言語の意味理解なしには正しく分類できません。
スクラッチモデルが苦手な理由は明確です。1000件のデータで「日本語の意味理解」と「分類タスクの学習」を同時にゼロからこなすのは、データ量として不十分です。
一方でFine-tuningモデルは、事前学習によってすでに日本語の文脈・ニュアンス・語の関係性を理解しています。そのため、1000件という少ないデータでも分類ルールだけを効率的に学習でき、高い精度を実現しました。
これが「ゼロから学習しなくていい」理由です。
他への応用例
今回はカスタマーサポートの問い合わせ分類を例に取りましたが、同じアプローチは様々な業務に応用できます。
情報抽出・固有表現認識
契約書や請求書から日付・金額・固有名詞を自動で抜き出す。社内文書の処理自動化に直結します。
特定フォーマットへの変換
自然文を JSON や CSV などの決まった構造に変換する。汎用モデルでは出力が安定しないケースでも、Fine-tuningで安定させることができます。
社内チャットボット・FAQ自動応答
社内ナレッジや製品情報に特化した質問応答システム。クラウドAPIに社内データを送れない環境でも、ローカルモデルのFine-tuningで実現できます。
エッジ・組み込み環境での推論
工場の設備ログ分類や、ネットワーク非接続環境でのリアルタイム判定など。小さいモデルをFine-tuningして特定タスクに特化させることで、制約の強い環境でも動作します。
まとめ
今回の実験では、同じBERTアーキテクチャ・同じ1000件のデータを使いながら、初期重みの違いだけでAccuracyに47%の差が生まれました。
| Fine-tuning | スクラッチ | |
|---|---|---|
| 学習データ | 1,000件 | 1,000件 |
| 事前知識 | 日本語理解あり | なし |
| Accuracy | 100% | 53% |
ゼロから学習させる場合、モデルは「日本語とは何か」から覚え直す必要があります。しかし実務では、そのための大量データも計算資源も用意することは難しい場合がほとんどです。
事前学習モデルのFine-tuningは、その問題をシンプルに解決します。言語理解はすでに済んでいるので、手持ちのデータでタスク固有のルールだけを学習すれば十分です。
今回紹介した問い合わせ分類の他にも、情報抽出・文書変換・FAQ応答など、テキストを扱う多くの業務に同じアプローチが活用できます。まずは手元のデータで試してみてください。