1. はじめに
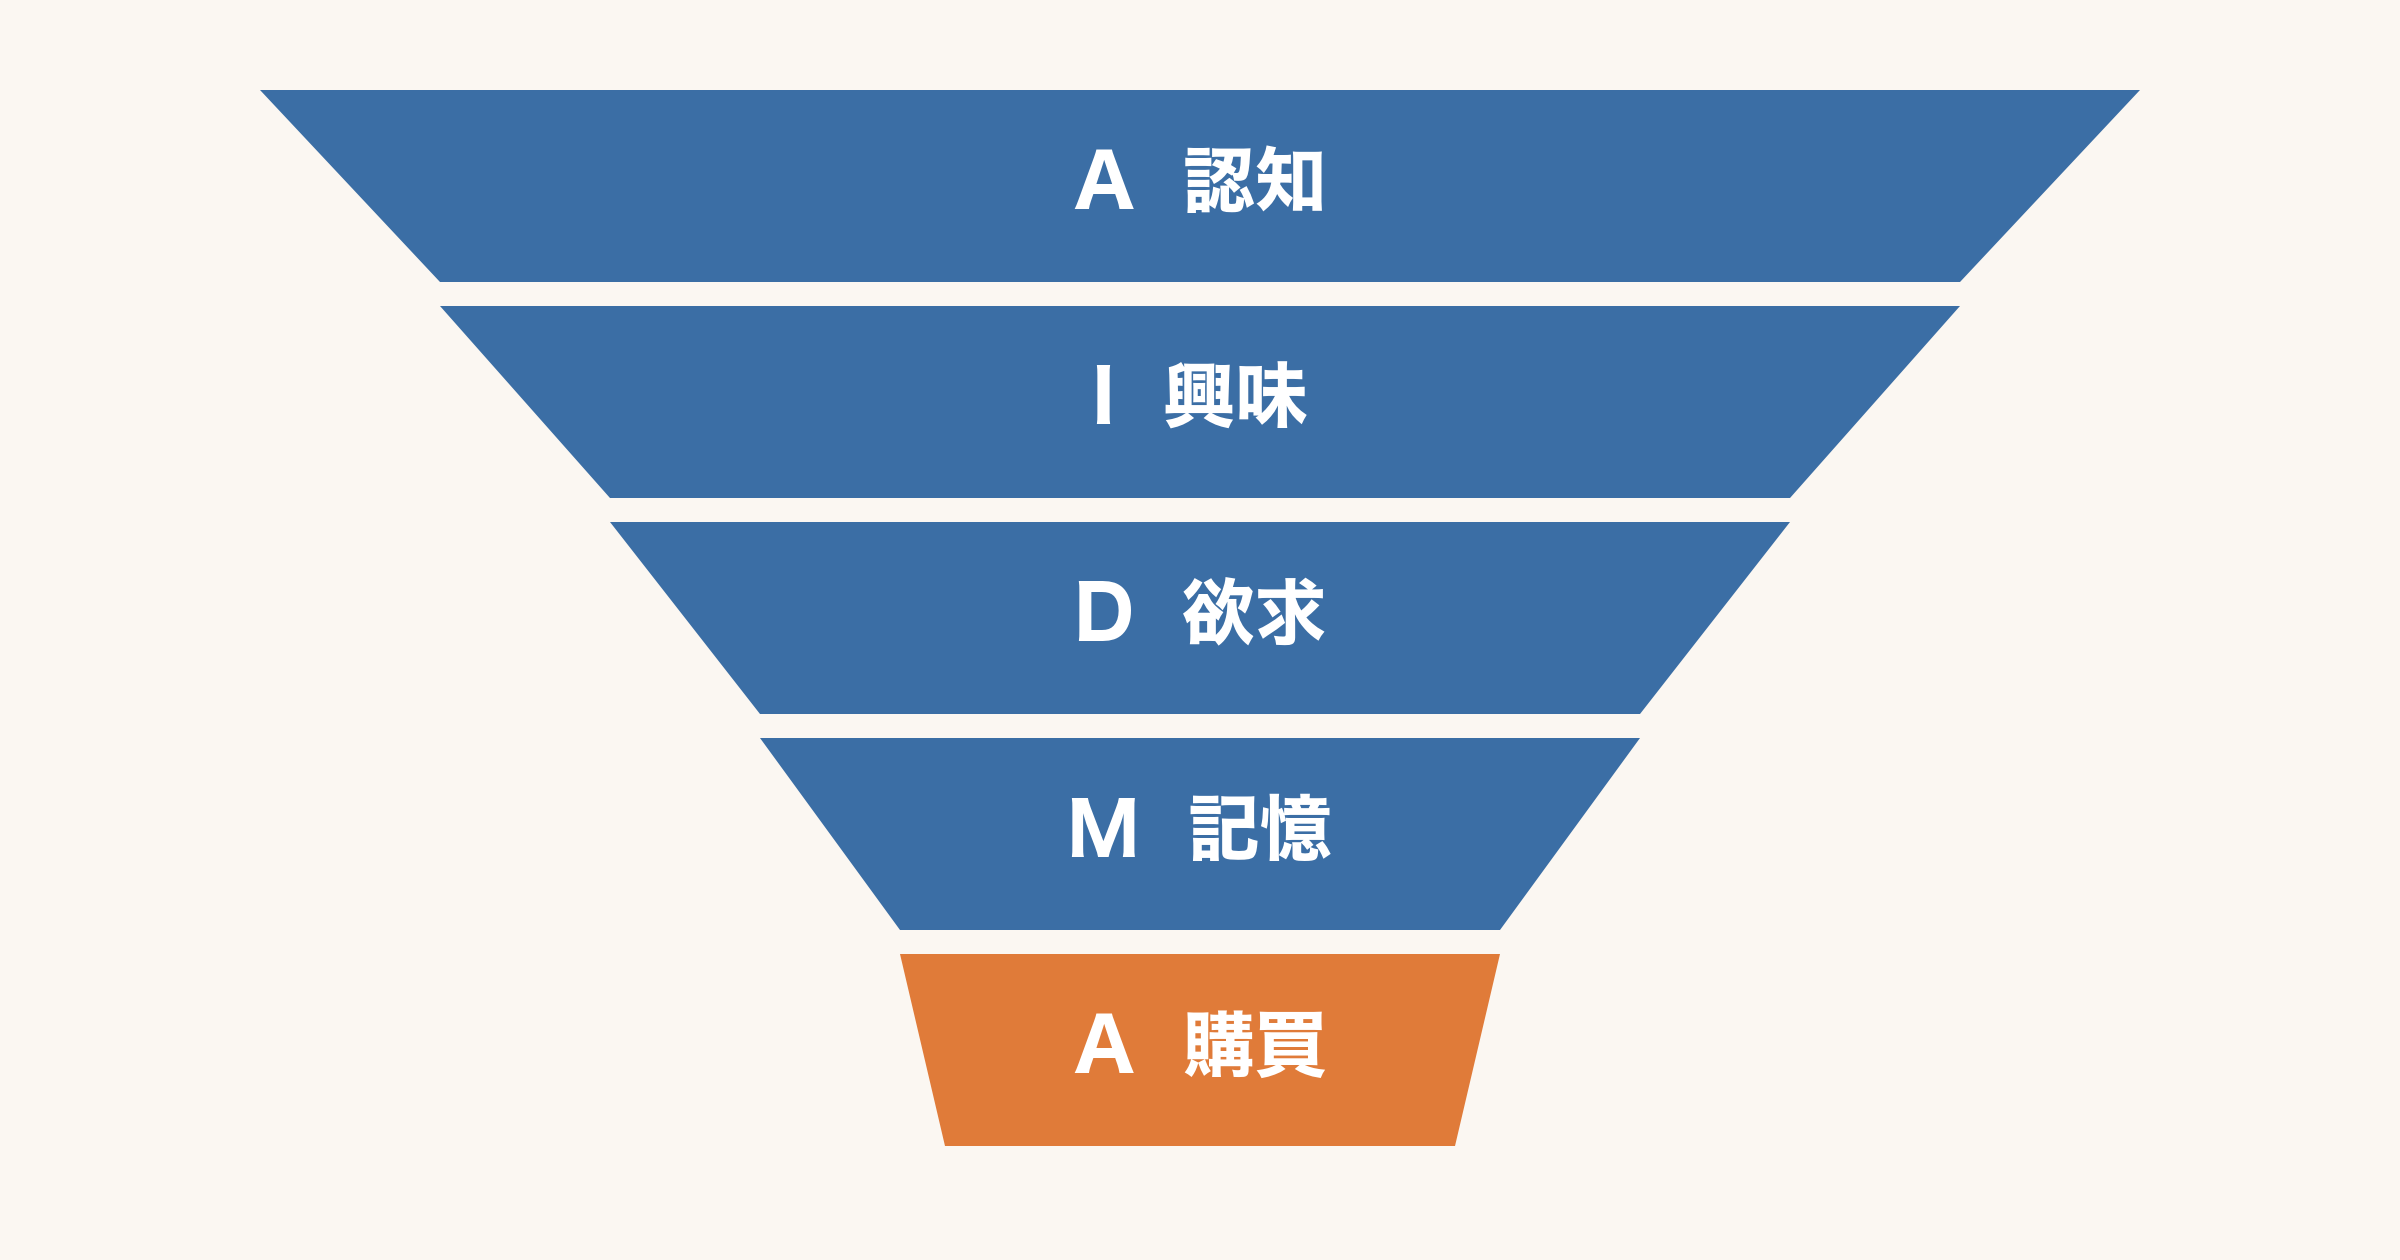
AIDMA は、人が商品を知ってから買うまでを「認知 → 興味 → 欲求 → 記憶 → 購買」の5段階で表すモデルです。
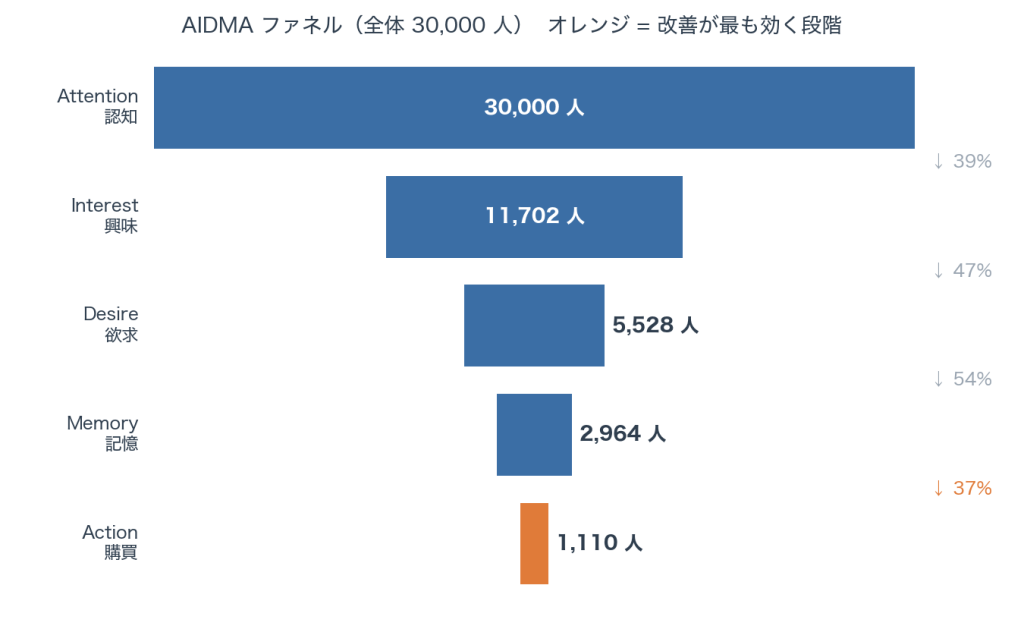
段階ごとの人数を数えると ファネル(じょうご) になり、どこで人が離脱しているか(ボトルネック)がわかります。
この記事では、架空のユーザ 30,000 人のログで AIDMA ファネルを作り、改善すべき段階をチャネル別に探します。
歴史は短く触れます。源流はセールスの心得として生まれた AIDA(1890年代末)です。
新聞・雑誌の広告では「見てから店に行くまでに時間がある」ため、Memory(記憶)を加えた AIDMA が使われるようになりました。
1961年には Lavidge & Steiner の効果の階層モデルや Colley の DAGMAR が、「広告の目標を段階で決めて測る」考え方を広めました。
| 年代 | モデル | 段階 |
|---|---|---|
| 1890年代末 | AIDA | 注意 → 興味 → 欲求 → 行動 |
| 1920年代 | AIDMA | 注意 → 興味 → 欲求 → 記憶 → 行動 |
| 1961年 | DAGMAR | 未知 → 認知 → 理解 → 確信 → 行動 |
| 2004〜05年 | AISAS | 注意 → 興味 → 検索 → 行動 → 共有 |
2. 仕組み
ファネルは 通過率の掛け算 です。認知した人数を $N_0$、段階 $k-1$ から $k$ への通過率を $r_k$ とすると、購買者数は次の式になります。
$$
N_{\text{購買}} = N_0 \times r_1 \times r_2 \times r_3 \times r_4
$$
この式から2つの性質が出てきます。
- どこか1つの段階が低いと、全体が細くなる(ボトルネック)。
- 同じ +5 ポイントでも、低い通過率を上げたほうが効く。0.2 → 0.25 は 1.25 倍ですが、0.8 → 0.85 は 1.06 倍にしかなりません。
もう1つ大事なのが、後ろの段階ほど人数が少なく、通過率が偶然で揺れやすい ことです。
チャネルどうしを比べるときは、差が偶然の範囲かどうかを信頼区間で確かめます。
この記事では ブートストラップ を使いました。手元のユーザを母集団の代わりとみなし、同じ人数を 復元抽出(同じ人を何度選んでもよい)で選び直して、通過率を計算し直します。
これを 1,000 回繰り返して通過率のばらつきを作り、下から 2.5% と 97.5% の点を 95% 信頼区間とします。
3. シミュレーション
外部データは使わず、乱数で作った架空のデータで試しました(Python 3.9.6、numpy 2.0.2 / pandas 2.3.3 / matplotlib 3.9.4)。
ログを作る
テレビCM(15,000人)・SNS広告(10,000人)・検索広告(5,000人)のどれかで認知した 30,000 人が、
AIDMA の5段階をどこまで進んだかを作りました。チャネルごとの「真の通過率」には、次の意図を込めています。
- テレビCM: 多くの人に届くが、興味を持つ人の割合は低い
- SNS広告: 興味は引きやすいが、タイムラインで流れて記憶に残りにくい
- 検索広告: もともと探している人なので、どの段階も通過しやすい
CHANNELS = {
    #            人数     興味  欲求  記憶  購買
    "テレビCM": (15000, [0.25, 0.40, 0.60, 0.30]),
    "SNS広告":  (10000, [0.45, 0.45, 0.30, 0.30]),
    "検索広告": (5000,  [0.70, 0.60, 0.70, 0.45]),
}
各ユーザは、前の段階に進んだ場合だけ、その確率で次の段階へ進みます。
ログには、何段階目まで進んだかを max_stage として残します(0 = 認知、1 = 興味、2 = 欲求、3 = 記憶、4 = 購買)。
rows = []
for channel, (n_users, probs) in CHANNELS.items():
    reached = np.ones(n_users, dtype=bool)        # 全員「認知」はしている(広告に接触した)
    stage_reached = np.zeros(n_users, dtype=int)  # 何段階目まで進んだか
    for k, p in enumerate(probs, start=1):
        # 前の段階に進んだ人だけが、確率 p で段階 k に進む
        reached = reached & (rng.random(n_users) < p)
        stage_reached[reached] = k
    rows.append(pd.DataFrame({"channel": channel, "max_stage": stage_reached}))

log = pd.concat(rows, ignore_index=True)
できたログの一部です。
| channel | max_stage | 意味 |
|---|---|---|
| テレビCM | 4 | 購買まで進んだ |
| テレビCM | 1 | 興味で止まった |
| テレビCM | 0 | 認知で止まった |
| 検索広告 | 4 | 購買まで進んだ |
| テレビCM | 3 | 記憶で止まった |
分析する側は真の通過率を知らないものとして、このログだけを集計します。
ファネルを集計する
段階 $k$ に到達した人数は「max_stage が $k$ 以上の人数」です。集計の中心はこれだけです。
def funnel_table(df):
    """各段階に到達した人数と、前の段階からの通過率を表にする"""
    counts = [(df["max_stage"] >= k).sum() for k in range(len(STAGE_NAMES))]
    table = pd.DataFrame({"段階": STAGE_NAMES, "人数": counts})
    table["前段階からの通過率"] = table["人数"] / table["人数"].shift(1)
    table["認知からの通過率"] = table["人数"] / table["人数"].iloc[0]
    return table
| 段階 | 人数 | 前段階からの通過率 | 認知からの通過率 |
|---|---|---|---|
| 認知 | 30,000 | — | 100% |
| 興味 | 11,702 | 39.0% | 39.0% |
| 欲求 | 5,528 | 47.2% | 18.4% |
| 記憶 | 2,964 | 53.6% | 9.9% |
| 購買 | 1,110 | 37.4% | 3.7% |
ボトルネックを探す
各段階の通過率を 1 つずつ +5 ポイントしたら、購買者が何人増えるかを計算しました。
| 改善する段階 | 通過率 | 購買者の増加 |
|---|---|---|
| 認知 → 興味 | 39.0% → 44.0% | +142 人(+12.8%) |
| 興味 → 欲求 | 47.2% → 52.2% | +117 人(+10.6%) |
| 欲求 → 記憶 | 53.6% → 58.6% | +104 人(+9.3%) |
| 記憶 → 購買 | 37.4% → 42.4% | +148 人(+13.4%) |
通過率がいちばん低い「記憶 → 購買」の改善が最も効きました(図のオレンジ)。仕組みの節で見た掛け算の性質どおりです。
チャネルごとに離脱する段階が異なる
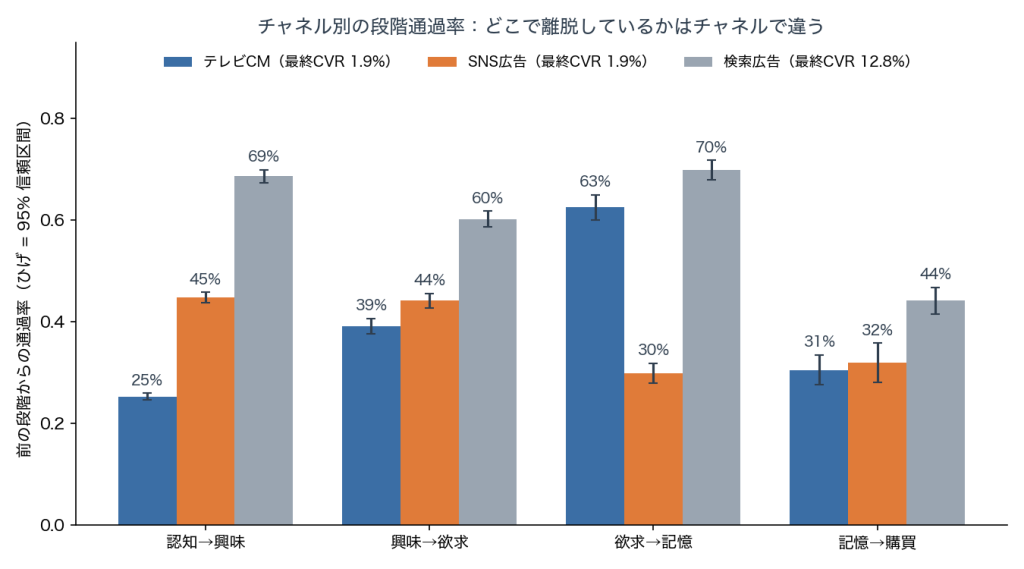
全体のボトルネックは「記憶 → 購買」でした。ところがチャネル別に集計すると、離脱が大きい段階はチャネルごとに異なります。
ブートストラップ(1,000 回)で 95% 信頼区間も付けました。
def step_rates(max_stage):
    """max_stage の配列(行ごとに1回の再標本)から、4つの段階通過率を返す"""
    reached = np.stack([(max_stage >= k).sum(axis=-1) for k in range(len(STAGE_NAMES))], axis=-1)
    return reached[..., 1:] / reached[..., :-1]

boot = step_rates(ms[rng.integers(0, len(ms), size=(N_BOOT, len(ms)))])
lo, hi = np.percentile(boot, [2.5, 97.5], axis=0)
| テレビCM | SNS広告 | 検索広告 | |
|---|---|---|---|
| 認知 → 興味 | 25.3% | 44.7% | 68.6% |
| 興味 → 欲求 | 39.1% | 44.1% | 60.2% |
| 欲求 → 記憶 | 62.6% | 29.8% | 69.9% |
| 記憶 → 購買 | 30.5% | 31.9% | 44.2% |
| 最終 CVR | 1.9% | 1.9% | 12.8% |
テレビCM と SNS広告は、最終 CVR がどちらも 1.9% です。最終の数字だけなら「どちらも同じくらい」としか言えません。
しかしテレビCM は 入口(認知 → 興味) で、SNS広告は 途中(欲求 → 記憶) で大きく落ちています。
どちらも95% 信頼区間が重ならないので、統計的に偶然の差ではないと言えます。
落ちている段階が違うので、推奨される施策も異なってきます。
- テレビCM: 興味を引くクリエイティブに変える
- SNS広告: リターゲティングなどで、忘れられないようにする
一方、「記憶 → 購買」の 30.5% と 31.9% は区間が大きく重なっていて、この差が偶然でないとは言えません。
このように、通過率の値だけでは差が偶然かどうか判断できない場面では特に、信頼区間が役立ちます。
4. 利点と課題
利点
- わかりやすい: 段階の名前だけで、チーム内で「いまどこを攻めているか」を共有できる。
- ボトルネックが見つかる: 最終 CVR が同じ 1.9% でも、どこで落ちているかで打ち手を変えられる。
- 計算が軽い: 段階ごとに数えて割るだけ。感度分析も掛け算の組み替えで済む。
- Web ログと相性がよい: 訪問 → 商品閲覧 → カート → 購入のように、行動がそのまま段階になる。
課題
- 人は順番どおりに進まない: 衝動買い・指名買いのように、段階を飛ばしたり戻ったりする行動は多い。
- 心理段階は直接見えない: 「興味」「欲求」はアンケートでしか測れない。特に「記憶」に当たるログは実務ではほとんど取れない。
- 後ろの段階は人数が少ない: 通過率が偶然で揺れるので、信頼区間なしの比較は危うい。
- 因果ではない: 「+5pt 上げたら」は、上げる施策がほかの段階に影響しないという仮定の計算にすぎない。
5. まとめ
- AIDMA ファネルは 通過率の掛け算 なので、いちばん低い通過率がボトルネックになる。この実験では「記憶 → 購買」の +5pt で +148 人と最も効いた。
- チャネル別に分けると打ち手が変わる。最終 CVR が同じ 1.9% でも、テレビCM は入口(25.3%)、SNS広告は途中(29.8%)で落ちていた。
段階を一本道で数えるファネルは、接点を行き来する顧客や、口コミのループを表すのが苦手です。
こうした動きは、マルコフ連鎖による顧客ジャーニー分析や Bass 普及モデルで扱えます。
まずファネルでボトルネックを見つけ、そこを出発点にこれらの手法へと分析を広げていくとよいでしょう。
参考文献・参考リンク
- Hall, S. R. (1924). Retail Advertising and Selling. McGraw-Hill.
- Strong, E. K. (1925). Theories of Selling. Journal of Applied Psychology, 9(1), 75–86.