公平なコイン (表の確率 0.5)と、表が出やすいコイン (表の確率 0.8)を考える。 が本物のコインだと信じたまま、実際には から出た結果を見るとしたら、どれくらい「予想外」に感じるだろうか。
公平なコイン P と偏ったコイン Q の確率の比較
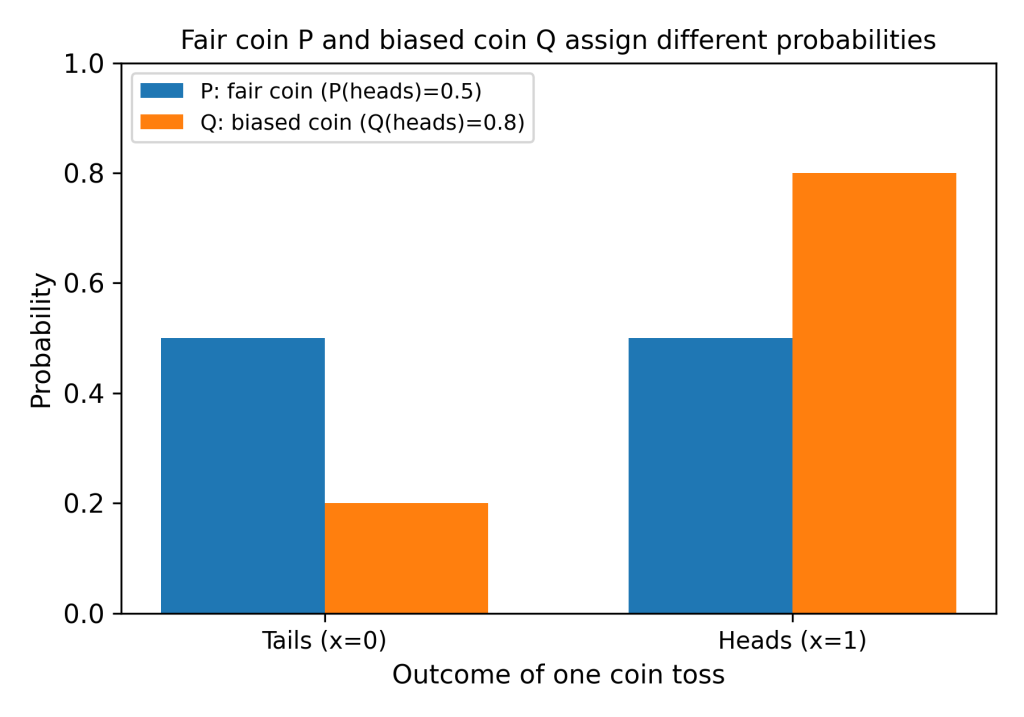
図1: 公平なコイン P(表の確率 0.5)と偏ったコイン Q(表の確率 0.8)が、裏と表それぞれに割り当てる確率を並べた棒グラフ。
図1は2つの分布を並べたものである。ずれは目で見て分かるが、まだ1つの数としては表せていない。
知りたいのは次の3点である。
- ずれはどう定義できるのか。
- ずれの性質1(なぜ負にならないのか。)
- ずれの性質2(なぜ と を入れ替えると値が変わるのか。)
設定
用語の補足
- 確率分布: 各結果の起こりやすさを並べたもの。コインなら 。
- は真の分布、 はモデル(こちらが信じている)分布。 の表の確率を とする。
- 、: 結果 に対して、 と がそれぞれ割り当てる確率。コインでは は表か裏である。
- 驚き: 結果 に対する 。めったに起きないことほど大きい。例えば、確率 0.01 の出来事は確率 0.5 の出来事より驚きが大きい。
- 対数は自然対数で、単位は nat(ナット)。
となるすべての結果で であると仮定する。このとき、KLダイバージェンス(カルバック・ライブラー情報量。分布のずれ)を次のように定義する [1]。
KLダイバージェンスの定義の流れ図を以下に示す。
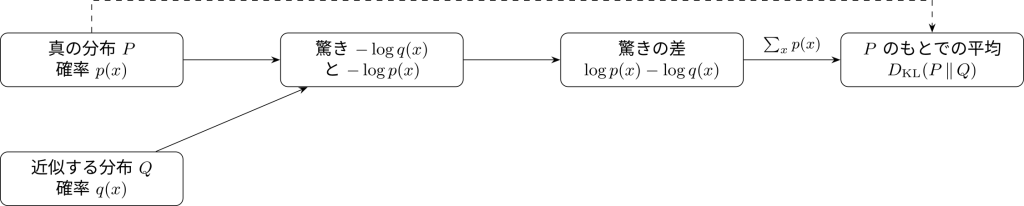
図2: 真の分布 P と近似する分布 Q から結果ごとの驚きの差を作り、P のもとで平均すると KLダイバージェンスになる、という流れを示した概念図。
導出
結論を先に述べると、 は「 を基準にした平均の驚き」から「 を基準にした平均の驚き」を引いた量であり、0 以上になる。
以下、和は となる結果の集合 について取る。 の項は とみなして除けるためである。
ステップ1: 対数を分ける
なので、次のように書ける。
ステップ2: 交差エントロピーとの関係
第1項を交差エントロピー 、第2項をエントロピー と呼ぶ。
は に依存しない。したがって、 を動かして を最小にすることと、KLダイバージェンスを最小にすることは同じ問題である。最尤推定が交差エントロピーの最小化と同じ問題になるのは、このためである。
ステップ3: 非負性
まず数値例で確かめる。 のとき で、 となり、不等式 が成り立っている。
用語の補足
- 凹関数: グラフ上の任意の2点を結ぶ線分が、グラフより下にある関数。対数がその例である。
は の における接線である。対数は凹関数なので、グラフは接線の下側にある。これが の理由である [2]。
の各 で とおく。 なので、この比は定義できる。すると次のようになる [3]。
最後の不等号が成り立つのは、 上での の和が、全体の和である 1 を超えないからである。
よって であり、等号が成り立つのは のときに限る [4]。
余談 等号条件は、 が のときだけ成り立つこと、および の外で となることから従う。厳密な議論は省略。
ステップ4: 非対称性
コインでは、次の2つの式は一般に異なる値になる。
平均を取る分布が か かで、各結果に付く重みが変わるためである。
数値実験
次のスクリプトで、4つの主張を確かめる。
- のとき、最小値 0 になる。
- 交差エントロピーからエントロピーを引くと、KLダイバージェンスに一致する。
- 向きを入れ替えると値が変わる。
- 経験分布の KLダイバージェンスは、投げる回数 が増えると 0 に近づく。
先に、実験で使う用語を整理しておく。
用語の補足
- ベルヌーイ分布 : 表が確率 、裏が確率 で出るコインの分布。
- 経験分布: 実際に投げた結果から求めた表の割合を、表の確率とみなした分布。
- 乱数シード: 乱数の初期値。固定すると、何度実行しても同じ結果になる。
- 両対数軸: 横軸も縦軸も対数目盛りにしたグラフ。桁をまたぐ値を比べやすい。
python
import numpy as np
from scipy.special import xlogy, xlog1py


def kl(p, q):
    """KL(Bernoulli(p) || Bernoulli(q)) in nats. 0*log0 is handled by xlogy."""
    return xlogy(p, p / q) + xlogy(1 - p, (1 - p) / (1 - q))


# (1) P = Bernoulli(0.5), Q = Bernoulli(q): KL(P||Q) as a function of q
p = 0.5
qs = np.linspace(0.01, 0.99, 99)
kl_pq = kl(p, qs)
print(f"min of KL(P||Q) at q ={qs[np.argmin(kl_pq)]:.2f}, value ={kl_pq.min():.2e}")

# (2) cross entropy - entropy = KL
cross_ent = -(xlogy(p, qs) + xlog1py(1 - p, -qs))
entropy_p = -(xlogy(p, p) + xlogy(1 - p, 1 - p))
kl_diff = cross_ent - entropy_p
print(f"max |(H(P,Q) - H(P)) - KL| ={np.max(np.abs(kl_diff - kl_pq)):.2e}")

# (3) asymmetry: P fixed at 0.8, Q = Bernoulli(q)
p2 = 0.8
kl_fwd = kl(p2, qs)   # KL(P||Q)
kl_rev = kl(qs, p2)   # KL(Q||P)
print(f"p=0.5, q=0.8: KL(P||Q) ={kl(0.5, 0.8):.4f}, KL(Q||P) ={kl(0.8, 0.5):.4f}")

# (4) empirical distribution of N tosses of the true coin (nested samples)
rng = np.random.default_rng(0)
Ns = np.array([10, 100, 1000, 10000, 100000])
flips = rng.random(Ns.max()) < p
phat = np.array([flips[:n].mean() for n in Ns])
kl_hat = kl(phat, p)  # KL(empirical || true coin)
for n, v in zip(Ns, kl_hat):
    print(f"N ={n:6d}: KL(empirical||true) ={v:.2e}")
output
min of KL(P||Q) at q = 0.50, value = 0.00e+00
max |(H(P,Q) - H(P)) - KL| = 4.44e-16
p=0.5, q=0.8: KL(P||Q) = 0.2231, KL(Q||P) = 0.1927
N =     10: KL(empirical||true) = 8.23e-02
N =    100: KL(empirical||true) = 7.22e-03
N =   1000: KL(empirical||true) = 1.46e-03
N =  10000: KL(empirical||true) = 2.00e-06
N = 100000: KL(empirical||true) = 1.92e-06
出力から読み取れることは次のとおりである。
- (1) 最小は で、値は 0 だった。
- (2) と KLダイバージェンスの差は、最大でも で、丸め誤差の範囲で一致している。
- (3) では 、 となり、向きを入れ替えると値が変わる。
- (4) では 、 では 、 では と減り、 では になった。ただし、 の と の値はほぼ同じで、毎回きれいに減るわけではない。表の割合がたまたま 0.5 にごく近くなるなど、乱数のゆらぎがあるためである。
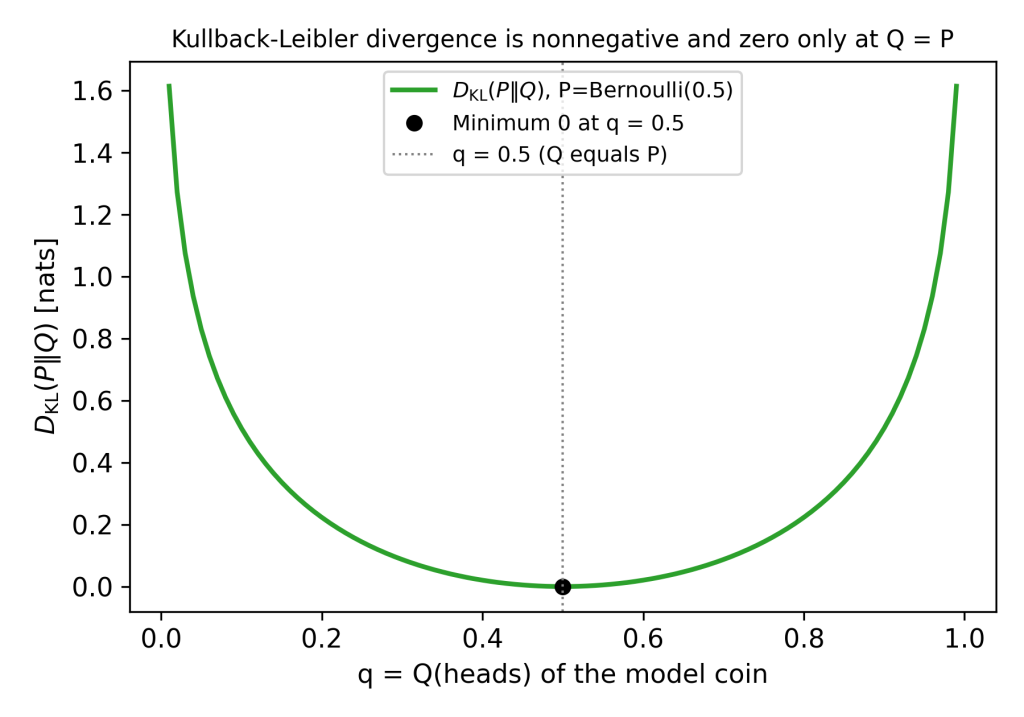
図3: を Bernoulli(0.5) に固定し、横軸をモデルのコインの表の確率 、縦軸を (単位は nat)として描いた図。 で最小値 0 になる。
図3では、最小値が のところにある。これは、ステップ3の等号条件 と一致する。
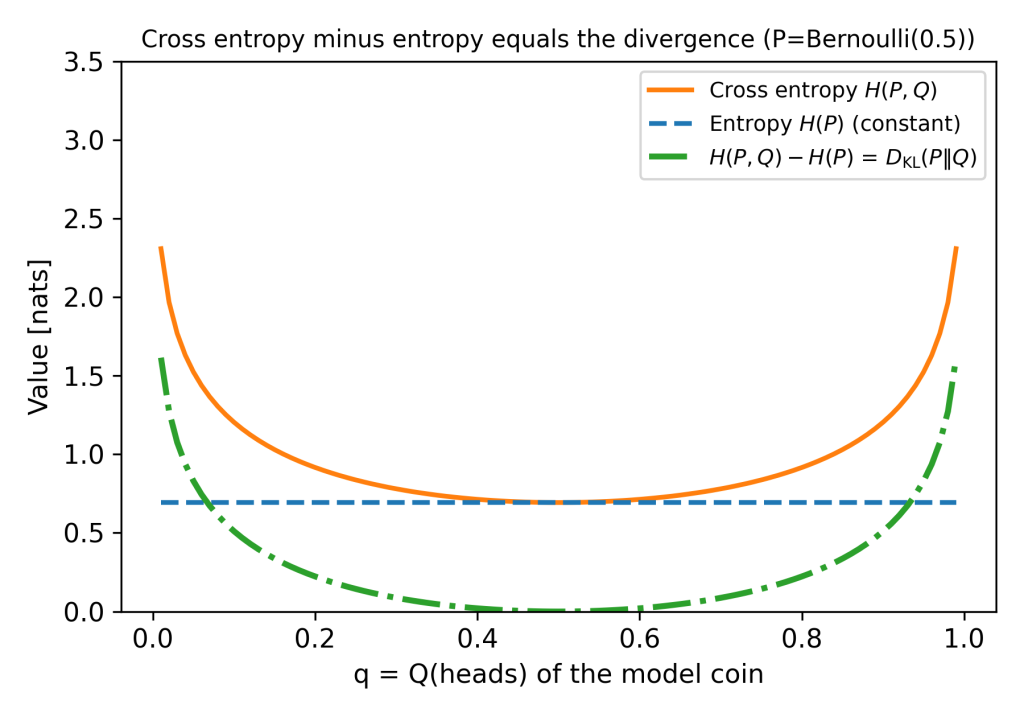
図4: を Bernoulli(0.5) に固定し、横軸を として、交差エントロピー 、エントロピー (定数)、およびその差 (KLダイバージェンスに一致)を重ねた図。
図4では、交差エントロピーとエントロピーの差が、KLダイバージェンスの曲線として描かれている。先に示した最大誤差の小ささは、ステップ2の恒等式と数値的に整合している。
KLダイバージェンスの非対称性(P=Bernoulli(0.8))
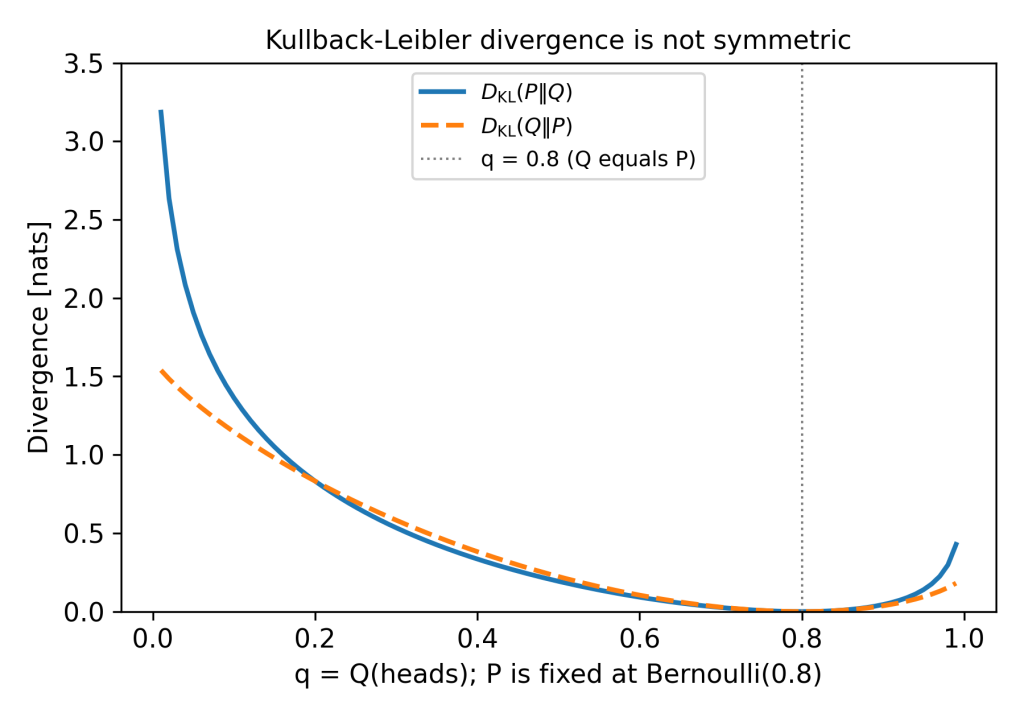
図5: を Bernoulli(0.8) に固定し、横軸を として、 の曲線を並べた図。2つが一致しないことが分かる。
図5では、 に対する2つの向きの曲線が一致していない。 を動かした範囲で、ステップ4の非対称性を確認できる。
投げる回数 と経験分布の KLダイバージェンス
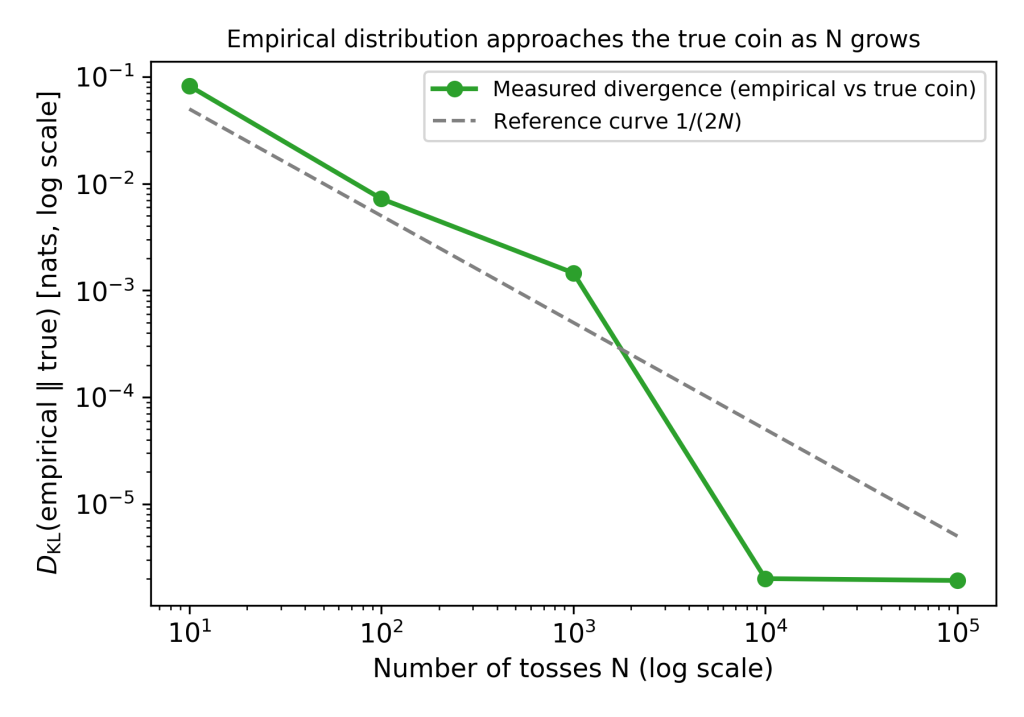
図6: コインを N 回(10 回から 100000 回)投げて得た経験分布と、真のコイン Bernoulli(0.5) との KLダイバージェンスを、両対数軸で描いた図。参考として 1/(2N) の曲線を破線で重ねている。
図6では、 を増やすと経験分布が真のコインに近づき、KLダイバージェンスが小さくなっている。これは、ステップ3の等号条件 に近づくことに対応する。
破線は参考として描いた の曲線である。この係数は、目安の曲線であり減少の様子を理論線として示すものではない。実際、 では だが、実測は だった。
確かめられたのは、 が大きいほど値がおおむね小さくなるという傾向までである。しかも1回の試行の結果にすぎないので、細かい減り方まではこの実験から判断することはできない。
注意とよくある誤解
この定義が成り立たなくなるのは、 なのに となる場合である。例えばコインで とすると、表が出る に対して が発散し、KLダイバージェンスは無限大になる [5]。
誤解の1つ目は、KLダイバージェンスを距離と見なすことである。距離としての量は、対称であることと三角不等式が成り立つことが必要になる。三角不等式とは、3点 A、B、C について、AからCまでの距離が、AからBまでとBからCまでの距離の和以下になるという性質である。KLダイバージェンスは非対称で、三角不等式も成り立たないので、距離としては扱われない [6][7]。どちらの向きを使うかは、目的に合わせて選択する必要がある。
誤解の2つ目は、値が小さければ向きによらず似ているとみなすことである。向きによって値が変わるため、どちらの向きを測ったのかを明示する必要がある [8]。
まとめ
- は、「 を信じたときの平均の驚き」と「 を知っているときの平均の驚き」の差であり、0 以上で、 のときだけ 0 になる。
- 向きによって値が変わるので、距離ではない。また、 という関係を通じて、交差エントロピーの最小化、つまり最尤推定につながる。
参考文献
- entropy — SciPy v1.18.0 Manual (scipy.stats.entropy)
- Gibbs’ Inequality (freshrimpsushi)
- Gibbs’ inequality (non-negativity of KL divergence) · Prove2Me
- Machine Learning. The Science of Selection under Uncertainty (arXiv 2509.21547)
- KL Divergence: Definition, Estimation & Applications
- Chapter 28 Shannon Entropy and Kullback-Leibler Divergence
- KL divergence: measuring distance between distributions
- Kullback–Leibler Divergence Overview