1. はじめに
技術の概要と背景
マルチエージェント強化学習(Multi-Agent Reinforcement Learning、以下MARL)は、複数のエージェントが同じ環境の中で同時に学習する強化学習の枠組みである。倉庫内の複数ロボットの経路調整、自動運転車同士の合流判断、対戦型ゲームのAI、電力網の分散制御など、「1体だけで完結しない」タスクは実務でも珍しくない。
MARL自体の研究は1990年代のマルチエージェントQ学習の研究にまで遡るが、近年はディープラーニングと組み合わせたMADDPG(2017年)やQMIX(2018年)といった手法、さらにLLMエージェントを複数連携させる「マルチエージェントLLMシステム」の文脈でも再び注目されている。
なぜ注目されているのか
単一エージェントの強化学習(Single-Agent RL)がすでに広く実用化されている一方、MARLが難しいのは「相手も学習している」という点にある。自分から見た環境は、相手の方策が学習の途中で変化し続けることで、時間とともに変わって見える。この性質は**非定常性(non-stationarity)**と呼ばれ、MARL特有の難しさの中心にある。
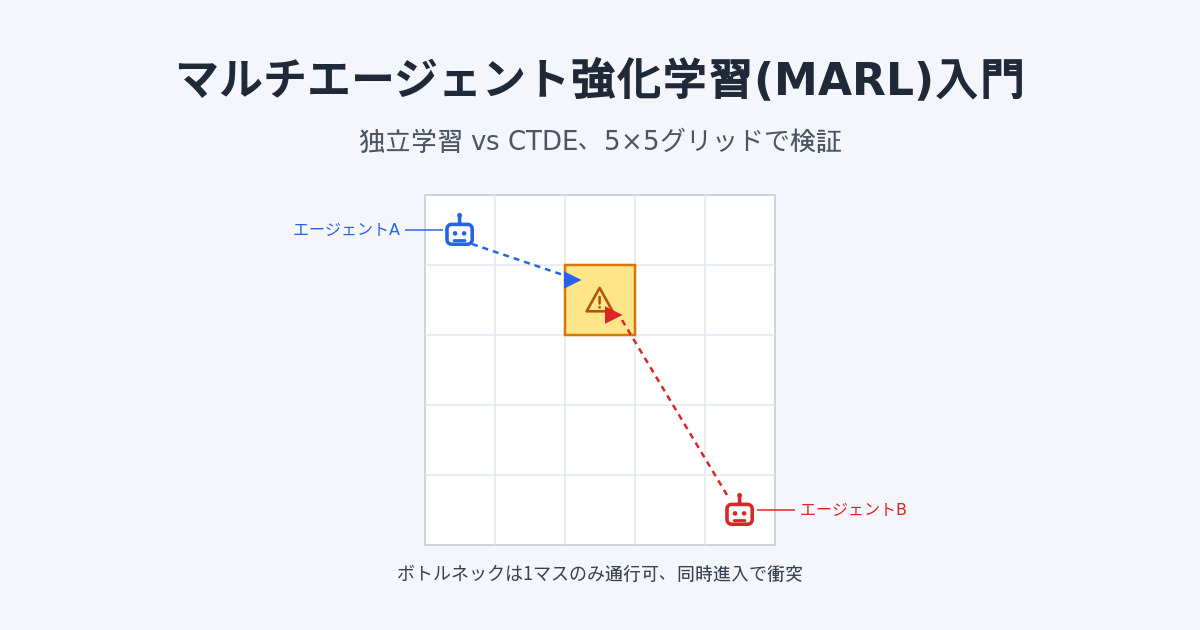
この記事では、MARLの基本的な考え方(独立学習・報酬共有・CTDE)を整理したうえで、それらの効果を「小さいが実際に動くコード」で検証する。結論を先に言うと、教科書的な直感(相手の情報を使えるほど協調しやすくなるはず)を裏切る結果が出た。この記事はその過程と原因の考察を記録したものである。
2. 詳細説明
技術の基本原理
MARLで各エージェントの学習方法を分類する軸はいくつかあるが、代表的なのは「学習時にどこまで他エージェントの情報を使うか」である。
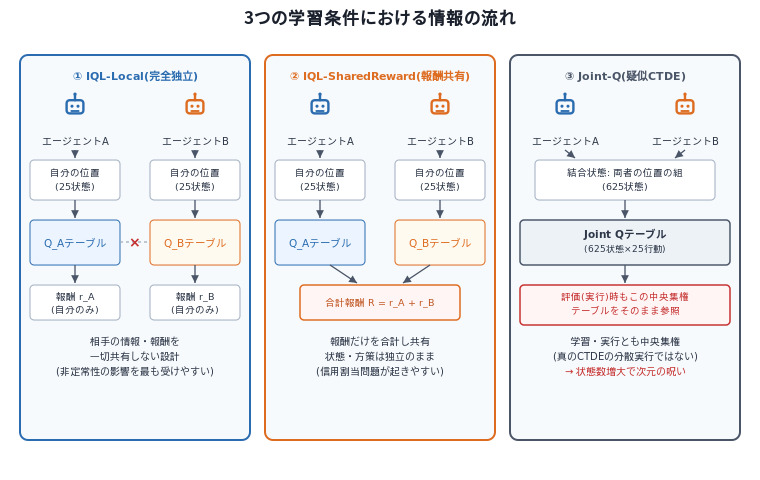
- 独立学習(Independent Learning, IL): 各エージェントが、自分の観測・自分の報酬だけを使って独立に学習する。実装が単純だが、非定常性の影響をもろに受ける。IQL(Independent Q-Learning)はその代表例。
- 報酬共有(Shared Reward): 状態や方策は独立のまま、報酬だけをチーム全体で共有する。「協調させたいなら報酬を揃えればよい」という素朴な発想に基づく設計だが、非定常性そのものは解消されない。
- CTDE(Centralized Training with Decentralized Execution): 学習時には全エージェントの状態・行動を中央で把握できる情報を使い、実行時には各エージェントが自分のローカルな観測だけで動けるように方策を分解する。MADDPGやQMIXはこの枠組みに属する。
主要な機能と特徴
CTDEの利点は、「学習時にはズルをして良い(相手の情報を見てよい)が、実行時は現実的な制約(自分の観測だけ)に従う」という設計にある。これにより非定常性を学習時に緩和しつつ、実運用時の分散実行という制約も満たせる。QMIXやVDNは、中央集権的な価値関数を各エージェントのローカルな価値関数の組み合わせに分解することで、この「学習は集権的、実行は分散的」を厳密に実現する。
本記事の実験では、QMIX/VDNのような価値分解までは実装せず、簡略化した「疑似CTDE」(以下Joint-Q)を用いる。この簡略化の意味と限界は4節で詳しく述べる。
3. 使用例
- 倉庫ロボットの経路計画: Amazon Roboticsのような倉庫では、多数のロボットが同じ床面を共有しながら棚を運搬する。衝突回避と搬送効率の両立にMARL的な発想(協調方策の学習)が使われる。
- 信号機の協調制御: 交差点ごとの信号機を独立に最適化するのではなく、隣接する信号機群を1つのマルチエージェント系として学習させることで、渋滞の伝播を抑える研究が進んでいる。
- 対戦・協力ゲームAI: StarCraft II向けのQMIX、Dota 2向けのOpenAI Fiveなど、複数キャラクターの協調・対戦をMARLで学習させた事例は多い。
これらの成功事例はいずれも、単純なIQLでは太刀打ちできない大規模・複雑な協調が必要な場面である。裏を返せば、「協調が本当に必要になるタスクの複雑さの閾値」がどこにあるかは、事例からは見えにくい。次節の実験は、あえて小さすぎるタスクでこの閾値の手前を覗いてみる試みである。
4. 実測による検証
検証した仮説と実験設計
検証環境・仮説・手法の詳細は experiments/2026-09-01-marl-cooperative-vs-independent-qlearning/README.md にまとめてある。要点は以下の通り。
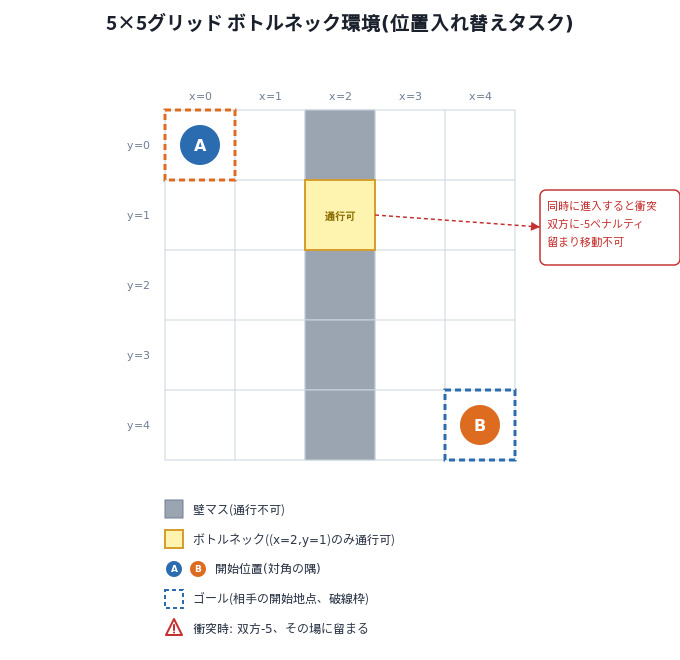
- 環境: 5×5グリッド。中央列(x=2)は(x=2, y=1)の1マスだけが通行可能な「ボトルネック」。2体のエージェントが対角の隅からスタートし、互いの開始位置を目指す(位置入れ替えタスク)。両者が同時にボトルネックへ進入しようとすると衝突となり、双方に-5のペナルティを与えその場に留まらせる。
比較した3条件
(すべてタブラーQ学習、α=0.1、γ=0.95、ε: 1.0→0.05に線形減衰):
1.IQL-Local
: 自分の位置(25状態)のみを使う完全独立学習。
2.IQL-SharedReward
: 状態表現はIQL-Localと同じだが、報酬を両エージェントの合計にして共有する。
3.Joint-Q(疑似CTDE)
: 両エージェントの位置の組(625状態)×行動の組(25行動)からなる中央集権的Qテーブルを学習する。ただし評価(実行)時もこの中央集権テーブルをそのまま参照しており、VDN/QMIXのような価値分解を伴う「真の分散実行」ではない。
仮説
: CTDE的な情報共有があるほど、非定常性が緩和されて収束が速く・最終成功率も高くなる(Joint-Q > IQL-SharedReward > IQL-Local)。
試行
: 各条件、乱数シード10個(0〜9)で学習2000エピソード→評価100エピソード(ε=0)を実行。
実行手順と結果
当初はNode.jsでの実装を予定していたが、実行環境にNode.jsが存在しなかったため、依存ライブラリなしのWindows PowerShellスクリプト(run-experiment.ps1)として実装した。当初の実装(共通関数+scriptblockデリゲート)はPowerShellの関数呼び出しオーバーヘッドが大きく10分のタイムアウトで完走しなかったため、ホットループを条件ごとにインライン展開する構成に書き直している(詳細はREADME参照)。最終的な実行時間は51,632ms。
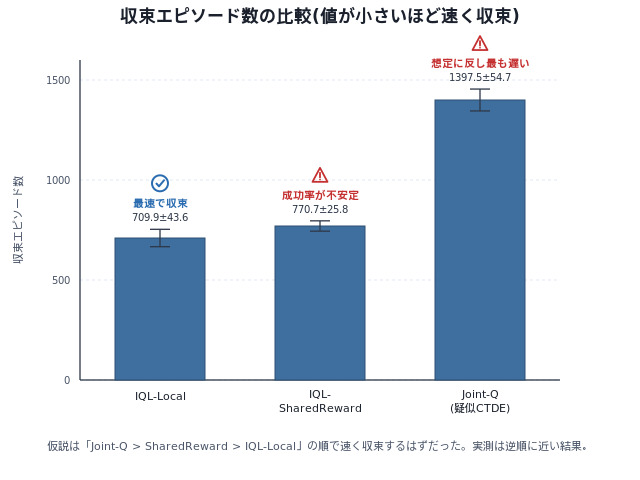
experiments/2026-09-01-marl-cooperative-vs-independent-qlearning/results.json から引用した、10シードの平均±標準偏差は以下の通り。
| 条件 | 収束エピソード数 | 評価成功率 | 評価時平均報酬 | 評価時平均衝突回数 |
|---|---|---|---|---|
| IQL-Local | 709.9 ± 43.6 | 100.0% ± 0.0 | 2.00 ± 0.00 | 0.00 ± 0.00 |
| IQL-SharedReward | 770.7 ± 25.8 | 60.0% ± 49.0 | -117.60 ± 214.62 | 8.90 ± 17.80 |
| Joint-Q(疑似CTDE) | 1397.5 ± 54.7 | 100.0% ± 0.0 | -2.50 ± 0.92 | 0.00 ± 0.00 |
「収束エピソード数」は学習中の成功率(直近50エピソードの移動平均)が初めて90%を超えたエピソード番号。2000エピソード以内に到達しなければ上限値2000として記録する設計だが、今回はどの条件・シードも到達している。
結果から言えること・言えないこと
言えること:
- この実験設定では、仮説(H1: Joint-QがIQL-Localより速く収束し、成功率も高い)は棄却された。収束エピソード数はIQL-Local(709.9)がJoint-Q(1397.5)のほぼ半分で済んでいる。事前にREADMEへ反証パターンとして書いていた「Joint-Qが状態空間の増大(625状態×25行動)によりむしろ収束が遅くなる」が的中した形になる。
- 評価時の成功率はIQL-LocalとJoint-Qがともに100%だが、平均報酬はIQL-Local(2.00)がJoint-Q(-2.50)を上回る。Joint-Qは最終的に協調できてはいるが、遠回りが多く移動コスト(-1/ステップ)がかさんでいると考えられる。
- 仮説(H2: IQL-SharedRewardはIQL-Localより悪いがJoint-Qには及ばない)も支持されなかった。IQL-SharedRewardは10シード中6シードで成功率1・報酬2という好結果だった一方、残り4シードでは成功率0・報酬-48〜-550・衝突最大45回という大失敗に終わり、平均すると60%±49.0という極めて不安定な結果になった。「チーム報酬さえ与えれば協調が促進される」という素朴な主張は、少なくともこの設定では支持されない。
言えないこと:
- この実験は5×5・2エージェント・固定開始位置という極小設定であり、CTDEやQMIX/MADDPGといった実用手法が無効であることを示すものではない。むしろ、開始位置が固定で環境が完全に決定的だったために、IQL-Localも「自分の位置」だけで実質的に固定タイミングの回避行動を学習できてしまった可能性が高く(相手の状態を明示的に見る必要がなかった)、これは実務で想定される「相手の位置がランダムに変わる」状況とは異なる。
- Joint-Qの不利な結果は、価値分解を伴わない単純な結合状態表現に特有の「次元の呪い」である可能性が高く、QMIX/VDNのような分解を伴う実装であれば結果が変わる可能性は十分にある。今回の実験はその代替(価値分解ありのCTDE)を検証したものではない。
- n=10という小規模な試行数のため、特にIQL-SharedRewardの「6勝4敗」の内訳が母集団の真の分布を反映しているのか、単なる乱数のいたずらかは判断できない。
5. 利点と課題
メリットとデメリット
- 独立学習(IQL): 実装が単純で、エージェント数が増えても学習アルゴリズム自体はスケールしやすい。一方、非定常性の影響を受けやすく、理論的な収束保証が弱い。今回の実験ではこの弱点が顕在化しなかったが、それは環境が単純すぎたためである可能性が高い。
- 報酬共有: 実装コストがほぼゼロで導入できる手軽さが利点だが、今回の実験で見た通り「協調が偶然うまくいくシードと、局所解にはまるシードが両方存在する」という不安定さを生みやすい。個々のエージェントが「チーム報酬の変化が自分の行動のせいか相手のせいか」を区別できないという信用割当問題(credit assignment problem)が背景にある。
- CTDE: 学習時に十分な情報があれば非定常性を大きく緩和できるはずだが、状態空間・行動空間が組み合わせ的に増大するため、状態数が多い設定では学習に必要なサンプル数も跳ね上がる。今回の実験(625状態×25行動)でも、2000エピソードでは単純なIQLに収束速度で負けた。
技術の限界とその克服方法
CTDEの「組み合わせ爆発」を克服するのがQMIXやVDNの価値分解であり、中央集権的なQ値を「各エージェントの価値関数の和(VDN)」や「単調な合成関数(QMIX)」に分解することで、テーブルやネットワークのサイズを状態数の掛け算ではなく足し算のオーダーに抑える。本実験のJoint-Qはこの分解を行っていない単純な実装であり、その弱点(次元の呪い)がそのまま観測された、と捉えるのが妥当である。
6. 将来展望
- LLMマルチエージェントとの接続: 近年のLLMエージェントを複数連携させるシステムも、突き詰めれば「各エージェントが部分観測のもとで協調する」という点でMARLと同じ問題設定を共有している。CTDE的な発想(オーケストレーター役が全体状況を把握し、個々のサブエージェントには必要な情報だけを渡す)は、LLMマルチエージェント設計にもそのまま応用できる考え方である。
- 報酬設計の重要性の再確認: 今回の実験は「報酬さえ揃えれば協調する」という発想の危うさを示した。実務でマルチエージェント系を設計する際は、報酬共有だけに頼らず、状態表現や通信プロトコルの設計にも同等の注意を払う必要がある。
- 今回の疑似CTDEをQMIX/VDN相当に発展させた再実験: 価値分解を実装し、同じ環境で再比較すれば、「次元の呪いが本当に価値分解で解消されるか」を直接確認できる。これは自然な追試のネタになる。
7. まとめ
MARLの基本的な3つの設計(独立学習・報酬共有・CTDE)を、5×5グリッドの小さな協調タスクで比較したところ、教科書的な直感(CTDEが最も有利)に反し、最も単純な独立学習が最速で収束し、報酬も最良という結果になった。報酬共有はシードによって成功と失敗が両極化する不安定さを見せ、疑似CTDEは状態空間の増大により学習が遅れた。
この結果は「CTDEが無効である」という結論ではなく、「タスクの複雑さがある閾値を超えないと、CTDEの利点は顕在化しない(あるいは価値分解なしのCTDEは逆に不利になりうる)」ことを示唆している。
付録
参考リンク:
- Tampuu et al., “Multiagent Cooperation and Competition with Deep Reinforcement Learning” (independent Q-learningの初期の深層学習応用)
- Lowe et al., 2017, “Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments” (MADDPG)
- Rashid et al., 2018, “QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning”