はじめに
RandomForestやLightGBMは、表形式のデータの予測で強力です。では、訓練データより大きい値を予測させると、どうなるでしょうか。
この記事では、簡単なデータで実験して、次の3点を確かめます。
- 訓練データの範囲の外を予測すると、予測値が横ばいになる
- その原因が、木モデルの仕組みのどこにあるのか
- 範囲外でも当たる予測にする方法
実験の設定
真の関係をy = 2x(ノイズあり)とし、x が 0〜10 のデータだけで学習させます。その後、x=15 と x=20 を予測させます。比較するのは、線形回帰、RandomForest、LightGBM です。
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from lightgbm import LGBMRegressor

rng = np.random.default_rng(42)
x = rng.uniform(0, 10, 300)
y = 2 * x + rng.normal(0, 1, 300)
X_train = x.reshape(-1, 1)

models = {
    "Linear": LinearRegression(),
    "RandomForest": RandomForestRegressor(n_estimators=200, random_state=0),
    "LightGBM": LGBMRegressor(n_estimators=200, random_state=0, verbose=-1),
}
for name, m in models.items():
    m.fit(X_train, y)
    print(name, m.predict([[15.0], [20.0]]))
結果:範囲の外で、予測が横ばいになる
データの乱数を変えて20回繰り返した平均です。
| x | 真の値 | 線形回帰 | RandomForest | LightGBM |
| 15 | 30 | 29.96 | 19.95 | 19.20 |
| 20 | 40 | 39.95 | 19.95 | 19.20 |
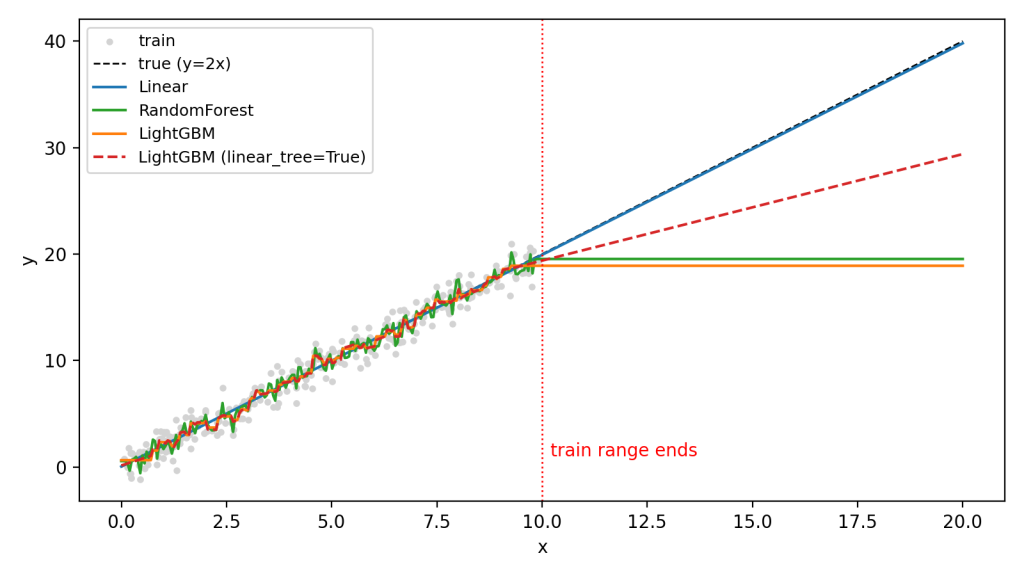
線形回帰は、範囲外の外でも真の値に近い予測を出します。一方、RandomForestとLightGBMは、x=10を超えたところから横一直線になりました。x=20では、真の値40に対して予測は約20です。半分にも届きません。20回のうち、この傾向が崩れたことはありませんでした。
原因:葉の平均を返しているだけ
木モデルは、特徴量の値でデータを分割し、各グループ(葉)の訓練データの平均を予測値として返します。x=15やx=20のデータは、訓練データでいちばん右にあった葉に振り分けられます。そのため、予測値は訓練データのyの範囲を超えられません。
木は関係式を学習しているのではなく、「見たことのある値の平均」を返しています。線形回帰は、傾きという関係式を学習するので、範囲の外まで延ばせます。
対処法:トレンドを先に取り除く
木モデルに任せる前に、線形回帰で長期の傾きをつかみます。残りのずれを木モデルに学習させ、最後に足し合わせます。
lin = LinearRegression().fit(X_train, y)
rf = RandomForestRegressor(n_estimators=200, random_state=0)
rf.fit(X_train, y - lin.predict(X_train))        # 傾きを引いた残りを学習

X_new = np.array([[15.0], [20.0]])
pred = lin.predict(X_new) + rf.predict(X_new)    # 傾き + 残りの予測
同じ20回の平均は、次のとおりです。
| x | 真の値 | RandomForest単体 | トレンド除去+RandomForest |
| 15 | 30 | 19.95 | 30.03 |
| 20 | 40 | 19.95 | 40.02 |
範囲外でも、真の値にほぼ一致しました。20回の最小と最大は、x=20で38.91~40.88です。
LightGBMのlinear_tree=True(葉の中で線形回帰を使うオプション)も試しましたが、20回の平均は42.42(x=20)でも、最小21.24、最大57.88と大きくブレました。範囲外の予測を安定させたいなら、トレンドを大きく取り除く方法の方が確実です。
まとめ
- RandomForestとLightGBMは、訓練データの範囲外で予測が頭打ちになる。x=20では、真の値40に対して約20だった
- 原因は、葉ごとに訓練データの平均を返す仕組みにある
- 線形回帰でトレンドを取り除いてから木モデルを使うと、範囲外でも真の値にほぼ一致した
売上やユーザー数のように、増え続ける量を予測するときは、木モデルに丸ごと任せない。傾きを先に取り出して、残りを木に任せる。これが、この落とし穴への対処法です。