1. はじめに
レコメンドの2つのアプローチ
推薦の手法は、大きく2つに分かれます。アイテムの特徴を手がかりにする「内容ベース」。そして、人の行動を手がかりにする「協調フィルタリング」です。
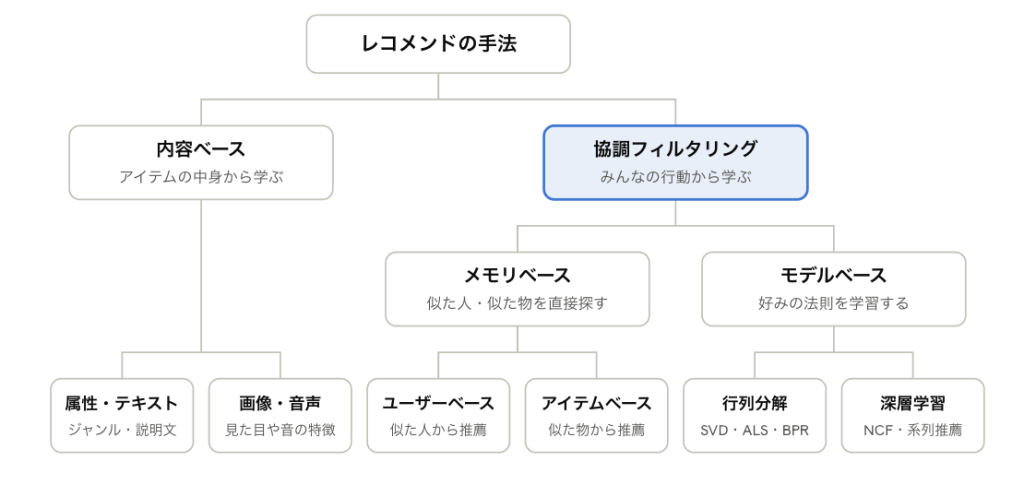
この記事では、右側の枝である協調フィルタリングに注目し、そのいくつかの例について紹介します。
協調フィルタリングとは
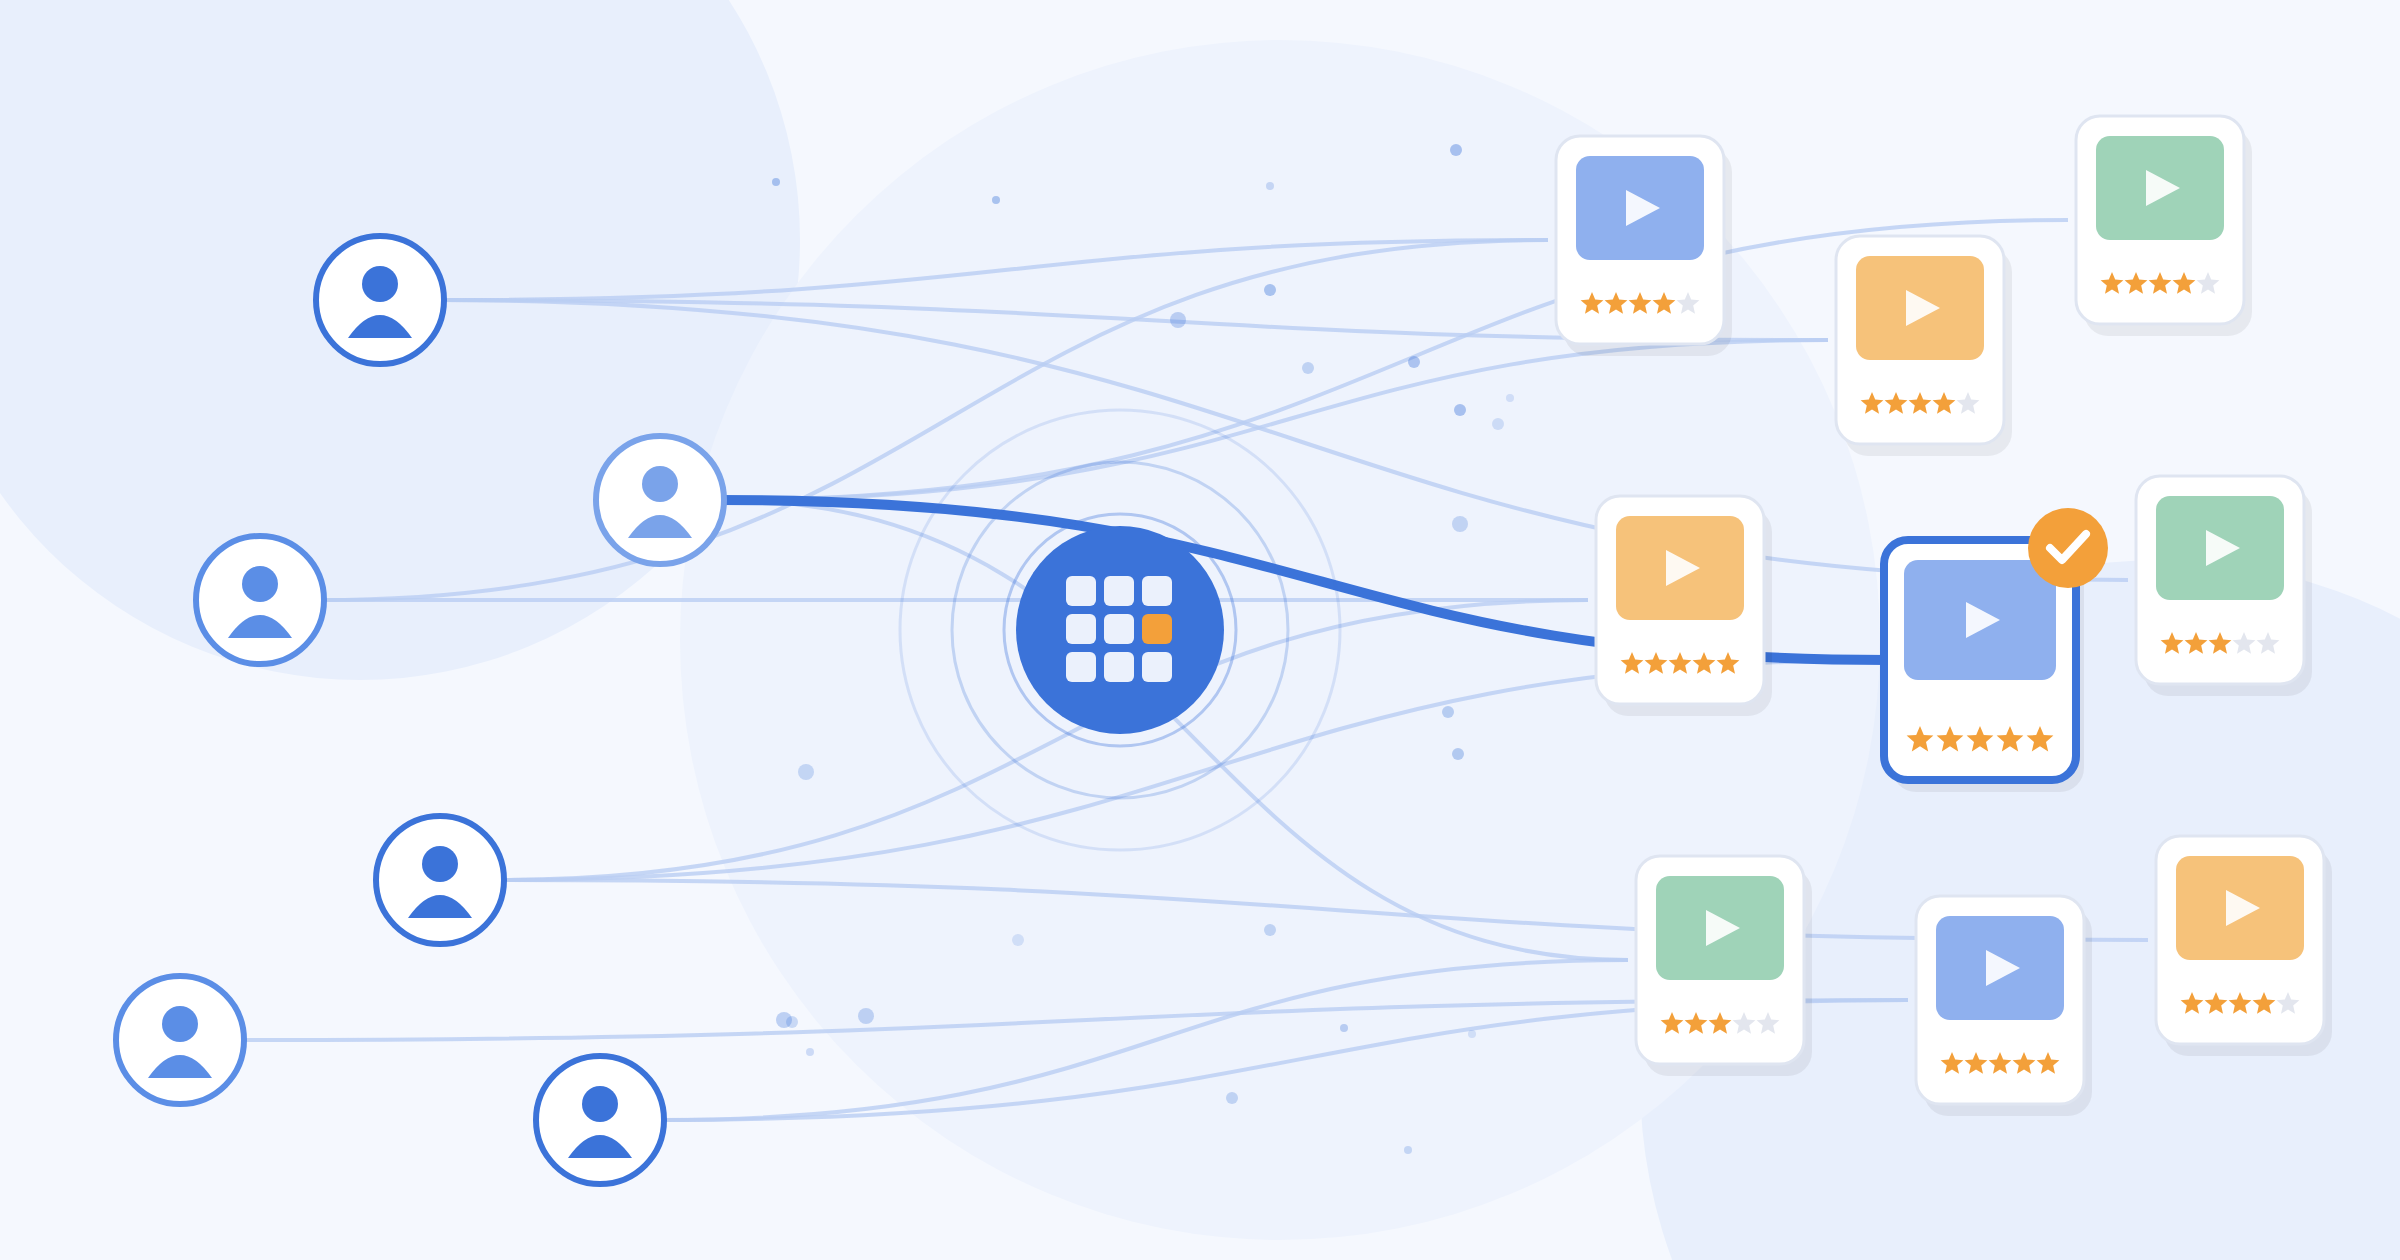
友人に「この映画、君なら好きだと思う」と薦められたことはありませんか。協調フィルタリングは、この口コミを大量のデータで自動化する技術です。考え方は「好みの似た人は、似たものを好む」というシンプルなものです。
内容ベースとの違い
内容ベースは、あなたが好きなものの特徴を調べ、その特徴に合うアイテムを推薦します。SF映画が好きな人には、別のSF映画を薦めます。そのためには、ジャンルや出演者などの情報が欠かせません。
協調フィルタリングは、あなたと評価の傾向が似ている人が好むアイテムや、あなたが好きなアイテムと評価のされ方が似ているアイテムを推薦します。映画のジャンルやストーリーは知らなくて構いません。必要なのは、誰がどう行動したかの記録だけです。
| 観点 | 内容ベース | 協調フィルタリング |
|---|---|---|
| 手がかり | ジャンルや説明文などの特徴 | 誰が何を好んだかの記録 |
| 推薦の例 | SF好きに、別のSF | 似た人が好きな、別ジャンルの作品 |
| 新作の扱い | すぐに推薦できる | 評価が集まるまで苦手 |
| 意外な発見 | 生まれにくい | 生まれやすい |
| 必要な準備 | アイテムやユーザーの特徴データの整備 | ユーザーの行動の記録 |
2. 技術の基本原理
小さな例で考えてみる
6人が6本の映画を、星1〜5で評価したとします。
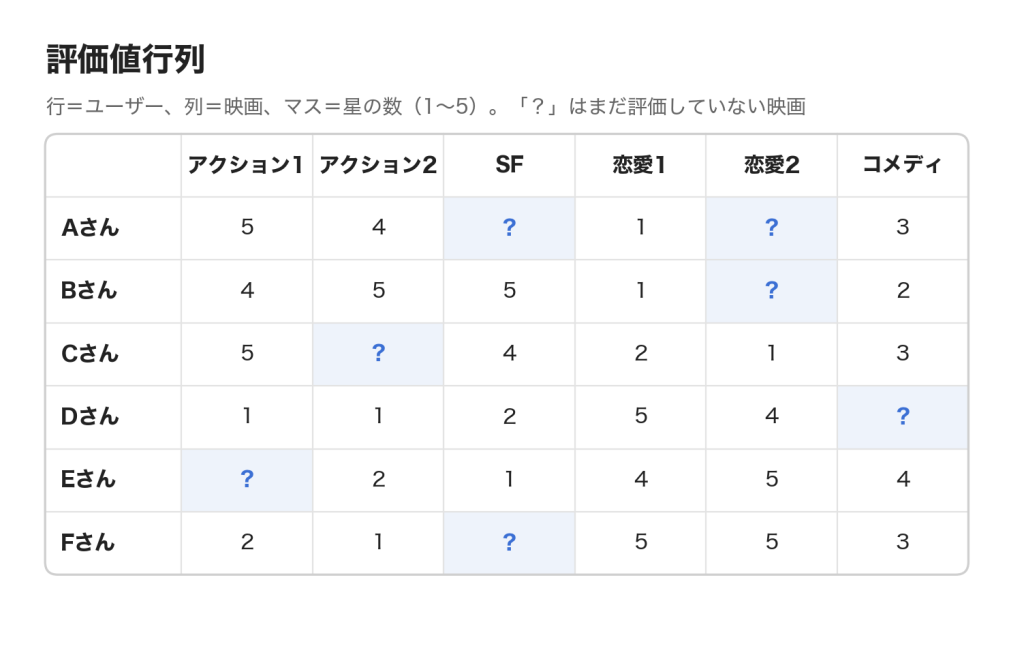
このような表を「評価値行列」と呼びます。実際のサービスでは、ほとんどのマスが「?」(未評価)です。協調フィルタリングは、この評価値行列をどう処理すれば良い推薦ができるかを考える技術です。
AさんはSFをまだ見ていません。さて、SFを薦めるべきでしょうか。以下では、AさんのSFの「?」を予測する例で、各手法を見ていきます。
協調フィルタリングの種類
協調フィルタリングは、大きく「メモリベース」と「モデルベース」に分かれます。
メモリベースは、評価値行列をそのまま使って「似ているもの」を探す方式で、「近傍法」とも呼ばれます。似たユーザーを探す「ユーザーベース」と、似たアイテムを探す「アイテムベース」があります。ここでいう「似ている」は、どちらも中身ではなく行動で判断します。
モデルベースは、評価値行列から好みの傾向を学習しておき、それを使って予測する方式です。行列分解や深層学習が代表です。
メモリベース
メモリベースの4ステップ
- 行動を集める:評価、購入、閲覧などの履歴を、ユーザー×アイテムの表にまとめます。
- 似ている度合いを測る:ユーザー同士(アイテムベースではアイテム同士)の評価の並びがどれだけ似ているかを、数値で表します。
- 空欄を予測する:似ている相手ほど重く扱い、評価を重み付きで平均します。
- 並べて薦める:まだ評価していないアイテムを、予測値の高い順に表示します。
「似ている」の測り方
よく使われるのがコサイン類似度です。評価の並びを矢印に見立て、その向きがどれだけ揃っているかを測ります。
ただし星の評価はすべてプラスなので、好みが正反対の人同士でも類似度が高めに出ます。そこで、各自の平均点を引いてから比べるピアソン相関もよく使われます。採点のクセを消して好みの形だけを比べる工夫で、好みが正反対なら−1に近づきます。他にもジャカード係数などがあります。
ユーザ間型メモリベース
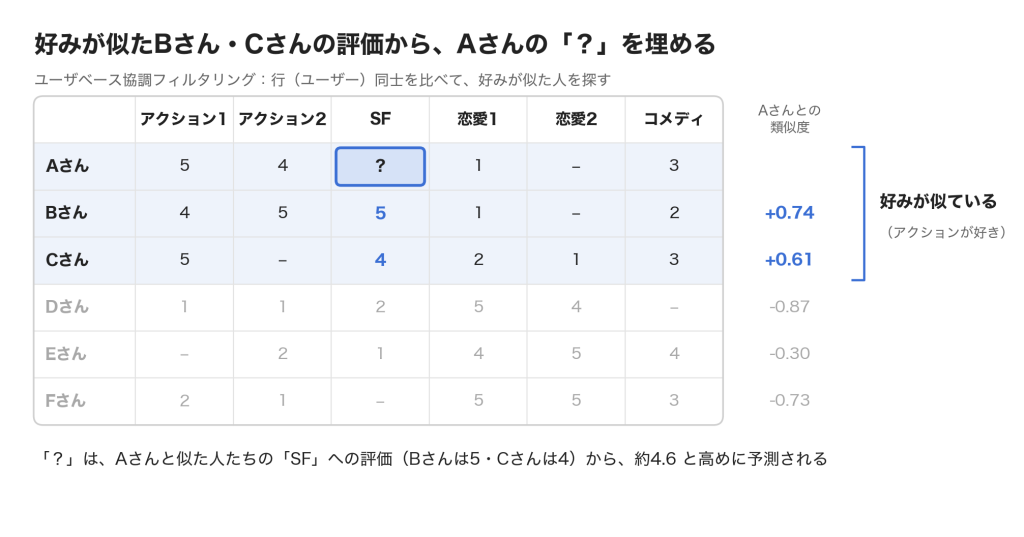
評価値行列の行同士を比べて、Aさんと好みの似た人を探します。
Aさんはアクション1・2を高く、恋愛1を低く評価しています。BさんとCさんも、アクションが好きで恋愛が苦手という点で似ています。一方、D〜Fさんは恋愛が好きでアクションが苦手な、Aさんとは逆の好みです。実際に類似度を計算すると、BさんとCさんはプラス(+0.74、+0.61)、D〜Fさんはマイナスになります。
似ているBさんとCさんは、SFにそれぞれ星5と星4をつけています。この2人の評価を類似度で重み付けして平均すると(各自の平均点のずれも補正します)、AさんのSFは約4.6と高めに予測されます。
アイテム間型メモリベース
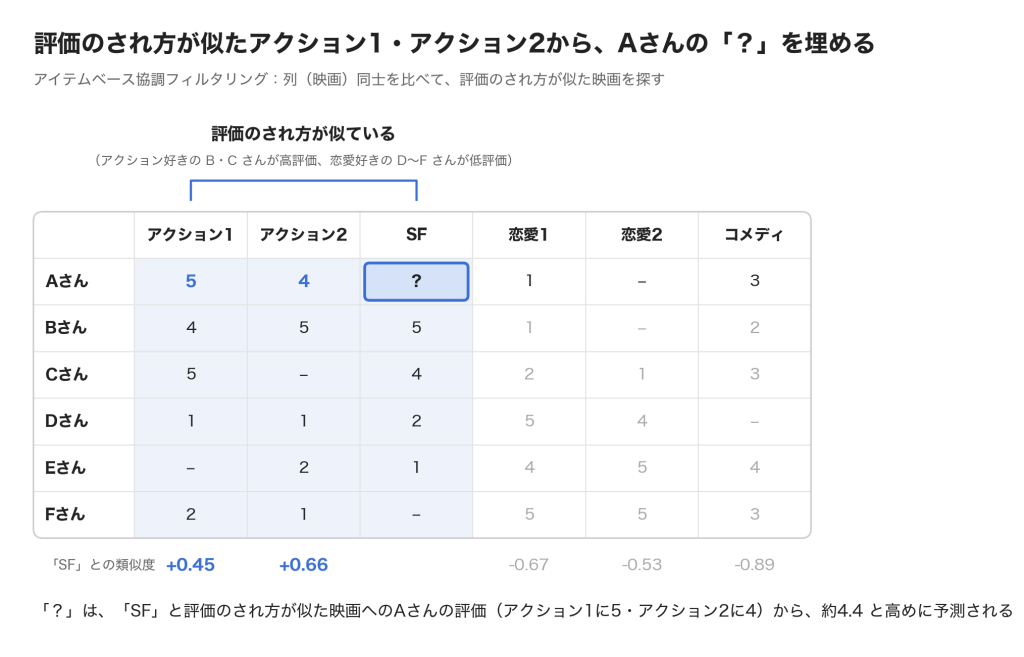
評価値行列の列同士を比べて、SFと評価のされ方が似た映画を探します。
SFは、アクション好きのBさん・Cさんが高く、恋愛好きのDさん・Eさんが低く評価しています。アクション1・2も同じ傾向で、類似度はプラス(+0.45、+0.66)になります。恋愛やコメディは逆の傾向で、類似度はマイナスです。
Aさんは、SFと似ているアクション1に星5、アクション2に星4をつけています。この2つの評価を類似度で重み付けして平均すると、AさんのSFは約4.4と高めに予測されます。
モデルベース
行列分解
モデルベースでは、既知の評価から規則性や好みの傾向をあらかじめモデルに学習させておき、まだ評価されていないマスの評価値を予測します。本稿では、代表的な手法の一つである行列分解を紹介します。
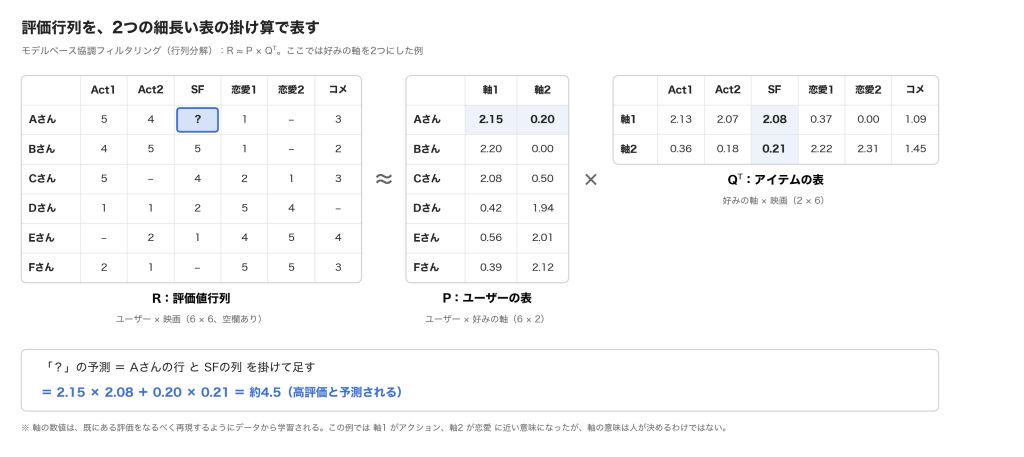
メモリベースと違い、行列分解は表全体から、ユーザーとアイテムを少数の「好みの軸」(数値の組)で表す方法を学習します。軸の数値は全員の評価から学ぶため、一人ひとりの評価が少なくても、他の人の評価を間接的に活かせます。そのため、評価値行列が疎でも比較的安定して予測できます。
モデルベース(MFの場合)の4ステップ
モデルベースの手法は多岐にわたり、手順も手法ごとに異なります。ここでは、その一例として行列分解(MF:Matrix Factorization)の場合の流れを紹介します。
- 行動を集める:評価、購入、閲覧などの履歴を、ユーザー×アイテムの表にまとめます。
- モデルを学習する:評価のあるマスだけを使って、ユーザーとアイテムをそれぞれ「好みの軸」の数値の組で表します。掛け戻した値が実際の評価に近づくように、数値を調整します。
- 空欄を予測する:ユーザーの数値の組とアイテムの数値の組を掛けて足し、空欄の予測値を出します。
- 並べて薦める:まだ評価していないアイテムを、予測値の高い順に表示します。
メモリベースとの違いは、手順2で「似ている度合いを測る」代わりに「あらかじめ学習しておく」ことです。そのため、推薦するときは手順3の掛け算だけで済みます。なお、深層学習を使う手法などでは、手順2と3の中身が変わります。
下の図では、好みの軸を2つにして、6×6の評価値行列を分解しています。Aさんの行(2.15, 0.20)とSFの列(2.08, 0.21)を掛けて足すと、AさんのSFは約4.5と予測されます。この例では軸1がアクション、軸2が恋愛に近い意味になりましたが、これは学習後に人が解釈したもので、あらかじめ決めたものではありません。
3. 発展と最新の応用
協調フィルタリングは、今も推薦の中心にあります。形を変えながら、最新の仕組みの土台になっているのです。
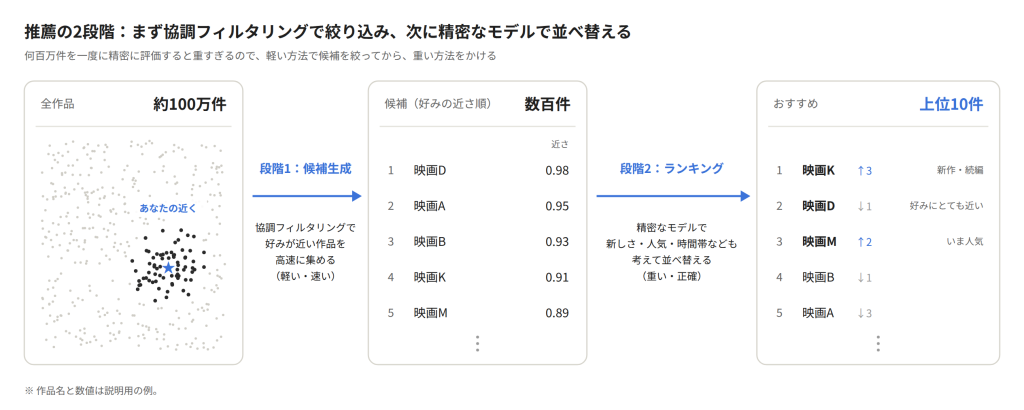
今の大規模サービスの多くは、推薦を2段階で行います。まず何百万件から数百件に候補を絞り、次に精密なモデルで並べ替えます。協調フィルタリングは、特に最初の絞り込みで活躍します。
他にも、協調フィルタリングを用いた手法として、以下のような手法が提案され続けています。
- 系列推薦(順番まで見る協調フィルタリング):「何を好んだか」に加え、「どの順番で見たか」も学習します。「この動画の次には、みんなこれを見ている」という発想です。
- グラフ推薦(評価値行列を網の目で見る):評価値行列は、人とアイテムを線で結んだ網の目とも見なせます。「似た人が好きな物を好きな人」のように、つながりを何段もたどれます。
- LLMとの組み合わせ(弱点を補う):協調フィルタリングは、履歴のない新作が苦手です。LLMの言葉の知識で、その穴を埋める試みが進んでいます。たとえば、LLMに利用者の立場で評価を生成させ、足りない評価データを補う研究があります。
4. 使用例と実績
現在の使われ方
今や協調フィルタリングは、EC、動画、音楽、ニュース、SNSなど、あらゆる分野に広がっています。単独で使われるより、他の手法と組み合わせるのが普通です。それでも「みんなの行動から学ぶ」という考え方は、多くのシステムの土台になっています。
Amazon
協調フィルタリングの成功例といえば、まずAmazonです。同社のアイテムベースの手法は、2003年の論文発表時点ですでに6年ほど本番で動いていました。
Netflix
Netflixでは、視聴時間の約80%が推薦経由です。同社は、パーソナライズと推薦による解約抑止の効果を、年間10億ドル以上と見積もっています。
YouTube
YouTubeは2016年、深層学習を使った推薦の仕組みを論文で公開しました。視聴履歴から候補を絞り、その後に並べ替える2段構えです。多くの企業が参考にした、現代の定番構成です。
5. 協調フィルタリングの利点と課題
メリット
- 中身の分析がいらない:行動の記録さえあれば、どんな分野にも使えます。
- 意外な出会いを生みやすい:ジャンルを超えて、「似た人が好んだもの」を薦められます。
- 感性を捉えられる:「なんとなく好き」のような、言葉にしにくい好みも反映されます。
- 使うほど賢くなる:利用者とデータが増えるほど、精度が上がりやすくなります。
最後の点は、ビジネス上の強みにもなります。利用者が多いサービスほど、推薦が良くなります。良い推薦がさらに利用者を呼ぶ、好循環が生まれます。
限界と課題
- コールドスタート:履歴のない新規ユーザーや新作は、推薦が難しくなります。
- データの疎らさ:一人が触れるのは全アイテムのごく一部なので、比べるための共通の評価が足りなくなりがちです。
- 規模の壁:手法にもよりますが、特にユーザーベースでは、利用者が増えるほど似た人探しの計算が重くなります。
- 人気の偏り:履歴の多い人気作ばかりが推薦されやすくなります。
- プライバシー:行動の記録は、その人らしさを強く表す個人情報でもあります。扱いには注意が必要です。
6. 技術の将来展望
今後の技術的な発展
- 行動の流れを読む:「何が好きか」に加え、「今何をしたいか」を捉える方向です。
- 長期的な満足を狙う:目先のクリックより、長く楽しんでもらえるかを重視します。
- 偏りを正す:人気作への偏りや、表示位置の影響を補正する研究が進んでいます。
他の新技術との連携
最も注目されているのが、大規模言語モデル(LLM)との組み合わせです。協調フィルタリングは行動の傾向を、LLMは言葉の意味を捉えるのが得意です。この2つを組み合わせて、次のような取り組みが進んでいます。
- コールドスタートの緩和:履歴のない新作でも、説明文から好みに合うかを推測できます。
- 対話型の推薦:「雨の日に聞きたい曲」のように、言葉で注文できるようになります。
- 推薦理由の説明:「なぜこれを薦めたのか」を、自然な文章で伝えられます。
7. まとめ
協調フィルタリングは、口コミをデータで自動化した技術です。その核心は「好みの似た人は、似たものを好む」という一文です。
技術は、メモリベースから行列分解、深層学習へと進化してきました。一方で、コールドスタートやプライバシーなどの課題も抱えています。今後はLLMとの組み合わせで、その弱点を補っていくでしょう。
次に「あなたへのおすすめ」を見たら、その裏側を少し想像してみてください。
参考文献
- 風間正弘・飯塚洸二郎・松村優也『推薦システム実践入門 ―仕事で使える導入ガイド』オライリー・ジャパン, 2022
- Linden, Smith, York, “Amazon.com Recommendations: Item-to-Item Collaborative Filtering”, IEEE Internet Computing, 2003
- Gomez-Uribe & Hunt, “The Netflix Recommender System: Algorithms, Business Value, and Innovation”, ACM Transactions on Management Information Systems, 2015
- Covington, Adams, Sargin, “Deep Neural Networks for YouTube Recommendations”, RecSys, 2016