はじめに
目的と背景
機械学習では「正解ラベルは正しい」という前提でモデルを学習します。しかし実際のデータでは、この前提が崩れることがあります。たとえば、次のような場面です。
- 人が手作業でラベルを付けていて、担当者ごとに判断がブレる
- ログや申告から自動でラベルを付けていて、誤りが混ざる
- 境界線上の事例で、専門家でも意見が割れる
ラベルの何%が間違っていると、精度は崩れ始めるのでしょうか。また、訓練データを丸暗記しやすいモデルほど、間違ったラベルに引きずられて弱いのでしょうか。体感ではなく数字で確かめたく、実験してみました。
試したことの概要
- 訓練データの正解ラベルを、一定の割合でわざと反転させる
- ノイズ率は0、5、10、20、30、40%の6通り
- ロジスティック回帰、RandomForest、KNNの3モデルで、きれいなテストデータの精度を比べる
- 乱数を変えて20回ずつ回し、平均をとる
環境設定
使用したツールとバージョン
Google Colab上で、Pythonとscikit-learnだけで動かします。データはscikit-learn付属のbreast_cancer(569件、30特徴量の二値分類)で、追加のダウンロードは要りません。バージョンは次のコードで確認できます。
import sklearn, numpy, pandas
print(sklearn.__version__, numpy.__version__, pandas.__version__)
初期設定と準備
ライブラリを読み込みノイズ率と繰り返し回数を設定します。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

NOISE_RATES = [0, 0.05, 0.10, 0.20, 0.30, 0.40]
N_SEEDS = 20
実験の設計で決めたこと
コードに入る前に、結果の読み方に関わる設計を3つ書いておきます。
- ノイズは訓練データのラベルだけ入れる。
→テストデータまで間違えると、「モデルが外した」のか「正解の方が間違っているのか」の区別ができなくなるためです。知りたいのは、汚れたラベルで学習したモデルが、本当の正解にどれだけ近いかです。 - 20回繰り返して平均をとる。
→データが569件と小さく、テストに入る171件の顔ぶれで精度が1ポイント程度ブレます。1回だけの結果だと、モデルの間の差が偶然かどうか判断できません。 - ノイズは完全にランダムにする。
→どの行が間違うかに偏りがない、最も単純な条件にしました。偏りのあるノイズは、この記事では扱いません。
実装手順
ステップ1:ラベルを反転させる関数
二値ラベルなので、選んだ行の0と1を入れ替えます。
def flip_labels(y, rate, rng):
    y_noisy = y.copy()
    n_flip = int(round(len(y) * rate))
    idx = rng.choice(len(y), size=n_flip, replace=False)
    y_noisy[idx] = 1 - y_noisy[idx]
    return y_noisy
ステップ2:モデルの準備
ロジスティック回帰とKNNは、特徴量のスケールに影響されるため、標準化を挟みます。RandomForestは、スケールの影響を受けないので標準化なしです。
def make_models():
    return {
        "LogisticRegression": make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)),
        "RandomForest": RandomForestClassifier(n_estimators=200, random_state=0, n_jobs=-1),
        "KNN (k=5)": make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5)),
    }
ステップ3:実験のループ
ノイズ率、モデル、乱数の組み合わせごとに、次の3つを記録します。
- test_acc:きれいなテストデータでの精度
- train_acc_noisy:ノイズ入りの訓練ラベルに対する訓練精度
- train_acc_true:本来の正しい訓練ラベルに対する訓練精度
X, y = load_breast_cancer(return_X_y=True)
records = []

for seed in range(N_SEEDS):
    rng = np.random.default_rng(seed)
    Xtr, Xte, ytr, yte = train_test_split(
        X, y, test_size=0.3, random_state=seed, stratify=y
    )
    for rate in NOISE_RATES:
        ytr_noisy = flip_labels(ytr, rate, rng)
        for name, model in make_models().items():
            model.fit(Xtr, ytr_noisy)
            records.append({
                "noise": rate, "model": name,
                "test_acc": model.score(Xte, yte),
                "train_acc_noisy": model.score(Xtr, ytr_noisy),
                "train_acc_true": model.score(Xtr, ytr),
            })

df = pd.DataFrame(records)
結果
10%まではどのモデルもほぼ耐える
テスト精度(20回の平均)は次のとおりです。
| ノイズ率 | Logistic Regression | Random Forest | KNN (k=5) |
| 0% | 97.4% | 96.0% | 96.5% |
| 5% | 96.0% | 96.0% | 96.1% |
| 10% | 94.7% | 95.2% | 95.2% |
| 20% | 92.8% | 93.9% | 90.4% |
| 30% | 89.0% | 88.9% | 79.8% |
| 40% | 75.9% | 74.8% | 64.5% |
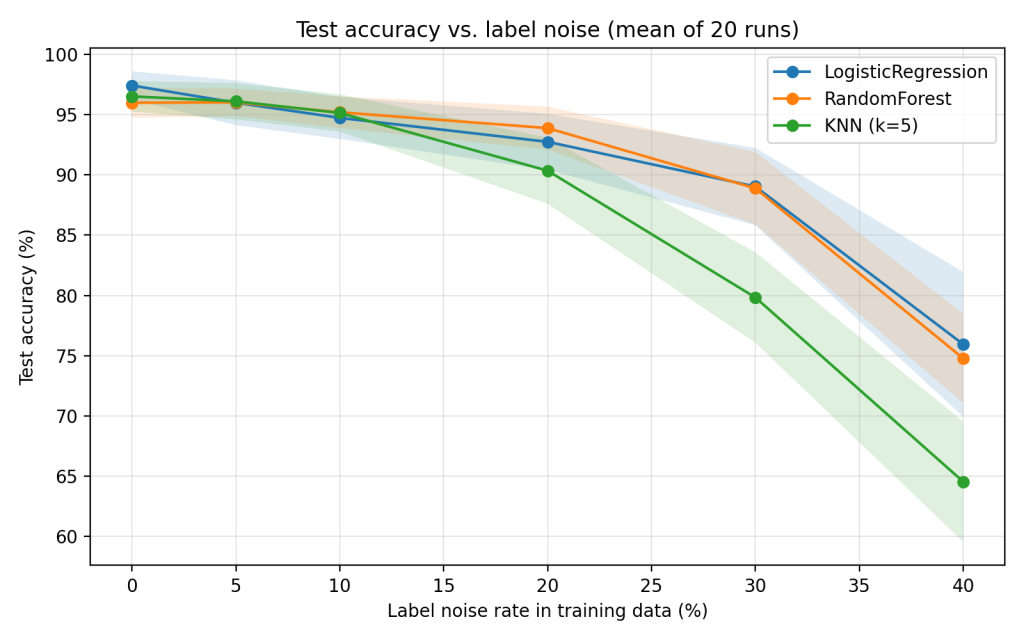
ノイズ0%から10%までの低下は、どのモデルも1~3ポイント程度でした。10件に1件のラベルが間違っていても、精度は数ポイントしか下がりません。この範囲のノイズなら、ラベルの修正に大きな手間をかける前に。他の改善を優先しても良さそうです。
この表は、モデルごとに0%の時点の精度が違う点にも注意が必要です。0%ではロジスティック回帰が最も高いため、「下がり幅」で比べると、ロジスティック回帰が不利に見えます。以降は、精度の絶対値と下がり幅の両方を見ます。
耐えた例:20%でも、RandomForestは約2ポイントの低下
ノイズ20%で、RandomForestの低下は約2ポイントでした。ロジスティック回帰は約5ポイント、KNNは約6ポイントまで下がっています。5件に1件のラベルが間違っていても、RandomForestはほとんど崩れません。
崩れた例:30%でKNNが約80%まで落ちる
ノイズ30%で、KNNは約80%まで落ちました。他の2つは約89%で、差が、10ポイント近くに開いています。40%では、どのモデルでも大きく落ちました。ラベルの4割が間違っている状態はほぼ当てずっぽうに近い領域です。
丸暗記しているのになぜ耐えるのか
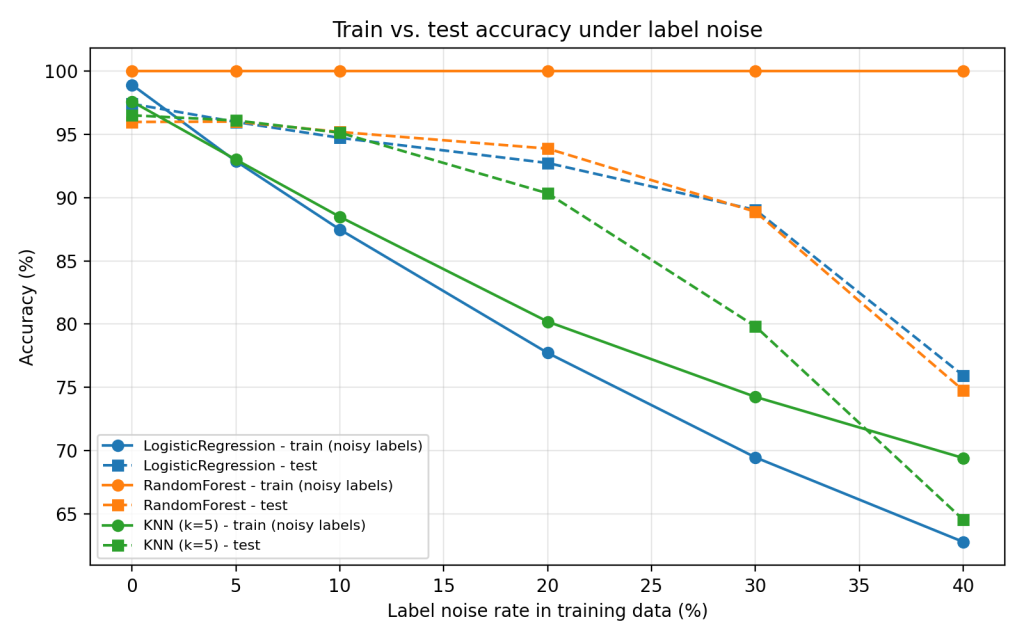
図2の実践は、ノイズ入りの訓練ラベルに対する訓練精度です。RandomForestはどのノイズ率でも訓練精度が100%のまま動きません。間違ったラベルまで覚えこんでいます。
ここで、訓練精度の見方を1つ整理します。モデルが「本当のパターン」だけを学んでいて、間違いを覚えていなければ、ノイズ入りのラベルに対する訓練精度は、おおよそ「100%-ノイズ率」になるはずです。
実験結果は次のとおりです。
| モデル(ノイズ20%) | ノイズ入りラベルでの訓練精度 | 正しいラベルでの訓練精度 | テスト精度 |
| LogisticRegression | 77.7% | 93.5% | 92.8% |
| RandomForest | 100.0% | 79.9% | 93.9% |
| KNN(k=5) | 80.2% | 91.9% | 90.4% |
- ロジスティック回帰とKNNは、ノイズ入りラベルでの訓練精度が約80%で、「100%-ノイズ率」とほぼ一致します。間違いをあまり覚えられないということです。
- RandomForestは100%です。間違いまで覚えています。それを裏付けるのが、正しいラベルで採点し直した約80%という数字です。覚えこんだ間違いのぶんだけ、本来の正解から外れています。
それでも、RandomForestのテスト精度は93.9%と、ノイズ20%では、3モデルの中で最も高くなりました。丸暗記しているのに、なぜ崩れないのでしょうか。
木の本数を変えてみる
RandomForestは決定木の多数決です。1本ずつの木は間違いを覚えて外しますが、覚える間違いは木ごとに違うので、多数決で打ち消し合うのではないかと考えました。ノイズ20%できの本数だけを変えて確かめます。
| モデル(ノイズ20%) | テスト精度 |
| 決定木 | 74.7% |
| RandomForest 10本 | 87.3% |
| RandomForest 50本 | 92.3% |
| RandomForest 200本 | 93.6% |
決定木1本は、ノイズなしの93.0%から約18ポイント崩れましたが、気を増やすほど精度が戻りました。「丸暗記しているのに崩れない」のは、木の数が多いからだと考えられます。
ただし、丸暗記が無害なわけではありません。葉に最低5件要求して丸暗記を抑えたRandomForest(min_samples_leaf=5)は、テスト精度が、94.6%と、さらに1ポイント高くなりました。
まとめ
丸暗記していても、テスト精度が崩れるとは限らない。RandomForestは、木を増やすほど、ノイズに強くなった。ただし、丸暗記を抑えた方が、少し高かった。
反省点
- データが易しい
→breast_cancerは、ノイズなしで精度が約97%に届く易しいデータです。難しいデータでは、同じノイズ率でも結果が変わる可能性があります。 - ノイズが単純すぎる
→二値分類で、完全にランダムなノイズだけを入れました。実際のラベルの間違いは、特定のクラスに偏ったり、紛らわしい事例に集中したりします。その場合は、多数決で打ち消し合う効果が弱まり、結果が変わるかもしれません。 - KNNの設定が1通りだけ
→kはk=5で試しました。「KNNは弱い」だけでなく、「k=5のKNNは、このデータでは先に崩れた」までしか言えません。