イントロダクション
クーポンをもらった顧客は、購入額が多い。ここから、2種類の問いが生まれます。
- 問い①: クーポンは購入額をどれだけ増やしているのか?
- 問い②: そもそも、購入額に影響しているのはクーポンなのか、顧客の優良度なのか、それとも別の要因なのか? 何が何の原因なのか?
問い①に答えるのが因果推論、問い②に答えるのが因果探索です。この記事ではこの2つの違いを整理します。
因果推論とは
因果推論とは「原因と結果の関係(因果の構造)についての仮定をおいたうえで、原因が結果に与える効果の大きさを推定する」手法の総称です。RCT(A/Bテスト)、DID、傾向スコア、操作変数法、RDDなどが含まれます。
- 入力: データと、因果の構造についての仮定(どの変数を調整すべきか、など)
- 出力: 効果の大きさ(たとえば、クーポンで、購入額が何円増えるか)
因果探索とは
因果探索とは「データから変数のあいだの因果の構造(どの変数がどの変数の原因か)を推定する」手法の総称です。
- 入力: 複数の変数の観察データ(あれば背景知識)
- 出力: 因果グラフ(変数をつなぐ矢印)
| 因果推論 | 因果探索 | |
|---|---|---|
| 問い | 原因は結果にどれだけ効くか | どの変数がどの変数の原因か |
| 入力 | データ + 因果の構造の仮定 | 複数の変数のデータ(+背景知識) |
| 出力 | 効果の大きさ | 因果グラフ(矢印) |
| 代表的な手法 | RCT、DID、傾向スコア、操作変数法、RDD | PC、GES、LiNGAM |
| 主な前提 | 交絡が調整できていることなど | マルコフ条件、忠実性、潜在的な交絡がないことなど |
例①:因果推論(因果グラフが分かっているとき)
顧客の「優良度」(低頻度層・高頻度層)が、「クーポンを受け取るか」と「購入額」の両方に影響しているとします。因果グラフは、「優良度 $\to$ クーポン」「優良度 $\to$ 購入額」「クーポン $\to$ 購入額」です。架空のデータ(単位は千円)は次のとおりです。
| 層 | 人数 | クーポンあり | クーポンなし | 平均購入額(あり) | 平均購入額(なし) |
|---|---|---|---|---|---|
| 低頻度層 | 100 | 20 | 80 | 3.0 | 2.0 |
| 高頻度層 | 100 | 80 | 20 | 9.0 | 8.0 |
- ① 単純に比べると: ありの平均 $\frac{20\times3.0 + 80\times9.0}{100}=7.8$、なしの平均 $\frac{80\times2.0 + 20\times8.0}{100}=3.2$ → 差は $+4.6$
- ② グラフを使うと: 優良度はクーポンと購入額の両方に影響する「交絡」です。優良度の層ごとに比べると、差は低頻度層で $+1.0$、高頻度層で $+1.0$ → 効果は $+1.0$
因果推論は、「優良度を調整すべきだ」という、因果グラフについての仮定を使って、効果の大きさ($+1.0$)を計算します。単純な比較の$+4.6$には、優良度の違いが混ざっています。
注意点:グラフの仮定が間違っていると結果も間違います。たとえば、優良度がクーポンと購入額の「結果」(両方から矢印が入る変数)だった場合は、優良度で層別するとかえって偏りが生じます。
例②:因果探索(因果グラフを探すとき)
今度は、因果グラフが分からないとします。X、Y、Zの3つの変数の観察データだけがあります。因果探索の代表的な手法であるPCアルゴリズムは、「条件付き独立」を手がかりにグラフを組み立てます。ここでは、条件付き独立を偏相関(Zの影響を取り除いた、XとYの相関)で調べます。
$$
r_{XY\cdot Z}=\frac{r_{XY}-r_{XZ}r_{YZ}}{\sqrt{(1-r_{XZ}^{2})(1-r_{YZ}^{2})}}
$$
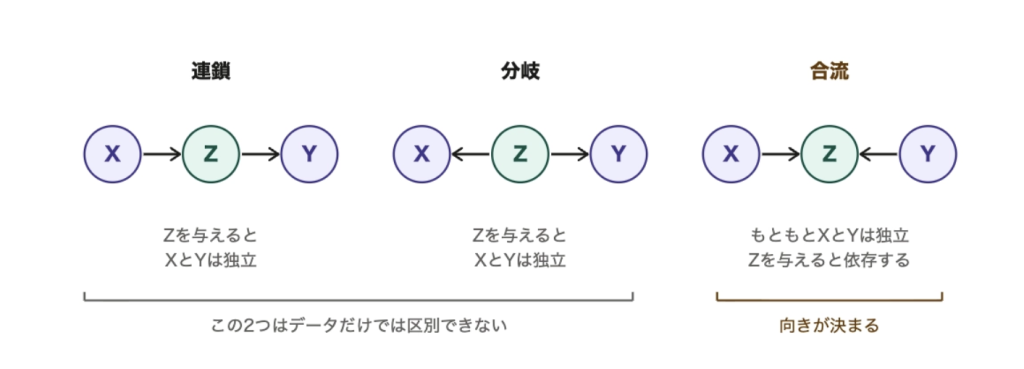
図1: 3つの構造と、条件付き独立のパターン。連鎖と分岐は同じパターン(Zを与えるとXとYが独立)になるため区別できない。合流だけが別のパターンになる。
- ケースA: $r_{XY}=0.6$、$r_{XZ}=0.8$、$r_{YZ}=0.75$ のとき、分子は $0.6-0.8\times0.75=0.6-0.6=0$ なので、偏相関は $0$ です。$Z$を与えると$X$と$Y$は独立なので$X$と$Y$を直接つなぐ辺は消えます。残る辺は、$X-Z$と$Z-Y$です。
- ケースB: $r_{XY}=0$、$r_{XZ}=0.6$、$r_{YZ}=0.6$ のとき、偏相関は $\frac{0-0.36}{1-0.36}=-0.5625$ です。$X$と$Y$はもともと独立なのに$Z$を与えると依存します。これは$Z$が$X$と$Y$の「結果」($X$と$Y$から矢印が入る合流点)のときに現れるパターンです。
ケースAは、$X\to Z\to Y$、$X\leftarrow Z\leftarrow Y$、$X\leftarrow Z\to Y$ のどれでも同じ条件付き独立のパターンになります。そのため、データだけでは矢印の向きを決められません(マルコフ同値類)。ケースBは、「XとYは独立、Zを与えると依存」というパターンが$X\to Z\leftarrow Y$ だけで説明できるため向きが決まります。
注意点:数値例①の優良度・クーポン・購入額の3変数はどの2つも関連があり、3つすべてが辺でつながります。このような場合は、矢印の向きをデータから区別できません。「優良度 → クーポン → 購入額」という時間の順序のような背景知識が必要になります。
2つの関係
因果探索は「因果グラフを見つける」手法、因果推論は「因果グラフを前提に、効果を測る」手法です。つなげて使うこともできます。
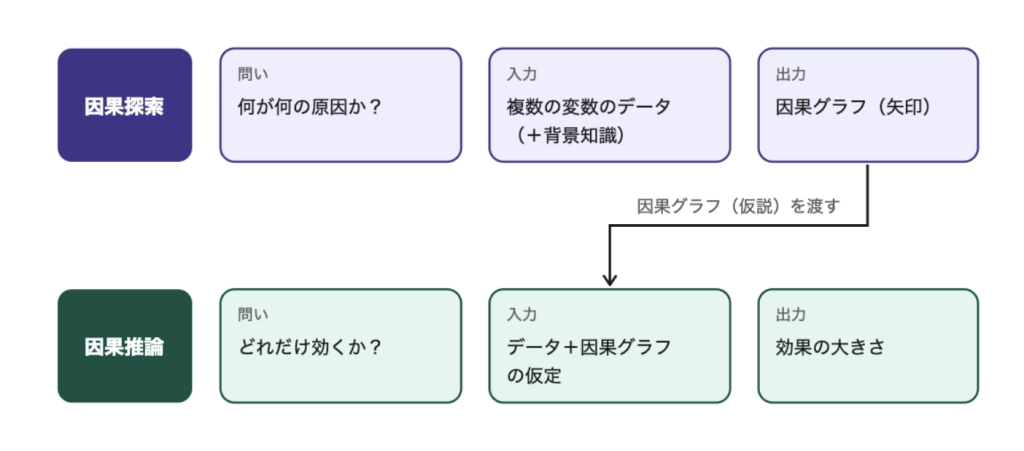
図2: 因果探索はデータから因果グラフを推定し、因果推論は因果グラフを前提に効果の大きさを求める。
注意点:因果探索で得たグラフは、「正解」ではなく「仮説」です。探索自体が強い前提を置いているため、その結果をそのまま因果推論の前提にすると、誤りが効果の推定に伝わります。実務では、領域知識(時間の順序など)でグラフを確認し補ってから、因果推論に使います。また因果探索は、因果推論に必ず必要なわけではありません。 因果推論では領域知識から因果グラフ(どの変数を調整するか)を決めることが一般的です。RCTならグラフを知らなくても効果を推定できます。
まとめ
- 因果推論: 因果グラフの仮定のもとで、「原因が結果にどれだけ効くか」を測る
- 因果探索: データから「何が何の原因か」(因果グラフ)を推定する
- 限界: 因果探索の結果は仮説。向きは同値類までしか決まらないことがある。因果推論はグラフが間違えば効果も間違う
- 使い方: 探索で候補を出し、領域知識で確認し、因果推論で効果を測る