
Google Cloud Compute Engine上のLinux VMで稼働するAPIデータ収集基盤で、「ターミナルでは成功するのに、cronでは動かない」という問題に遭遇しました。
直接原因は、crontabに記述した%sをcronが特殊文字として解釈したことです。
一方、SQL、条件判定、外部通信を1行のcrontabへ直接記述していたことも、障害を起こしやすく、原因を確認しにくくした構造的な要因でした。
本記事では、直接原因の特定に加え、監視処理をシェルスクリプトへ分離する案も紹介します。
なお、障害対応時に保存したログと作業記録をもとに再構成しています。
検証環境は、Google Cloud Compute Engine上のUbuntu 24.04 LTSです。cron 3.0pl1-184ubuntu2、SQLite 3.45.1を使用しています。
cronとSQLiteで実行していた死活監視の仕組み
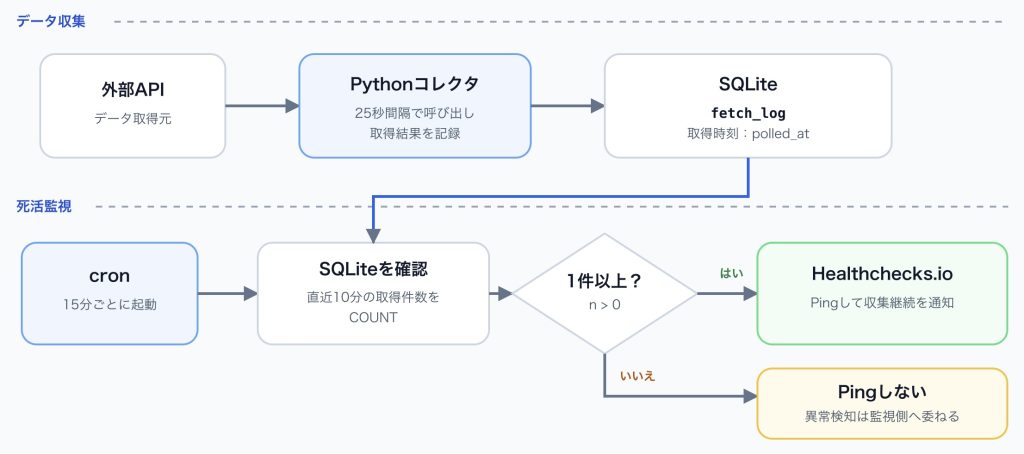
対象は、PythonコレクタがAPIを25秒間隔で呼び出すデータ収集基盤です。取得のたびに、結果をfetch_logテーブルへ記録していました。
SQLiteは、データを1つのファイルで扱える軽量なデータベースです。fetch_logの取得時刻polled_atから、収集が続いているかを確認できます。
監視にはcronとHealthchecks.ioを使いました。cronは、決めた時刻や間隔でコマンドを自動実行するLinuxの仕組みです。Healthchecks.ioは、定期的なPingが来なくなった場合に異常を検知する監視サービスです。
設計した監視処理は次のとおりです。
- cronが15分ごとに起動する
- SQLiteの
fetch_logを調べる - 直近10分以内の取得件数を数える
- 1件以上ならHealthchecks.ioへPingする
- 取得記録がなければPingしない
※なお、この設定では停止を即時に検知できず、停止した時刻によっては次回のcronでもPingされる場合があります。
障害発生時に登録されていた監視コマンドを匿名化すると、次のとおりです。以下は修正前の設定であり、そのまま使用しないでください。
*/15 * * * * n=$(sqlite3 /path/to/collector.db "SELECT COUNT(*) FROM fetch_log WHERE polled_at > strftime('%s','now')-600;"); [ "$n" -gt 0 ] && curl -fsS -m 10 "<HEALTHCHECKS_PING_URL>" >/dev/nullstrftime('%s','now')はSQLite単体では正しく、手動実行にも成功しました。しかしcron経由では自動Pingされなかったため、両者の違いを切り分けました。
cronは起動していたが、コマンドが途中で切れていた
syslogの確認
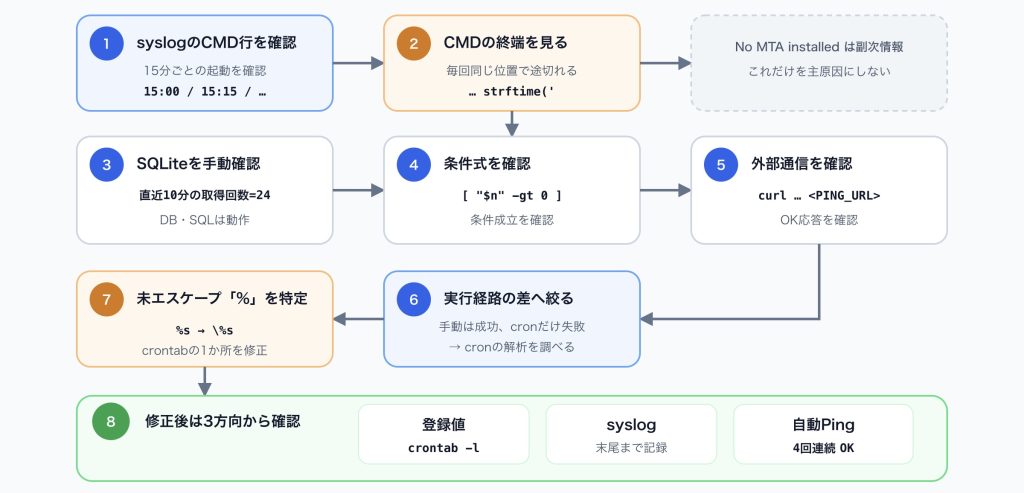
最初に確認したのは、ジョブが予定時刻に起動したかです。syslogは、OSやサービスの動作状況が記録されるログです。syslogには、次の記録が並んでいました。
15:00:01 (USER) CMD (... strftime(')
15:15:01 (USER) CMD (... strftime(')
15:30:01 (USER) CMD (... strftime(')※ログは機密情報を含まない形に匿名化し、日付、ホスト名、CRONのプロセスIDなどのプレフィックスを省略して整形しています。
15分ごとのCMD行から、cronジョブ自体は起動していたと分かります。しかし、コマンドは毎回同じstrftime('で途切れています。つまり、「起動した」と「処理全体が成功した」は別でした。
同時に、次のメッセージも記録されていました。
(CRON) info (No MTA installed, discarding output)No MTA installedは、メール転送エージェント(MTA)がないため、cronがジョブの出力をメール送信できず破棄したことを示す付随メッセージです。今回は、%によるコマンド分断で生じたエラー出力に伴って記録されたと考えられます。
No MTA installedは、今回のコマンド分断を発生させた直接原因ではありません。ただし、cronが出力したエラーをメールで受け取れず、破棄している状態は運用上のリスクです。
本番運用では、標準出力と標準エラーをログへ保存する、journaldやCloud Loggingへ転送する、またはメール通知を構成するなど、失敗時の出力を確認できる経路を用意する必要があります。
SQLite・条件分岐・外部通信を個別に確認
次に、一行のcronコマンドを「SQLite」「シェルの条件判定」「外部通信」に分けました。前半から順に単独で試すと、どこまで正常かを狭められます。
まず、cronを介さずにSQLiteクエリを実行しました。
n=$(sqlite3 /path/to/collector.db \
  "SELECT COUNT(*) FROM fetch_log WHERE polled_at > strftime('%s','now')-600;")

echo "直近10分の取得回数=$n"SQLiteの実行結果は24でした。続いて[ "$n" -gt 0 ]を確認し、件数が1件以上の場合に後続処理へ進む条件も成立しました。最後にcurlを単独で実行し、Healthchecks.ioからOKが返ることを確認しました。したがって、GCP VMからのHTTPS通信とPing URLの有効性も個別には問題ありませんでした。
ただし、手動実行の成功はcron経由の成功を証明しません。cronによるコマンド解析を通らないからです。ここでSQLite、条件分岐、Healthchecks.ioを原因候補から外し、「手動実行とcron実行の差」へ調査を絞れました。
原因はcrontabにおける%の特殊解釈だった
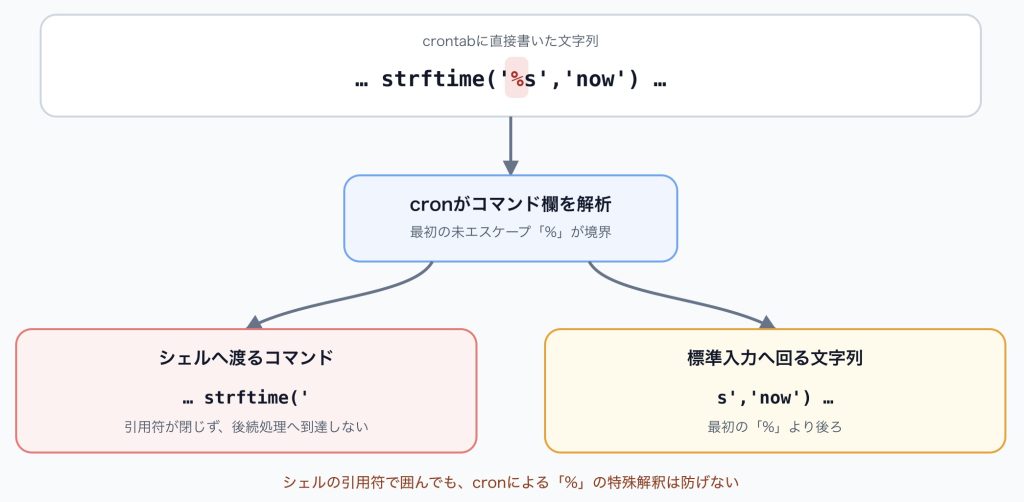
原因は、crontabのコマンド欄にあるエスケープされていない%です。crontab(5)の説明では、コマンド内の%はバックスラッシュでエスケープしない限り改行へ変換され、最初の%より後ろはコマンドの標準入力へ渡されるとされています。シェル向けの引用符で囲んでも、このcronの解釈は防げません。
修正前のSQLには、SQLiteとして正しい次の記述がありました。
strftime('%s','now')しかし、SQLiteへ届く前にcronが%を解釈します。その結果、シェルへ渡されるコマンドは次の位置で分断されました。
strftime('シェルへ渡された文字列には、SQLを囲んでいたダブルクォートやコマンド置換の)が欠け、構文解析の段階で処理が終了します。そのため、SQLiteクエリ、条件判定、curlはいずれも実行されず、Healthchecks.ioへのPingも送られませんでした。
暫定復旧としてcrontab内の%sを\%sへ修正
最小修正は、crontab内の%sだけを\%sへ変えることです。
- strftime('%s','now')
+ strftime('\%s','now')
修正後のcrontabは次の形です。
*/15 * * * * n=$(sqlite3 /path/to/collector.db "SELECT COUNT(*) FROM fetch_log WHERE polled_at > strftime('\%s','now')-600;"); [ "$n" -gt 0 ] && curl -fsS -m 10 "<HEALTHCHECKS_PING_URL>" >/dev/nullこれはSQLiteのSQL仕様を変更するものではありません。cronによる分断を防ぎ、SQLiteへ通常の%sを渡すためのエスケープです。
修正後は設定・syslog・自動Pingを確認
修正後は、まず登録内容そのものを確認しました。
crontab -l | grep strftime次の文字列が登録されていました。
strftime('\%s','now')続いて、自動実行後のsyslogを確認しました。
grep 'CRON.*CMD' /var/log/syslog \
  | grep -F 'sqlite3 /path/to/collector.db' \
  | tail -n 5
grep CRONだけでは、同じサーバーで動く別のcronジョブが結果に混ざる可能性があります。対象のDBパスやスクリプト名など、そのジョブを識別できる文字列でも絞り込みます。
結果は、コマンドがstrftime('で途切れず、末尾の>/dev/nullまで記録されていました。これにより、cronによるコマンド分断が解消したことを確認できました。
なお、syslogではstrftime('%s','now')のようにバックスラッシュなしで表示される場合があります。cronがエスケープを処理してからシェルへ渡すためです。crontabに登録された値は、syslogではなくcrontab -lで確認します。
そこで、処理が最後まで実行されたかを確かめるため、Healthchecks.ioの受信履歴も確認しました。16:30、16:45、17:00、17:15の4回が15分間隔でOKと記録され、チェック状態もupへ復帰していました。
これにより、cronの起動、SQLiteクエリ実行、件数の取得、条件判定の成立、curlの実行、Healthchecks.ioによるPingの受信まで、一連の処理が動いたと判断しました。
再発防止案として監視処理をシェルスクリプトへ分離
\%sへの変更で今回の障害は解消できます。しかし、複数の処理をcrontabへ直接記述する構成では、引用符や特殊文字による問題が再発する可能性があります。そのため、最小修正とは別に、監視処理をシェルスクリプトへ分離することを再発防止案としました。
%sの書き方は、実行する場所によって異なります。
| 実行場所 | 書き方 | 理由 |
|---|---|---|
| ターミナル | %s | cronによる解析を受けない |
| crontabのコマンド欄 | \%s | cronによる%の解釈を防ぐ |
| シェルスクリプト | %s | スクリプトの内容はcronが直接解析しない |
複雑な処理は、次のようにシェルスクリプトへ分離できます。
#!/usr/bin/env bash
set -eu

DB_PATH="/path/to/collector.db"
PING_URL="<HEALTHCHECKS_PING_URL>"

count=$(sqlite3 "$DB_PATH" \
  "SELECT COUNT(*) FROM fetch_log WHERE polled_at > strftime('%s','now')-600;")

if [ "$count" -gt 0 ]; then
  curl -fsS -m 10 "$PING_URL" >/dev/null
fi
crontabには、スクリプトの呼び出しだけを記述します。
*/15 * * * * /path/to/check_collector.sh >> /path/to/check_collector.log 2>&1cronが直接解析するのは、crontabのコマンド欄です。呼び出されたスクリプトの内容まで同じ方法で解析するわけではないため、スクリプト内では通常の%sを使用できます。
2>&1を指定すると、標準出力と標準エラーを同じログへ残せます。スクリプト単体で手動テストできるほか、引用符やエスケープのミスを減らし、Gitで変更履歴を管理しやすくなる点も利点です。
まとめ
今回の障害対応から得た教訓は、次の3点です。
- crontabのコマンド欄で
%を使う場合は、\%のようにエスケープする - SQLや条件分岐を含む処理はシェルスクリプトへ分離する
- cronの起動だけでなく、エラー出力と処理結果まで確認できる経路を用意する
手動実行が成功しても、cronによるコマンド解析を通した実行が成功するとは限りません。syslogでコマンドの途切れ方を確認し、処理を構成要素ごとに切り分けたことが、原因の特定につながりました。
参考文献
- Canonical, crontab(5) — Ubuntu 24.04 LTS 日本語マニュアル(日本語)
- SQLite, Date And Time Functions(英語)
- Healthchecks.io, How to Monitor Cron Jobs with Healthchecks.io(英語)
- Healthchecks.io, Pinging API(英語)