はじめに
生成モデルとは
生成モデルとは、データの分布を学習し、新しいデータを生成するモデルです。前回の記事ではその最もシンプルな実装としてマルコフ連鎖を取り上げました。
マルコフ連鎖との関係
簡単な復習
マルコフ連鎖は「直前のN文字から次の文字の確率を求め、サンプリングして文章を生成する」モデルでした。外部ライブラリ不要で実装でき、生成モデルの本質である「確率分布からのサンプリング」を体感できます。
マルコフ連鎖の課題感
マルコフ連鎖には根本的な限界があります。
- 文脈が短い: 直前のN文字しか参照できない
- コーパス外を生成できない: 学習データにない組み合わせは出力不可能
- 意味を理解しない: 確率の高低を覚えているだけ
RNNはこの「文脈が短い」問題をニューラルネットワークで解決します。
問題設定
問題設定
前回と同様に「日本語テキストの生成」を問題として扱います。コーパスは夏目漱石「吾輩は猫である」の冒頭10文(253文字)です。
何を目的にしているか
RNNが持つ**隠れ状態(hidden state)**という「記憶」の仕組みを理解し、マルコフ連鎖との違いを実装レベルで確認することが目的です。
RNNとは
RNNの概要
RNN(Recurrent Neural Network:リカレントニューラルネットワーク)は、系列データを処理するためのニューラルネットワークです。最大の特徴は隠れ状態という記憶を持ち、過去の情報を引き継ぎながら処理できる点です。
マルコフ連鎖:  [吾][輩] → 次の文字   (直前2文字のみ参照)

RNN:  [吾][輩][は][猫][で][あ][る] → 次の文字
        ↑ 過去の全文脈を隠れ状態として蓄積 ↑
RNNの仕組み
順伝播(Forward Pass)
RNNは各タイムステップで以下の計算を行います。
h_t = tanh(W_h × h_{t-1} + W_x × x_t + b)
y_t = W_y × h_t

h_t    : 現在の隠れ状態(記憶)
h_{t-1}: 前のタイムステップの隠れ状態(過去の記憶)
x_t    : 現在の入力文字(埋め込みベクトル)
y_t    : 次の文字の予測スコア(ロジット)
入力文字を受け取るたびに隠れ状態が更新され、過去の文脈が蓄積されていきます。
逆伝播(Backpropagation Through Time)
RNNの逆伝播(BPTT)を理解するためには、まず「$W_h$ が全ステップで共有されている」ことが重要です。
$$
h_1 = \tanh(W_h h_0 + W_x x_1)
$$
$$
h_2 = \tanh(W_h h_1 + W_x x_2)
$$
$$
h_3 = \tanh(W_h h_2 + W_x x_3)
$$
いずれも同じ $W_h$ を使用しています。$W_h$ は全ステップで使い回されているため、「$W_h$ を少し変えたとき、損失にどう影響するか」を求めるには全ステップへの影響を足し合わせる必要があります。以下では、なぜ足し算になるのかを省略せずに追っていきます。
0. 記号の整理
各ステップの計算を次のように分解しておきます。$z_t$ は活性化関数に入る前の値です。
$$
z_t = W_h h_{t-1} + W_x x_t + b
$$
$$
h_t = \tanh(z_t)
$$
$$
L = L_1 + L_2 + L_3
$$
(実際の実装では20ステップですが、ここでは仕組みが見えやすいよう3ステップで考えます。また $h_0$ は初期値であり、$W_h$ に依存しない定数として扱います。)
求めたいのは $\dfrac{\partial L}{\partial W_h}$ です。$L$ が和の形をしているので、微分の線形性よりまず次のように分解できます。
$$
\frac{\partial L}{\partial W_h} = \frac{\partial L_1}{\partial W_h} + \frac{\partial L_2}{\partial W_h} + \frac{\partial L_3}{\partial W_h}
$$
この右辺の3項を、それぞれ計算していきます。
1. ステップ1(t=1): 経路は1本だけ
$L_1$ の依存関係は $L_1 \leftarrow h_1 \leftarrow z_1$ なので、連鎖律より次の形が成り立ちます。
$$
\frac{\partial L_1}{\partial W_h} = \frac{\partial L_1}{\partial h_1}\cdot\frac{\partial h_1}{\partial z_1}\cdot\frac{\partial z_1}{\partial W_h}
$$
$z_1 = W_h h_0 + W_x x_1 + b$ において、$h_0$ は定数なので $W_h$ が登場するのは1箇所だけです。
$$
\frac{\partial z_1}{\partial W_h} = h_0^{\top}
$$
よって:
$$
\frac{\partial L_1}{\partial W_h} = \left(\frac{\partial L_1}{\partial h_1}\odot\frac{\partial h_1}{\partial z_1}\right)h_0^{\top}
$$
ここで、右辺のうち先頭の $\dfrac{\partial L_1}{\partial h_1}$ を除いた部分は、実はそのまま $\dfrac{\partial h_1}{\partial W_h}$($h_1$ を $W_h$ で直接微分したもの)にもなっています。この副産物を次のステップで使い回します。
$$
\frac{\partial h_1}{\partial W_h} = \frac{\partial h_1}{\partial z_1}\odot h_0^{\top}
$$
2. ステップ2(t=2): 経路が2本に増える
$L_2$ も出発点は同じ形です。
$$
\frac{\partial L_2}{\partial W_h} = \frac{\partial L_2}{\partial h_2}\cdot\frac{\partial h_2}{\partial z_2}\cdot\frac{\partial z_2}{\partial W_h}
$$
違いが出るのは最後の項です。$z_2 = W_h h_1 + W_x x_2 + b$ ですが、今回は $h_1$ が定数ではなく $W_h$ の関数($h_1=\tanh(W_h h_0 + W_x x_1+b)$)です。そのため「$W_h$ 自身」と「$h_1$ の中の $W_h$」という2箇所が登場し、次のように展開されます。
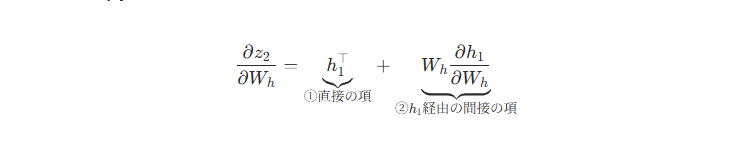
①は「$W_h h_1$ の掛けている方の $W_h$」を $h_1$ を定数とみなして微分した項、②は $h_1$ の中身にも $W_h$ が埋め込まれていることによる項です。②の $\dfrac{\partial h_1}{\partial W_h}$ は、ステップ1の最後で計算済みのものをそのまま使えます。
$$
\frac{\partial z_2}{\partial W_h} = h_1^{\top} + W_h\left[\frac{\partial h_1}{\partial z_1}\odot h_0^{\top}\right]
$$
まとめると:
$$
\frac{\partial L_2}{\partial W_h} = \left(\frac{\partial L_2}{\partial h_2}\odot\frac{\partial h_2}{\partial z_2}\right)\left(h_1^{\top} + W_h\left[\frac{\partial h_1}{\partial z_1}\odot h_0^{\top}\right]\right)
$$
この式を展開すると2つの項が出てきます。これが「経路が2本になる」ことの正体です。同様に、ここでも副産物として $\dfrac{\partial h_2}{\partial W_h}$ が計算でき、次のステップで再利用します。
3. ステップ3(t=3): 経路が3本になる
$L_3$ も出発点は同じ形です。
$$
\frac{\partial L_3}{\partial W_h} = \frac{\partial L_3}{\partial h_3}\cdot\frac{\partial h_3}{\partial z_3}\cdot\frac{\partial z_3}{\partial W_h}
$$
最後の項を計算します。$z_3 = W_h h_2 + W_x x_3 + b$ で、$h_2$ もまた $W_h$ の関数($h_2=\tanh(W_h h_1 + W_x x_2+b)$)なので、ステップ2と同じ理屈で「$W_h$ 自身」と「$h_2$ の中の $W_h$」の2箇所が現れ、次のように展開されます。
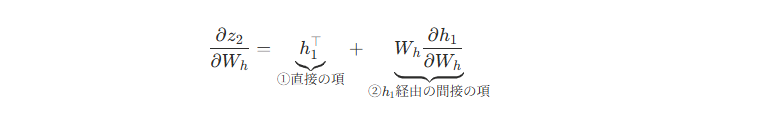
②の $\dfrac{\partial h_2}{\partial W_h}$ は、ステップ2の最後で計算済みの副産物をそのまま使います。
$$
\frac{\partial h_2}{\partial W_h} = \frac{\partial h_2}{\partial z_2}\odot\left(h_1^{\top} + W_h\left[\frac{\partial h_1}{\partial z_1}\odot h_0^{\top}\right]\right)
$$
これを代入すると:
$$
\frac{\partial z_3}{\partial W_h} = h_2^{\top} + W_h\left(\frac{\partial h_2}{\partial z_2}\odot\left(h_1^{\top} + W_h\left[\frac{\partial h_1}{\partial z_1}\odot h_0^{\top}\right]\right)\right)
$$
よって:
$$
\frac{\partial L_3}{\partial W_h} = \left(\frac{\partial L_3}{\partial h_3}\odot\frac{\partial h_3}{\partial z_3}\right)\left(h_2^{\top} + W_h\left(\frac{\partial h_2}{\partial z_2}\odot\left(h_1^{\top} + W_h\left[\frac{\partial h_1}{\partial z_1}\odot h_0^{\top}\right]\right)\right)\right)
$$
これを展開すると、$\dfrac{\partial L_3}{\partial W_h}$ の中には3つの項が入れ子で出てきます。$t$ が増えるたびに、$W_h$ が埋め込まれている箇所の数だけ項が1つずつ増えていくのが分かります。
4. パターンの一般化:なぜ足し算なのか
ここまでの計算はすべて、次の共通の形から始まっていました。
$$
\frac{\partial L_t}{\partial W_h} = \frac{\partial L_t}{\partial h_t}\cdot\frac{\partial h_t}{\partial z_t}\cdot\frac{\partial z_t}{\partial W_h}
$$
違いは最後の項 $\dfrac{\partial z_t}{\partial W_h}$ をどこまで再帰的に展開するかだけです。これは「同じ変数 $W_h$ が複数の箇所($t=1,\dots,t$)に埋め込まれた合成関数を微分すると、埋め込まれた箇所の数だけ和が生まれる」という多変数の連鎖律(全微分)の性質そのものです。整理すると、すべての項は次の形にまとめられます($k$ は「$W_h$ が直接使われている時刻」)。
$$
\frac{\partial L_t}{\partial W_h} = \sum_{k=1}^{t}\frac{\partial L_t}{\partial h_t}\cdot\frac{\partial h_t}{\partial h_k}\cdot\left(\frac{\partial h_k}{\partial z_k}\odot h_{k-1}^{\top}\right)
$$
$$
\frac{\partial h_t}{\partial h_k} = \prod_{i=k+1}^{t}\left[\frac{\partial h_i}{\partial z_i}\odot W_h\right], \qquad \frac{\partial h_t}{\partial h_t}=1
$$
5. 全ステップを足し合わせて最終形にまとめる
最初の分解 $\frac{\partial L}{\partial W_h}=\sum_t \frac{\partial L_t}{\partial W_h}$ に上の式を代入すると、$t$ と $k$ についての二重の和($1\le k\le t\le T$)になります。
$$
\frac{\partial L}{\partial W_h} = \sum_{t=1}^{T}\sum_{k=1}^{t}\frac{\partial L_t}{\partial h_t}\cdot\frac{\partial h_t}{\partial h_k}\cdot\left(\frac{\partial h_k}{\partial z_k}\odot h_{k-1}^{\top}\right)
$$
$k$ を固定して $t=k,\dots,T$ を先に足すと、その中括弧の中身がちょうど「BPTTで逆順に計算する $\dfrac{\partial L}{\partial h_k}$」の定義そのものになります($h_k$ は $k$ 番目以降のすべての損失に影響するため)。
$$
\frac{\partial L}{\partial W_h} = \sum_{k=1}^{T}\left[\sum_{t=k}^{T}\frac{\partial L_t}{\partial h_t}\cdot\frac{\partial h_t}{\partial h_k}\right]\cdot\left(\frac{\partial h_k}{\partial z_k}\odot h_{k-1}^{\top}\right) = \sum_{t=1}^{T}\left(\frac{\partial L}{\partial h_t}\odot\frac{\partial h_t}{\partial z_t}\right)h_{t-1}^{\top}
$$
これが最終的な勾配の式です。$L=\sum_t L_t$ という損失の定義による和と、$W_h$ が全時刻に埋め込まれていることによる連鎖律の和、この2つの和が整理されて、見た目には時刻についての1つの和にまとまっています。
全ステップの損失を使った最終的な更新
各ステップの損失 $L_1$〜$L_{20}$ それぞれから同様に $W_h$ への勾配を計算し、全て足し合わせたものが最終的な勾配です。
$$
\frac{\partial L}{\partial W_h} = \frac{\partial L_1}{\partial W_h} + \frac{\partial L_2}{\partial W_h} + \cdots + \frac{\partial L_{20}}{\partial W_h}
$$
$$
W_h \leftarrow W_h – \eta\,\frac{\partial L}{\partial W_h}
$$
($\eta$ は学習率)これを1エポックごとに1回行います。PyTorch では loss.backward() が全経路の勾配を自動計算し、optimizer.step() が上記の更新式を実行します。
勾配消失問題
ここで注意したいのは、「情報が消える」ことと「勾配(学習信号)が消える」ことは別物だという点です。
フォワード(情報の伝わり方)では、$h_1 \to h_2 \to \cdots \to h_{20}$ という連鎖があるため 1文字目の情報は($\tanh$ で圧縮されながらも)$h_{20}$ まできちんと伝わっており、情報自体が消えているわけではありません。問題はバックワード(勾配の伝わり方)の方です。$k<t$ のとき $\dfrac{\partial L_t}{\partial h_k}$ を求めるには、$h_k$ から $h_t$ まで連鎖律で $(t-k)$ 回もヤコビアンを掛け合わせる必要があります。
$$
\frac{\partial L_t}{\partial h_k} = \frac{\partial L_t}{\partial h_t}\cdot\prod_{i=k+1}^{t}\frac{\partial h_i}{\partial h_{i-1}}, \qquad \frac{\partial h_i}{\partial h_{i-1}} = \frac{\partial h_i}{\partial z_i}\odot W_h
$$
各因子 $\dfrac{\partial h_i}{\partial h_{i-1}}$ の大きさが1未満($\tanh$ の微分は最大でも1未満)だとすると、$(t-k)$ 回の掛け算で値は指数的に減衰します。
$$
\left\|\frac{\partial h_i}{\partial h_{i-1}}\right\| \approx 0.5 \quad\Longrightarrow\quad \left\|\prod_{i=k+1}^{t}\frac{\partial h_i}{\partial h_{i-1}}\right\| \approx 0.5^{\,t-k}
$$
$$
0.5^{1} = 0.50, \qquad 0.5^{5} \approx 0.03, \qquad 0.5^{20} \approx 0.001
$$
つまり、$h_1$ は $L_{20}$ の計算(フォワード)にはちゃんと使われているのに、「$h_1$ をどう調整すれば $L_{20}$ が改善するか」を教える勾配 $\dfrac{\partial L_{20}}{\partial h_1}$ はほぼゼロになってしまいます。
前節で導いた最終形を思い出すと:
$$
\frac{\partial L}{\partial W_h} = \sum_{k=1}^{T}\left[\sum_{t=k}^{T}\frac{\partial L_t}{\partial h_t}\cdot\frac{\partial h_t}{\partial h_k}\right]\cdot\left(\frac{\partial h_k}{\partial z_k}\odot h_{k-1}^{\top}\right)
$$
内側の和 $\sum_{t=k}^{T}\dfrac{\partial L_t}{\partial h_t}\cdot\dfrac{\partial h_t}{\partial h_k}$ を見ると、$t-k$ が大きい項($k$ から遠い未来の損失)ほど $\dfrac{\partial h_t}{\partial h_k}$ の減衰によりほとんど寄与しなくなります。言い換えると、$k$ が系列のどの位置にあっても「1〜数ステップ先の損失」からの勾配は減衰なく届きますが、「何十ステップも先(または前)の損失」との関係を学習する信号だけが、その隔たりの大きさに応じて指数的に弱くなります。これが勾配消失問題であり、RNNが長い文脈(遠い依存関係)を学習しにくい根本的な原因です。
実験
実験データ
夏目漱石「吾輩は猫である」の冒頭10文をコーパスとして使用します。文字種は74種類です。
"""
吾輩は猫である。名前はまだない。
どこで生れたか頓と見当がつかぬ。
何でも薄暗いじめじめした所でニャーニャー泣いていた事だけは記憶している。
吾輩はここで始めて人間というものを見た。
しかもあとで聞くとそれは書生という人間中で一番獰悪な種族であったそうだ。
この書生というのは時々我々を捕えて煮て食うという話である。
吾輩は猫である。猫の名前は何でもいい。
猫はどこでも寝ることができる。猫は自由な生き物だ。
人間は猫を見て笑う。猫は人間を見て考える。
吾輩は考える猫である。考えることは生きることだ。
"""
トークン化
マルコフ連鎖と同様に文字単位でトークン化します。ただしRNNでは文字をそのまま扱わず、インデックスに変換してから**埋め込み(Embedding)**で密なベクトルに変換します。
chars = sorted(set(corpus))        # 語彙: 74文字
char2idx = {ch: i for i, ch in enumerate(chars)}  # 文字→インデックス
idx2char = {i: ch for ch, i in char2idx.items()}  # インデックス→文字
学習方法
RNNは1文字ずつ順番に処理します。20文字を一括で入れて20文字が出てくるのではありません。
ステップ1: 「吾」を入力 → 「輩」を予測 → 損失L₁を計算
             ↓ 隠れ状態h₁を次へ引き継ぐ
ステップ2: 「輩」を入力 → 「は」を予測 → 損失L₂を計算
             ↓ 隠れ状態h₂を次へ引き継ぐ
ステップ3: 「は」を入力 → 「猫」を予測 → 損失L₃を計算
             ↓
          ...(20ステップ繰り返す)
             ↓
全ステップの損失を合計 → パラメータ更新
入力
各ステップで1文字を入力します。学習時は長さ20のシーケンスを用意し、先頭から1文字ずつ順番に入力します。
入力(1文字ずつ処理):
ステップ1: 「吾」
ステップ2: 「輩」
ステップ3: 「は」
  ...
ステップ20: 「生」
出力
各ステップで**1文字の予測スコア(74次元)**を出力します。正解は入力を1文字後ろにずらしたものです。今回は文字数が74なので74次元に対応した確率を出力します。
ステップ1の正解: 「輩」
ステップ2の正解: 「は」
ステップ3の正解: 「猫」
  ...
ステップ20の正解: 「れ」
モデルは「現在の文字と過去の隠れ状態から、次の文字を予測する」タスクとして学習します。
モデル定義
class CharRNN(nn.Module):
    def __init__(self, vocab_size, embed_dim, hidden_dim):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim)   # 74 → 32次元
        self.rnn = nn.RNN(embed_dim, hidden_dim, batch_first=True)  # 32 → 128次元
        self.fc = nn.Linear(hidden_dim, vocab_size)            # 128 → 74次元
各層の役割は以下のとおりです。
| 層 | 入力次元 | 出力次元 | 役割 |
|---|---|---|---|
| Embedding | 74(インデックス) | 32 | 文字を密なベクトルに変換 |
| RNN | 32 | 128 | 隠れ状態として文脈を蓄積 |
| Linear | 128 | 74 | 各文字のスコアを出力 |
損失推移
300エポック学習した際の損失の推移です。
Epoch   1: 4.3357  (ほぼランダムな予測)
Epoch  50: 0.2062  (急速に学習が進む)
Epoch 100: 0.1253
Epoch 150: 0.1045
Epoch 200: 0.0791  (最小値付近)
Epoch 250: 0.0996
Epoch 300: 0.1063
学習初期に損失が急激に下がり、その後緩やかに収束しています。
生成結果
学習済みモデルに「吾」を入力として与え、temperatureを変えて生成した結果です。
temperature = 0.5(保守的)
[1] 吾輩は猫である。名前はまだない。
[2] 吾輩はここで始めて人間というものを見た。
[3] 吾輩は考える猫である。
コーパスに忠実な文章が生成されています。
temperature = 1.0(標準)
[1] 吾輩は猫である。猫の名前は何でもいい。
[2] 吾輩は考える猫である。
[3] 吾輩は考える猫である。
temperature = 1.5(創造的)
[1] 吾輩は考えある。吾輩は猫で名る。
[2] 吾輩は猫である。事こ名前を泣てていた考える。
[3] 吾輩はしかは猫でニャーニャーニャー泣いていた事だけは記憶している。
temperatureを上げると文法的に崩れた文章が出てきます。これはコーパスが少ないため、低確率の遷移が選ばれると未学習の組み合わせになるためです。
終わりに
RNNの隠れ状態は過去の全文脈を蓄積できますが、「1つのベクトルに圧縮する」という制約から長期依存の学習が難しいという問題があります。
次の記事では、まったく異なるアプローチで生成モデルを実装します。**VAE(変分オートエンコーダ)**は文章を逐次生成するのではなく、文章全体を潜在空間上のベクトルに圧縮し、そこからデコードする方式です。潜在空間上での補間など、RNNにはできない操作が可能になります。