メタ学習器とは
A/Bテストやマーケティング施策の分析では、多くの場合、施策全体の平均効果である平均処置効果(Average Treatment Effect, ATE)が報告されます。しかし実務では、「この施策は誰に効果があり、誰には効果がないのか」という効果の個人差が重要です。
この個人差は、条件付き平均処置効果(Conditional Average Treatment Effect, CATE)と呼ばれます。
ここで、各記号は次の意味を持ちます。
- $Y(1)$:処置を受けた場合の潜在的結果
- $Y(0)$:処置を受けなかった場合の潜在的結果
- $X$:個体の属性や特徴量
- $\tau(x)$:特徴量が $x$ である個体の平均的な処置効果
ただし実際のデータでは、各個体について $Y(1)$ と $Y(0)$ のどちらか一方しか観測できません。
メタ学習器(meta-learner)は、この推定問題を、回帰木・勾配ブースティング・ニューラルネットワークなどの任意の機械学習モデルを組み合わせて解くための枠組みです。代表的な手法にはS-Learner、T-Learner、X-Learner、R-Learnerなどがあります。本記事では、基本的なT-Learnerと、その弱点を補うX-Learnerを扱います。
例:クーポン配布問題
あるECサイトが、一部の顧客にだけ割引クーポンを配布したとします。
- 処置群:クーポンを配布した顧客($W=1$)
- 対照群:クーポンを配布しなかった顧客($W=0$)
- 結果:購入額 $Y$
- 顧客属性:$X$
知りたいのは、クーポンによる購入額の平均的な増加額だけではありません。「休眠顧客には効果が大きいが、常連顧客には効果が小さい」といった、顧客属性 $X$ に応じた効果 $\tau(x)$ です。
T-Learnerの仕組み
T-Learner(Two-model learner)は、最も直感的なメタ学習器です。処置群と対照群のデータを分け、それぞれについて独立した回帰モデルを学習します。
ステップ1:処置群と対照群の結果モデルを学習する
処置群の結果モデルを、処置群のデータだけで学習します。
同様に、対照群の結果モデルを、対照群のデータだけで学習します。
ステップ2:2つの予測値の差を取る
CATEは、2つのモデルによる予測値の差として推定します。
例えば、ある顧客属性 $x$ について、クーポンを配布した場合の予測購入額が3,000円、配布しなかった場合が2,600円であれば、クーポン効果は400円と推定されます。
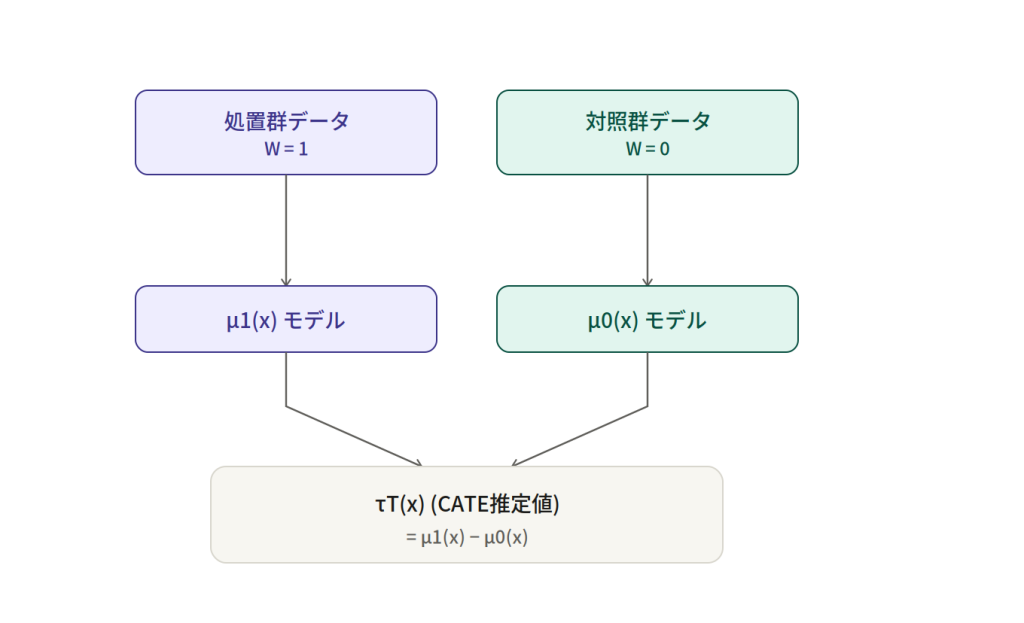
図1:処置群と対照群で独立したモデルを学習し、予測値の差からCATEを推定する。
T-Learnerの弱点
T-Learnerは単純で理解しやすい一方、主に2つの弱点があります。
データ数の偏りに弱い
処置群と対照群のデータ数が大きく異なる場合、少数派側のモデルは学習データが不足し、予測精度が低下しやすくなります。
例えば、クーポンを配布した顧客が全体の5%しかいない場合、処置群のモデル $\widehat{\mu}_1(x)$ は十分なパターンを学習できない可能性があります。このような状況では、正則化の影響によって群間の差が過度に縮小される正則化バイアスも問題になります。
群をまたいだ情報共有ができない
$\widehat{\mu}_1(x)$ と $\widehat{\mu}_0(x)$ は独立に学習されるため、一方のモデルが学習した「特徴量 $X$ と結果 $Y$ の関係」を、もう一方のモデルが直接活用できません。
特に観察データ(非ランダム化データ)では、処置群と対照群のサイズや属性分布が偏ることが多いため、この弱点を無視できません。
X-Learnerの仕組み
X-LearnerはT-Learnerを拡張した手法で、特に処置群と対照群のデータ数が偏っている場合に有効です。処理は4つのステージに分かれます。
ステージ1:結果モデルを学習する
T-Learnerと同様に、処置群と対照群の結果モデルを学習します。
ステージ2:疑似的な処置効果を計算する
各個体について、反実仮想の予測値を使って疑似効果を計算します。
処置群の個体 $i$ では、実際の結果から「処置を受けなかった場合」の予測値を引きます。
対照群の個体 $i$ では、「処置を受けた場合」の予測値から実際の結果を引きます。
| 顧客 | 群 | 実測購入額 $Y$ | 反実仮想の予測値 | 疑似効果 $D$ |
|---|---|---|---|---|
| 顧客A | 処置群 ($W=1$) | 120 | $\widehat{\mu}_0(X_A)=80$ | $D_A^{(1)}=120 -80=40$ |
| 顧客B | 対照群 ($W=0$) | 50 | $\widehat{\mu}_1(X_B)=70$ | $D_B^{(0)}=70 -50=20$ |
ステージ3:疑似効果を予測するモデルを学習する
処置群の疑似効果 $D^{(1)}$ を目的変数として、効果モデル $\widehat{\tau}_1(x)$ を学習します。
$$
\widehat{\tau}_1(x)
\approx
\mathbb{E}[D^{(1)}\mid X=x,W=1]
$$
同様に、対照群の疑似効果 $D^{(0)}$ を目的変数として、効果モデル $\widehat{\tau}_0(x)$ を学習します。
$$
\widehat{\tau}_0(x)
\approx
\mathbb{E}[D^{(0)}\mid X=x,W=0]
$$
ステージ4:2つの効果モデルを統合する
傾向スコア $g(x)$ を、その個体が処置群に属する確率として定義します。
最終的なCATE推定値は、2つの効果モデルを傾向スコアで重み付けして求めます。
この重み付けでは、処置群が少ない領域、すなわち $g(x)$ が小さい領域で $\widehat{\tau}_1(x)$ の重みが大きくなります。これは、対照群の豊富なデータから $\widehat{\mu}_0(x)$ を精度よく推定でき、その予測を使って処置群の疑似効果 $D^{(1)}$ を構成できるためです。反対に、$g(x)$ が大きい領域では、処置群から精度よく推定した $\widehat{\mu}_1(x)$ を使う $\widehat{\tau}_0(x)$ が重視されます。
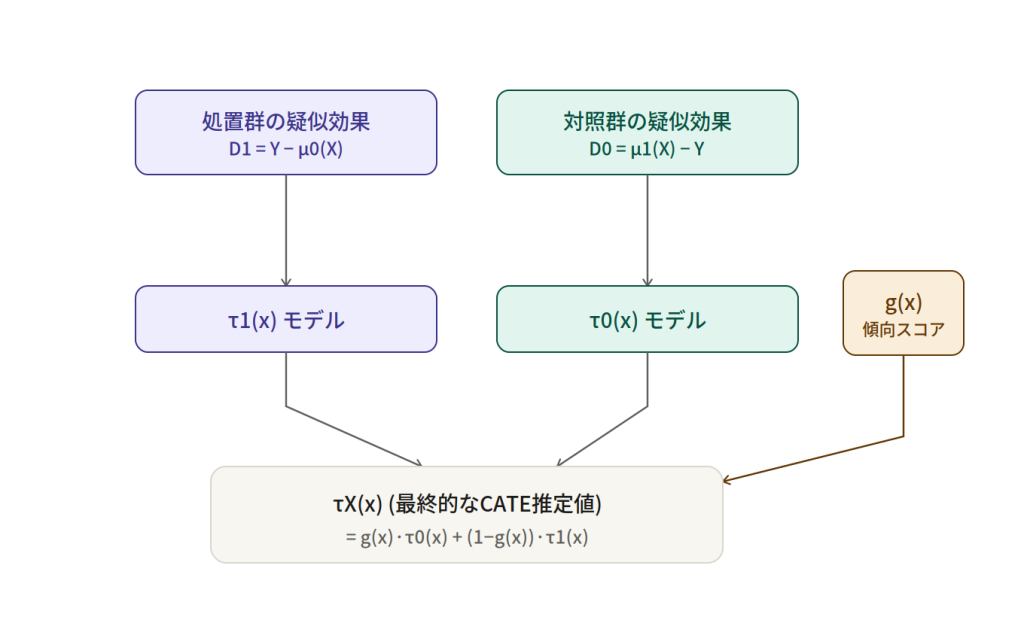
図2:傾向スコア $g(x)$ を使い、処置群側と対照群側の効果推定を統合する。
T-LearnerとX-Learnerの比較
| 比較項目 | T-Learner | X-Learner |
|---|---|---|
| 基本的な考え方 | 2つの結果モデルの差を取る | 疑似効果を学習し、重み付けして統合する |
| 学習するモデル | 結果モデル2個 | 結果モデル2個+効果モデル2個+傾向スコアモデル |
| 群のサイズが均衡している場合 | 十分に機能しやすい | T-Learnerと同程度の場合が多い |
| 群のサイズが偏っている場合 | 少数派側の精度が低下しやすい | 多数派側の情報を活用しやすい |
| 実装・解釈 | シンプル | やや複雑 |
| 計算コスト | 比較的小さい | 比較的大きい |
使い分けの目安
- T-Learnerが向いている場合:処置群と対照群のサイズが近く、まず単純な基準モデルを作りたい
- X-Learnerが向いている場合:群のサイズが大きく偏っており、多数派側の情報を活用したい
X-Learnerが常にT-Learnerより高精度になるとは限りません。最終的には、交差検証や施策評価に適した指標を使って比較することが重要です。
まとめ
T-Learnerは、処置群と対照群について別々の結果モデルを学習し、その予測値の差からCATEを推定する、シンプルなメタ学習器です。
一方、X-Learnerは、反実仮想の予測値から疑似効果を作り、それを再度モデル化したうえで、傾向スコアを使って統合します。手順は複雑になりますが、処置群と対照群のデータ数が偏っている状況で有利になる可能性があります。
要点は次のとおりです。
- T-Learnerは実装しやすく、比較の基準として使いやすい
- X-Learnerは疑似効果を介して、群間の情報を活用する
- データの偏りが大きい場合は、X-Learnerを比較候補にする
- どちらの手法でも、内部の回帰モデルは目的に応じて選択できる
実務では、まずT-Learnerをベースラインとして構築し、群の偏りや推定精度を確認したうえで、X-Learnerと比較する進め方が現実的です。