
-
 ナレッジ
Prediction-Powered Inference(PPI):AIの予測を、統計的に正しく使う方法
1. 概要 Prediction-Powered Inference(PPI) は、機械学習モデルやLLMの予測を大量に使いつつ、少量の正解データでそ... -
 AIエージェント データ分析 ナレッジ
事前学習モデルのFine-tuningでテキスト分類を自動化する
はじめに 「社内の問い合わせを自動で振り分けたい」「大量のテキストをカテゴリに分類したい」——こうしたニーズは業務の中で... -
 ナレッジ
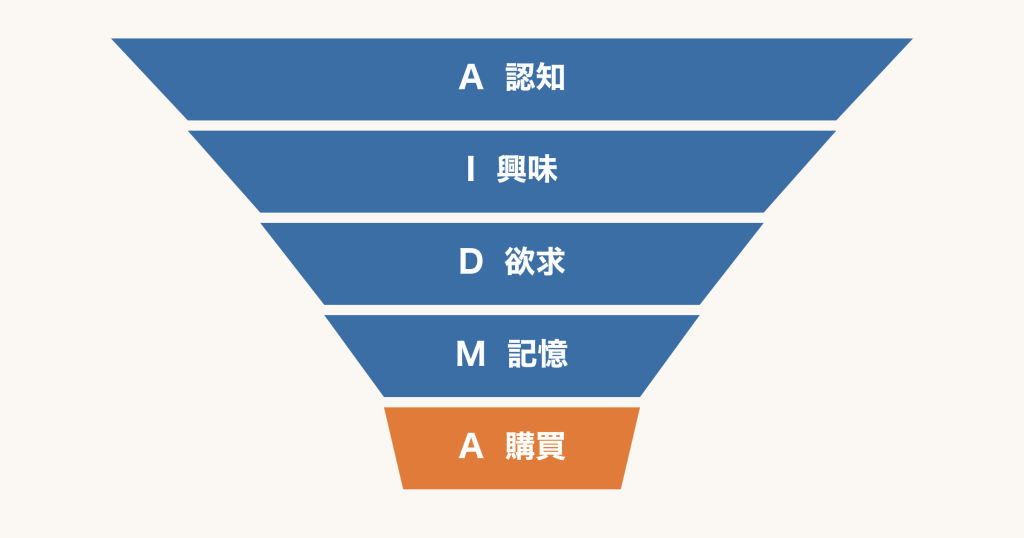
AIDMA でファネル分析 ― シミュレーションデータで、感度分析とブートストラップ法を使いボトルネックを探す
1. はじめに AIDMA は、人が商品を知ってから買うまでを「認知 → 興味 → 欲求 → 記憶 → 購買」の5段階で表すモデルです。段階... -
 AIエージェント ナレッジ ユースケース 業務変革
Claude Codeで体験するハーネスエンジニアリング入門
-
 ナレッジ
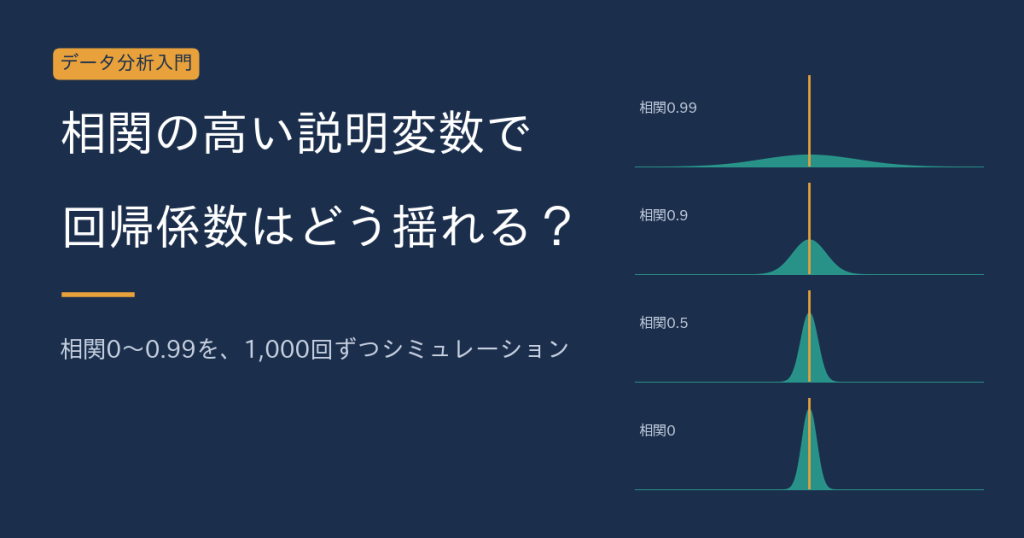
多重共線性とは回帰係数の解釈が壊れる理由について解説
はじめに 重回帰分析で、相関の高い説明変数を一緒に入れたことはありませんか。係数の符号が想定と逆になったり、重要そうな... -
 データ分析 ナレッジ
LightGBM・XGBoostのパラメータを徹底解説 ― 数値を変えるとどうなる?
はじめに LightGBM や XGBoost でモデルを作るとき、learning_rate や num_leaves などのパラメータを「よく使われる値」のま... -
 データ分析
LightGBM・XGBoost・CatBoostをオープンデータで比較してみた
はじめに テーブルデータの予測では、XGBoost・LightGBM・CatBoost の3つが定番です。それぞれ「LightGBM は速い」「CatBoost... -
 AIエージェント ナレッジ
LoRAとは何か?
LoRAとは LoRA(Low-Rank Adaptation)は、LLMの元の重みを固定したまま、下流のパラメータだけを学習に用いる方法です。モデル... -
 データ分析
負例のデータがなくても分類器は作れる?──Positive-confidence分類
イントロダクション 購入の予測モデルを作りたいとします。自社の顧客のデータ(購入した人)は簡単に集められます。しかし、... -
 データ分析
レビューの項目ごとの感情を取り出す──ABSA(アスペクトベース感情分析)
イントロダクション スマートフォンのレビューが星4つだったとします。本文には、「バッテリーは長持ちするが、画面が暗くて...
