LoRAとは
LoRA(Low-Rank Adaptation)は、LLMの元の重みを固定したまま、下流のパラメータだけを学習に用いる方法です。モデル全体を学習し直さないので、少ないメモリと短い時間で、モデルを特定のタスクに適合することができます。
この記事の前半では、LoRAの仕組みを最小限の数式で説明し、後半では、小型のLLMに「議事録をJSONに変換する」形式をLoRAで学習させ、プロンプトの工夫だけ(few-shot)の場合と数値で比べた検証を紹介します。
なぜLoRAが必要なのか
LLMを自分の用途に合わせて追加学習する通常の「ファインチューニング」は、モデルのすべてのパラメータを更新するため、とても重い作業になります。
- メモリが足りない:数十億のパラメータすべてについて、重みに加えて学習中の途中状態も保持する必要があり、個人のGPUや無料のColabでは動かせないことが多い
- 時間がかかる:更新するパラメータが多いほど、学習1回あたりの計算量が増える
- 保存と管理が大変:用途ごとにモデル全体のコピーができてしまい、「議事録用」「FAQ用」「口調用」と増やすたびに容量がかさむ
そこで、元のモデルには手をつけず、変更したい分だけを小分けして、個別に学習しようという発想で生まれたのがLoRAです。
LoRAの仕組み
通常の層は、入力 x に重み W を掛けて出力を作ります。LoRAはこの W を固定し、横に小さな行列 A と B を通る経路を追加して、その結果を足し合わせます。
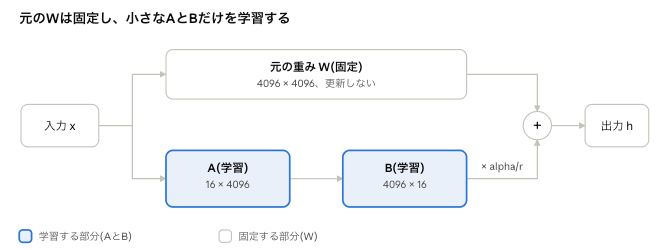
Wが 4096×4096 のとき、A は 16×4096、B は 4096×16 の細長い行列です。入力はいったん細い幅(r=16)に圧縮され、そのあと元の幅に戻されます。この「細さ」が Low-Rank という名前の由来で、学習するパラメータを減らせる理由です。
学習開始時は B をゼロで初期化するため、追加経路の出力はゼロで、最初は元のモデルと同じ出力になります。そこから A と B だけが少しずつ更新されます。学習後は、A と B の積を W に足し込んで一つの行列にまとめることもできます。
学習するパラメータはどれだけ減るか
1層あたり4096×4096の重み行列を例に、ランク r=16 のLoRAで学習するパラメータ数を比べると、約0.78%まで減ります。
| 対象 | 形 | パラメータ数 |
|---|---|---|
| 元の重み W(通常のファインチューニングで更新) | 4096 × 4096 | 16,777,216 |
| LoRAの行列 A | 16 × 4096 | 65,536 |
| LoRAの行列 B | 4096 × 16 | 65,536 |
| LoRAで学習する合計(A + B) | 131,072 |
131,072 ÷ 16,777,216 ≈ 0.78% です。これは1つの層の例で、実際のモデルには同様の層が多数あります。モデル全体で学習するパラメータの割合は、層の幅、対象にする層、r の値で変わります。
rを大きくするほど学習できる表現力は増えますが、学習するパラメータも増えます。この割合は r に比例します。
主な設定項目
LoRAを使うときに最初にする設定は、次の4つです。
| 設定名 | 意味 | この記事の検証での値 |
|---|---|---|
| r(ランク) | 追加部品の「大きさ」。大きいほど表現力が増えるが、学習するパラメータも増える | 16 |
| lora_alpha | 追加部品の効きの強さを決める係数。実際の補正量には alpha ÷ r が掛かる | 32(rの2倍) |
| target_modules | LoRAを付ける層の指定。注意機構(q, k, v, o)や全結合層(gate, up, down)など | 上記7種すべて |
| lora_dropout | 過学習を抑えるために学習中に一部を無効化する割合 | 0 |
メリットと注意点
LoRAは、少ない計算資源で新しい振る舞いを覚えさせたい場面に向いていますが、万能ではありません。
メリット
- 学習するパラメータが少なく、メモリと時間を節約できる
- 保存するのは追加部品だけなので、ファイルが小さい
- 用途ごとに追加部品を差し替えれば、1つのベースモデルを使い回せる
- 学習後に元の重みへ足し合わせて(マージして)、追加の推論コストなしで使うこともできる
注意点
- 元のモデルが持っていない知識を大量に覚えさせる用途には向きにくい
- データが少ないと、過学習が起きやすい
- r や対象の層の選び方で結果が変わるため、設定の比較が必要
- データの扱いには通常の学習と同じ注意が要る(著作権や肖像権)
検証:設計
ここからは実際にLoRAを使って、「議事録のテキストをJSONに変換する」形式を学習させた検証を行います。成功の基準は、同じ40件のテストデータに対する4つの指標と、3つの条件の比較で決めました。
評価指標
- パース成功率:出力がJSONとして読めるか
- スキーマ準拠率:必須キーが揃い、型が合っているか
- 項目別正解率:日付、参加者、アクション項目がそれぞれ正解と一致するか
- 完全一致率:3項目すべてが正解と一致したか
比較する3条件
| 条件 | 内容 |
|---|---|
| zero-shot | LoRAなしのベースモデルに、形式を説明する指示だけを与える |
| few-shot | LoRAなしのベースモデルに、指示と例3件を与える |
| LoRA | 学習データ160件でLoRAを学習し、指示だけを与える |
200件のデータを作り、160件を学習用、40件をテスト用に分けました。テスト用は学習に一切使わないので、「学習データを丸暗記しただけ」という疑いを避けられます。乱数のseedも固定しています。
検証:データの作り方
学習データは、プログラムで作った架空の議事録200件です。テンプレートから生成するので、正解のJSONも同時に確定し、ラベルの間違いが起きません。
出力するJSONの形式
{
  "date": "2026-10-07",
  "attendees": ["高橋", "中村"],
  "action_items": [
    {"owner": "加藤", "task": "サーバー構成を確認する", "due": "2026-10-22"}
  ]
}
入力にあえて混ぜた表記ゆれ
| 項目 | ゆれの例 |
|---|---|
| 会議の日付 | 2026-10-07 / 2026/10/7 / 2026年10月7日 / 令和8年10月7日 |
| 期限 | 10/22 / 10月22日(年は会議と同じ年として扱う) |
| 参加者 | 「高橋さん」と「高橋」の混在、区切りが「、」「,」「/」 |
| アクション項目 | 「〇〇さんが…(期限:10/22)」「ToDo:… 担当=… 〆10/22」「〇〇は10/22までに…」の3形式 |
※ここでの結果は「決まった形式の出力を安定させる効果」を見るもので、現実の議事録での精度を保証するものではありません。
検証:環境と学習設定
無料のGoogle Colab(T4 GPU)上で、Unslothを使い、1.5Bパラメータの小型モデルを4bit量子化して学習しました。前半で説明した r や lora_alpha も、この表の値で指定しています。
| 項目 | 値 |
|---|---|
| 環境 | Google Colab(T4 GPU) |
| ライブラリ | Unsloth、TRL |
| ベースモデル | Qwen2.5-1.5B-Instruct(4bit) |
| LoRAのランク r | 16 |
| lora_alpha | 32 |
| 対象モジュール | q, k, v, o, gate, up, down の各projection |
| 最大系列長 | 1024 |
| バッチサイズ | 4 |
| エポック数 | 3 |
| 学習率 | 2e-4 |
| オプティマイザ | adamw_8bit |
| 乱数seed | 42 |
| 学習時間 | 約101秒(60ステップ) |
推論はすべて do_sample=False(毎回同じ出力になる設定)で行い、3条件で生成条件をそろえています。
※UnslothやTRLは更新が早いため、読む時点で引数名が変わっている場合があります。
学習されたパラメータは18,464,768個で、モデル全体の1,562,179,072個の1.18%でした。学習損失は、5ステップ目の1.77から、60ステップ目の0.145まで下がりました。
検証:結果
テスト40件での結果は次のとおりです。完全一致率は、LoRAが97.5%で最も高く、zero-shotは0%でした。
| 条件 | パース成功率 | スキーマ準拠率 | 日付 | 参加者 | アクション項目 | 完全一致率 |
|---|---|---|---|---|---|---|
| zero-shot | 85.0% | 80.0% | 75.0% | 15.0% | 7.5% | 0.0% |
| few-shot(3例) | 100.0% | 100.0% | 100.0% | 100.0% | 87.5% | 87.5% |
| LoRA | 100.0% | 100.0% | 100.0% | 100.0% | 97.5% | 97.5% |
日付・参加者・アクション項目の列は、それぞれ全40件中の一致率です。40件なので、1件の違いが2.5ポイントにあたります。完全一致率は、few-shotが35件、LoRAが39件の正解です。
検証:考察
形式の安定は、zero-shotからfew-shotに変えるだけで解決しました。LoRAの上乗せは、中身の正確さ(アクション項目の一致率)に表れました。
形式の安定:few-shot、LoRAともに準拠率は100%
zero-shotのパース成功率は85%(34/40件)、スキーマ準拠率は80%でした。few-shotとLoRAは、どちらも100%です。zero-shotの失敗例には、次の2種類がありました。
- 配列の閉じ括弧が欠けていて、JSONとして読めない出力
- 出力が途中で途切れた出力(アクション項目の途中で終わっていた)
- ノートブックの生成上限(400トークン)に達した可能性があり、上限を増やせば減る可能性がある
中身の正確さ:zero-shotは「さん」の扱いで不整合が起きた
zero-shotで最も低かったのは参加者の一致率で、15%(6/40件)でした。指示では名前に「さん」を付けないと書いていますが、失敗例では attendees に「山田さん」のように残っていました。同じ出力の中で、attendees は「高橋さん」、owner は「高橋」と不揃いなものもありました。
few-shotでは、例を3件見せただけで、日付と参加者が100%になりました。
LoRAとfew-shotの差:アクション項目 87.5% → 97.5%
アクション項目の一致は、few-shotが35件、LoRAが39件で、差は4件です。LoRAが間違えた1件(テスト#12)は、few-shotも間違えた議事録でした。言い換えると、few-shotが間違えた5件のうち、LoRAは4件を正しく抽出できています。
不一致の中身は次のとおりです。
| 条件 | テスト | 失敗の種類 | 内容 |
|---|---|---|---|
| LoRA | #12 | 期限の取り違え | 「予算案を見直す」と「リリースノートを書く」の期限が入れ替わった |
| few-shot | #2 | 項目の脱落 | 「松本は6月25日までに見積書を作成する」が出力にない |
| few-shot | #3 | 項目の脱落と日付の誤り | ToDo形式の「競合調査をまとめる」が出力にない。「顧客へ連絡する」の期限が9/21でなく10月21日になった |
| few-shot | #12 | 項目の脱落 | 箇条書きの「予算案を見直す」が出力にない |
| few-shot | #19 | 項目の脱落 | ToDo形式の「契約書をレビューする」が出力にない |
| few-shot | #33 | 担当者の取り違え | 山本と木村のタスクが入れ替わった |
few-shotの失敗の傾向
few-shotの5件のうち4件は、項目が出力から抜けていました。残る1件は、担当者が入れ替わっていました。5件はすべて、アクション項目が2件以上の議事録で、うち4件は3件ある議事録でした(3件ある議事録は11件中4件で失敗)。
また、5件すべてに「ToDo:」形式の行が含まれていました。ToDo形式を含む議事録は40件中17件で、含まない23件では、few-shotの失敗は0件です。ただし件数が少なく、複数の書き方が混在していること自体が原因かもしれないので、ToDo形式が原因とは断定できません。
LoRAの失敗
LoRAの不一致は#12の1件だけで、同じ担当者の2項目の期限が入れ替わっていました。担当者と日付の読み取りは合っていて、「どの期限がどの項目のものか」の対応づけを間違えた形です。
この検証における限界
- データはテンプレート生成で、実際の議事録より文体が単純
- テストは40件で、学習と評価はそれぞれ1回だけ(seedを変えた再実験はしていない)
- ベースモデルは1.5Bの1種類だけ
まとめ
LoRAは、元のモデルを固定して小さな追加部品だけを学習する方法で、メモリと時間を大きく減らせます。
検証では、議事録からJSONへの変換を題材に、zero-shot、few-shot、LoRAの3条件を同じテスト40件で比べました。結論は、この条件では、形式を安定させる効果の大半はfew-shotでも得られ、LoRAの上乗せは中身の正確さ(アクション項目の一致率が87.5%から97.5%)にとどまった、というものです。
付録:検証に使ったコード
検証で使ったGoogle Colabノートブックのコードです。ランタイムをT4 GPUにして、上から順に1セルずつ実行します。
準備:インストール
!pip install -q unsloth1. 合成データを作る(正解ラベルはプログラムで確定)
import random, json
from datetime import date, timedelta

NAMES = ["田中","佐藤","鈴木","高橋","伊藤","渡辺","山本","中村","小林","加藤","吉田","山田","松本","井上","木村"]
TASKS = ["見積書を作成する","仕様書を更新する","テスト結果を共有する","顧客へ連絡する","予算案を見直す",
         "議事録を配布する","デモ環境を準備する","バグ修正を完了する","リリースノートを書く","競合調査をまとめる",
         "契約書をレビューする","サーバー構成を確認する"]
TOPICS = ["新機能の進捗","来期の予算","障害対応の振り返り","採用計画","顧客からの要望","リリース日程"]

def fmt_date(d, style, with_year=True):
    if style == 0: return d.strftime("%Y-%m-%d")
    if style == 1: return f"{d.year}/{d.month}/{d.day}" if with_year else f"{d.month}/{d.day}"
    if style == 2: return f"{d.year}年{d.month}月{d.day}日" if with_year else f"{d.month}月{d.day}日"
    return f"{d.month}月{d.day}日" if not with_year else f"令和{d.year-2018}年{d.month}月{d.day}日"

def make_example(rng):
    mdate = date(2026, 1, 1) + timedelta(days=rng.randint(0, 300))
    attendees = rng.sample(NAMES, rng.randint(2, 5))
    n_items = rng.randint(1, 3)
    items = []
    for t in rng.sample(TASKS, n_items):
        due = mdate + timedelta(days=rng.randint(2, 30))
        items.append({"owner": rng.choice(attendees), "task": t, "due": due.strftime("%Y-%m-%d")})
    ds = rng.randint(0, 3)
    topic = rng.choice(TOPICS)
    lines = [f"【議題】{topic}", f"日時:{fmt_date(mdate, ds)}"]
    sep = rng.choice(["、", ",", "/"])
    lines.append("参加者:" + sep.join(a + rng.choice(["", "さん"]) for a in attendees))
    lines.append(f"{topic}について議論し、方針を確認した。")
    for it in items:
        dstr = fmt_date(date.fromisoformat(it["due"]), rng.choice([1, 2]), with_year=False)
        lines.append(rng.choice([
            f"・{it['owner']}さんが{it['task']}(期限:{dstr})",
            f"ToDo:{it['task']} 担当={it['owner']} 〆{dstr}",
            f"{it['owner']}は{dstr}までに{it['task']}。"]))
    out = {"date": mdate.strftime("%Y-%m-%d"), "attendees": attendees, "action_items": items}
    return {"input": "\n".join(lines), "output": out}

def make_dataset(n=200, seed=42):
    rng = random.Random(seed)
    return [make_example(rng) for _ in range(n)]

import json
data = make_dataset(200, seed=42)
train_data, test_data = data[:160], data[160:]
print(len(train_data), len(test_data))
print(test_data[0]["input"]); print(json.dumps(test_data[0]["output"], ensure_ascii=False))
2. モデルを読み込み、LoRAを付ける
from unsloth import FastLanguageModel
import torch

MODEL_NAME = "unsloth/Qwen2.5-1.5B-Instruct"   # 好きな小型モデルに変更可
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME, max_seq_length=1024, load_in_4bit=True)

LORA_R = 16
model = FastLanguageModel.get_peft_model(
    model, r=LORA_R, lora_alpha=LORA_R * 2, lora_dropout=0,
    target_modules=["q_proj","k_proj","v_proj","o_proj","gate_proj","up_proj","down_proj"],
    random_state=42)
3. プロンプトと学習データの整形
from datasets import Dataset

INSTRUCTION = '''次の議事録から情報を抽出し、JSONのみを出力してください。
形式: {"date": "YYYY-MM-DD", "attendees": ["名前"], "action_items": [{"owner": "名前", "task": "内容", "due": "YYYY-MM-DD"}]}
・名前に「さん」は付けない ・期限の年は会議の年とする'''

def build_messages(text, fewshot=()):
    msgs = [{"role": "system", "content": INSTRUCTION}]
    for ex in fewshot:
        msgs += [{"role": "user", "content": ex["input"]},
                 {"role": "assistant", "content": json.dumps(ex["output"], ensure_ascii=False)}]
    msgs.append({"role": "user", "content": text})
    return msgs

def to_text(ex):
    msgs = build_messages(ex["input"]) + [{"role": "assistant", "content": json.dumps(ex["output"], ensure_ascii=False)}]
    return {"text": tokenizer.apply_chat_template(msgs, tokenize=False)}

train_ds = Dataset.from_list(train_data).map(to_text)
print(train_ds[0]["text"][:600])
4. 学習
from trl import SFTTrainer, SFTConfig

config = SFTConfig(
    output_dir="outputs", dataset_text_field="text", max_seq_length=1024,
    per_device_train_batch_size=4, gradient_accumulation_steps=2,
    num_train_epochs=3, learning_rate=2e-4, lr_scheduler_type="linear",
    warmup_steps=5, logging_steps=5, optim="adamw_8bit",
    fp16=not torch.cuda.is_bf16_supported(), bf16=torch.cuda.is_bf16_supported(), seed=42, report_to="none"
    )

trainer = SFTTrainer(model=model, tokenizer=tokenizer, train_dataset=train_ds, args=config)
stats = trainer.train()
print("学習時間(秒):", stats.metrics["train_runtime"])
5. 評価:zero-shot / few-shot / LoRA を同じテストデータで比較
import re
FastLanguageModel.for_inference(model)

def generate(messages, max_new_tokens=400):
    ids = tokenizer.apply_chat_template(messages, add_generation_prompt=True,
                                        return_tensors="pt").to("cuda")
    out = model.generate(input_ids=ids, max_new_tokens=max_new_tokens, do_sample=False)
    return tokenizer.decode(out[0][ids.shape[1]:], skip_special_tokens=True)

def parse_json(s):
    s = re.sub(r"^```(?:json)?|```$", "", s.strip(), flags=re.M).strip()
    try: return json.loads(s)
    except Exception: return None

def schema_ok(o):
    try:
        return (isinstance(o["date"], str) and isinstance(o["attendees"], list)
                and all(isinstance(a, str) for a in o["attendees"])
                and all(set(i) == {"owner","task","due"} for i in o["action_items"]))
    except Exception: return False

def norm_items(o): return sorted((i["owner"], i["task"], i["due"]) for i in o["action_items"])

def evaluate(name, use_adapter, fewshot=()):
    r = dict(parse=0, schema=0, date=0, attendees=0, items=0, exact=0)
    bad = []
    for ex in test_data:
        msgs = build_messages(ex["input"], fewshot)
        if use_adapter: raw = generate(msgs)
        else:
            with model.disable_adapter(): raw = generate(msgs)
        o = parse_json(raw)
        if o is None: bad.append(raw); continue
        r["parse"] += 1
        if not schema_ok(o): bad.append(raw); continue
        r["schema"] += 1
        gt = ex["output"]
        d = o["date"] == gt["date"]
        a = sorted(o["attendees"]) == sorted(gt["attendees"])
        i = norm_items(o) == norm_items(gt)
        r["date"] += d; r["attendees"] += a; r["items"] += i; r["exact"] += (d and a and i)
    n = len(test_data)
    print(f"{name:10s}", {k: f"{v/n:.1%}" for k, v in r.items()})
    return r, bad

res = {}
res["zero-shot"], bad0 = evaluate("zero-shot", use_adapter=False)
res["few-shot"],  bad1 = evaluate("few-shot",  use_adapter=False, fewshot=train_data[:3])
res["LoRA"],      bad2 = evaluate("LoRA",      use_adapter=True)
6. 失敗例の確認
print("LoRAの失敗例:", len(bad2))
for b in bad2[:3]: print(b, "\n---")
print("zero-shotの失敗例(先頭):")
for b in bad0[:2]: print(b[:300], "\n---")
追加:正解と一致しなかった例を表示(セル5の後に実行)
def collect_mismatches(use_adapter, fewshot=()):
    """テスト40件を生成し直して、正解と一致しなかった例を集める"""
    out = []
    for idx, ex in enumerate(test_data):
        msgs = build_messages(ex["input"], fewshot)
        if use_adapter:
            raw = generate(msgs)
        else:
            with model.disable_adapter():
                raw = generate(msgs)
        o = parse_json(raw)
        if o is None or not schema_ok(o):
            out.append((idx, ex, raw, ["形式(パース/スキーマ)"]))
            continue
        gt = ex["output"]
        problems = []
        if o["date"] != gt["date"]:
            problems.append("date")
        if sorted(o["attendees"]) != sorted(gt["attendees"]):
            problems.append("attendees")
        if norm_items(o) != norm_items(gt):
            problems.append("items")
        if problems:
            out.append((idx, ex, raw, problems))
    return out

def show(name, mism, limit=6):
    print(f"===== {name}: 不一致 {len(mism)}件(先頭{min(limit, len(mism))}件を表示) =====")
    for idx, ex, raw, problems in mism[:limit]:
        print(f"\n--- テスト#{idx}  問題のある項目: {problems}")
        print("【入力】")
        print(ex["input"])
        o = parse_json(raw)
        if o and schema_ok(o):
            gt = set(norm_items(ex["output"]))
            got = set(norm_items(o))
            print("【正解にあって、出力にない】", sorted(gt - got))
            print("【出力にあって、正解にない】", sorted(got - gt))
            if "attendees" in problems:
                print("【参加者 正解】", ex["output"]["attendees"], "【出力】", o["attendees"])
            if "date" in problems:
                print("【日付 正解】", ex["output"]["date"], "【出力】", o["date"])
        else:
            print("【出力(先頭300字)】", raw[:300])

mism_lora = collect_mismatches(use_adapter=True)
mism_few = collect_mismatches(use_adapter=False, fewshot=train_data[:3])

show("LoRA", mism_lora)
show("few-shot", mism_few)
7. アダプタの保存(任意)
model.save_pretrained("lora_adapter")
tokenizer.save_pretrained("lora_adapter")
# from google.colab import files; !zip -r lora_adapter.zip lora_adapter; files.download("lora_adapter.zip")