イントロダクション
購入の予測モデルを作りたいとします。自社の顧客のデータ(購入した人)は簡単に集められます。しかし、「購入しなかった人」、たとえば競合他社の顧客のデータは手に入りません。正例(購入した人)だけで「買う人」と「買わない人」を見分ける分類器は作れるのでしょうか。
Ishida、Niu、Sugiyama(2018)は、正例に確信度(その特徴を持つ人が、正例である確率)を添えれば、負例のデータもラベルなしデータも使わずに、2値分類器を学習できることを示しました。これがPositive-confidence(Pconf、正信頼度)分類です。
Pconf分類とは
Pconf分類とは、「正例だけに、その正例である確率(確信度)を添えたデータから2値分類器を学習する」手法で、弱教師あり学習の一つです。データは、正例の特徴 $x_i$ と確信度 $r_i = p(y = +1 \mid x_i)$ の組です。確信度が低い正例は、「負例にも見えやすい、あいまいな正例」を表します。
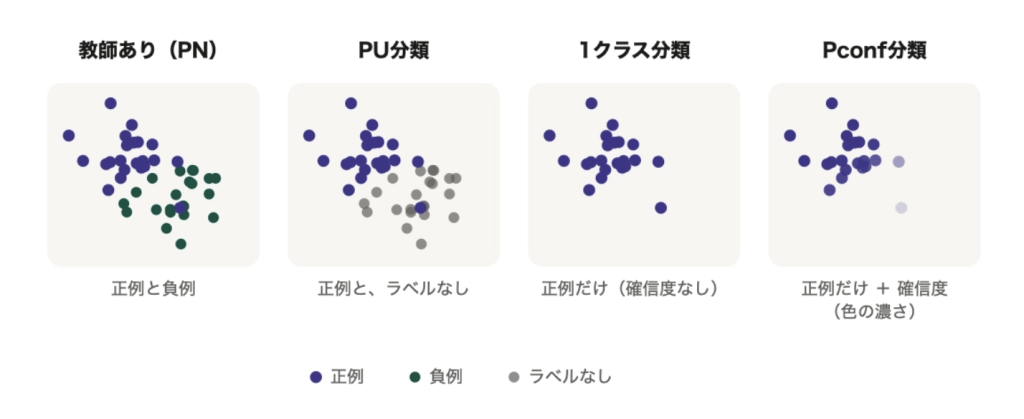
図1:4つの設定で使えるデータ。Pconfは正例だけに確信度がつく(点の色が濃いほど確信度が高い)。
| 設定 | 使えるデータ | 特徴 |
|---|---|---|
| 教師あり(PN) | 正例と負例(ラベルつき) | 負例の収集が必要 |
| PU分類 | 正例とラベルなしデータ | クラス事前確率の推定が必要 |
| 1クラス分類 | 正例だけ(確信度なし) | 正例を「記述」する。分類のためのハイパーパラメータの調整ができない |
| Pconf分類 | 正例だけ + 確信度 | 負例もラベルなしデータもクラス事前確率も不要 |
Pconf分類の利点として、1クラス分類と違い分類のためのハイパーパラメータを客観的に選べます。またPU分類と違い、推定が難しいクラス事前確率を必要としません。確信度がクラス事前確率の情報を間接的に含んでいるからです。
なぜ正例だけで学習できるのか(数値例)
鍵になるのは、「負例の密度を正例の密度と確信度から計算できる」ことです。
$$
\text{負例の密度} = \text{正例の密度} \times \frac{1-r(x)}{r(x)}
$$
架空の例で確かめます。特徴 $x$ は $A$ か $B$ の2つの値をとります。学習で使えるのは、正例の数とその確信度だけです。確信度はアンケートなどで外から与えられます(ここでは本当の確率と一致しているとします)。
| 特徴 $x$ | 正例の数 | 与えられる確信度 $r$ | $\frac{1-r}{r}$ |
|---|---|---|---|
| $A$ | 300 | $\frac{3}{4}$ | $\frac{1}{3}$ |
| $B$ | 100 | $\frac{1}{6}$(約0.17) | $5$ |
各正例に $\frac{1-r}{r}$ の重みで負例としての損失も持たせると、負例の数を正例の数と確信度だけから計算できます。
- $A$: $300 \times \frac{1}{3} = 100$
- $B$: $100 \times 5 = 500$
答え合わせをします。この例は、答え合わせができるように、全体(1,000人)の中の負例の数をあらかじめ決めて作りました。実際の学習では、右の列は見えません。
| 特徴 $x$ | 計算で求めた負例の数 | 本当の負例の数(学習では見えない) |
|---|---|---|
| $A$ | 100 | 100 |
| $B$ | 500 | 500 |
※ 確信度($\frac{3}{4}$ と $\frac{1}{6}$)は、「その特徴の人のうち、正例の割合」と同じ値です($A$:$\frac{300}{400}$、$B$:$\frac{100}{600}$)。答え合わせのために、この値になるように例を作りました。現実には、負例の数もこの割合も分かりません。確信度はアンケートなどで外から与えられる値です。
見えない負例が、正例の数と確信度から正確に再現できました。Pconf分類では、この再現した負例の分を損失に加えることで、ふつうの教師あり学習(PN)で最小にしたい分類リスクを不偏に推定します。
注意点:この例は、確信度が本当の確率と一致し、人数が全体の数と一致する理想化した場合です。実際のデータでは、負例の数はぴったりとは再現されません。確信度が正確なら、平均として一致します(不偏)。しかし、データが有限であることや、確信度がアンケートなどの見積もりであることによって、ばらつきやずれが生じます。
素朴な重みづけとの違い
確信度が分かるなら、「正例の損失に $r$、負例の損失に $1-r$ を掛ける」という素朴な方法を思いつくかもしれません。しかし、この方法では学習の対象が本来とは別の量になります。理由は、確信度つきのデータが $p(x)$ ではなく、$p(x \mid y = +1)$(正例の分布)からしかサンプルされていないためです。
Pconf:
$$
\sum_i \left[\ell(g(x_i)) + \frac{1-r_i}{r_i}\ell(-g(x_i))\right]
$$
素朴な方法:
$$
\sum_i \left[r_i\ell(g(x_i)) + (1-r_i)\ell(-g(x_i))\right]
$$
- $\ell(g(x_i))$:$i$ 番目の正例を、正例として扱ったときの損失
- $\frac{1-r_i}{r_i}\ell(-g(x_i))$:その正例に、「負例の分」として持たせた損失。重み $\frac{1-r_i}{r_i}$ は、確信度が低いほど大きくなる
- 素朴な方法: 正例の損失に $r_i$、負例の損失に $1-r_i$ を掛けたもの
上の数値例で、各 $x$ に損失がどれだけの重みで効くか(正例分と負例分の合計)を比べます。
| 特徴 $x$ | 本当(正例+負例) | Pconf | 素朴な方法 |
|---|---|---|---|
| $A$ | $300 + 100 = 400$ | $300 + 100 = 400$ | $225 + 75 = 300$ |
| $B$ | $100 + 500 = 600$ | $100 + 500 = 600$ | $16.7 + 83.3 = 100$ |
Pconf分類は、各 $x$ の重みが本当の分布(400と600)と一致します。素朴な方法は、各 $x$ での正例と負例の比($3:1$、$1:5$)は正しいものの、$x$ ごとの重みが300と100になります。$B$ が本当は全体の60%を占めるのに、素朴な方法では25%にしか見えません。
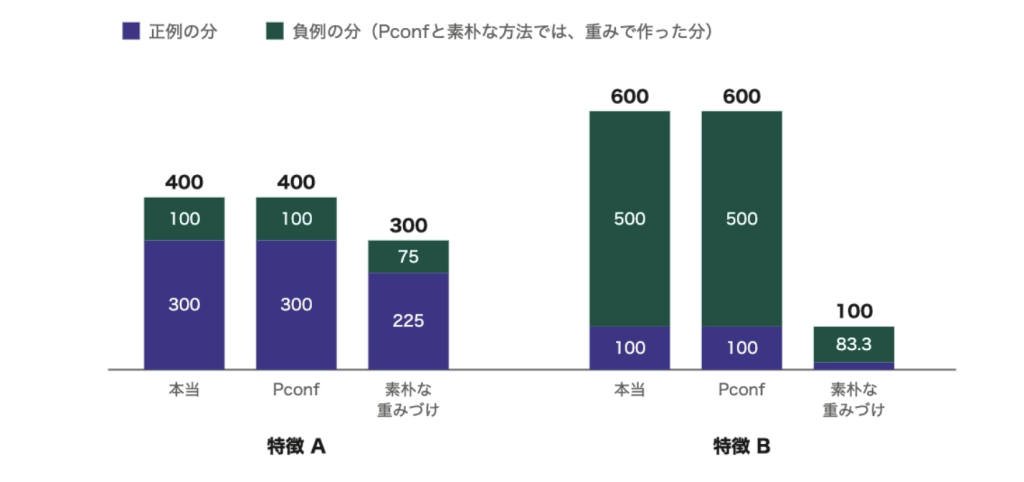
図2:各特徴の値で損失に効く重みの合計(棒の上の数字)。Pconf分類は本当の分布(400と600)と一致する。素朴な方法は300と100になり、一致しない。
学習のしかた
学習は、ふつうの教師あり学習とほとんど同じです。違うのは最小にする式だけです。
$$
\min_g \sum_i \left[\ell(g(x_i)) + \frac{1-r_i}{r_i}\ell(-g(x_i))\right]
$$
各正例の「正例として間違えた損失」と「確信度から再現した、負例の分の損失」を足した合計が最小になる分類器を探します。
- モデルと解き方は自由です。 Pconf分類が決めるのは、この式だけです。モデルも、損失も、最小にする計算の方法も、ふつうの教師あり学習と同じように選べます。
- ハイパーパラメータの選び方: 負例がなく、正解率は計算できません。代わりに検証用の正例(確信度つき)で、上の式の損失を間違いを数える0-1損失に変えて計算し、値が小さい設定を選びます。この値は「誤って判定される人数」の見積もりです。
- 理論の保証: データが増えるほど、誤り率が、最良の分類器に近づきます(一致性)。
実験結果
論文の実験から、いくつかの結果を紹介します(数値は正解率〈%〉で、20回の平均)。
| データ | Pconf | 素朴な重みづけ | 教師あり(正例+負例) |
|---|---|---|---|
| 2次元ガウス分布(設定D) | 91.5 | 90.8 | 91.4 |
| Fashion-MNIST:T-shirt / trouser | 92.14 | 85.30 | 98.98 |
| Fashion-MNIST:T-shirt / sneaker | 89.86 | 58.26 | 100.00 |
| CIFAR-10:airplane / frog | 90.80 | 81.84 | 95.95 |
| CIFAR-10:airplane / cat | 85.18 | 89.60 | 92.90 |
- 多くの場合、Pconfは素朴な重みづけと同等か、それ以上でした。ただし、上のCIFAR-10のairplane / catのように、素朴な重みづけのほうが良い場合もあります。
- 人工データ(4つの設定)では、多くの場合、教師あり学習に近い正解率でした。
- 確信度にノイズを加えると、正解率は下がります。
注意点:Fashion-MNISTとCIFAR-10の実験では、確信度は正例と負例の両方で学習した別の確率分類器から作っています(現実には人が確信度を付けます)。そのため、実際のデータでの性能は確信度の質に左右されます。
まとめ
- Pconf分類: 正例だけに確信度を添えたデータで2値分類器を学習する。負例もラベルなしデータもクラス事前確率も不要。
- しくみ: $\text{負例の密度} = \text{正例の密度} \times \frac{1-r}{r}$。各正例に、この重みで負例の損失を持たせる。
- 素朴な重みづけとの違い: $x$ ごとの重みが本当の分布と一致するか。柔軟でないモデルでは、素朴な方法は一致しない。
- 注意: 確信度の質に左右される。確信度が0に近いと不安定になる。
参考文献
- Ishida, T., Niu, G., & Sugiyama, M. (2018). Binary classification from positive-confidence data. In Advances in Neural Information Processing Systems 31 (NeurIPS 2018). arXiv:1710.07138