はじめに
重回帰分析で、相関の高い説明変数を一緒に入れたことはありませんか。係数の符号が想定と逆になったり、重要そうな変数が「有意でない」と出たりして、戸惑った経験がある人もいると思います。
この記事の問いは次の一つです。
相関の高い説明変数を入れると、回帰係数はどれだけ不安定になるのか。そのとき、予測は壊れるのか。
人工データで相関の強さを変えながら1000回ずつ分析し、係数と予測精度の変化を見ます。
前提:多重共線性とは
多重共線性とは、説明変数どうしの相関が高く、ある変数を他の変数でほぼ言い表せる状態のことです。
重回帰の係数は、「他の変数を固定したときの、その変数の効果」を表します。ところが、X1とX2がほぼ一緒に動くデータでは、「X1だけが動いて、X2は動かない」場面がほとんどありません。そのため、X1の効果とX2の効果を、データから切り分けられなくなります。
起きることは、大きく次の3つです。
- 係数の推定値が、データが変わるだけで大きく動く
- 係数の標準誤差が大きくなり、本当は効いている変数が「有意でない」と出やすくなる
- 2つの変数を合わせた予測のあたり具合は、あまり変わらない場合がある
標準誤差の膨らみは、2変数の場合、次の式で目安がつきます。
VIF = 1 / (1 – 相関²) 標準誤差の膨らみ ≒ √VIF
相関が0.9ならVIFは約5.3で、標準誤差は約2.3倍になります。相関が0.99ならVIFは約50で、標準誤差は約7.1倍です。なお、変数が3つ以上の時のVIFは、ある変数を他の全ての変数で予測した時の決定係数R²を使い、「1 / (1 – R²)」で計算します。
「符号が逆になる」には2通りある
係数の符号が想定と逆になる理由は、1つではありません。
- 推定が不安定で、符号が揺れる。真の係数は正でも、推定値が負になることがあります。多重共線性の本題で、この記事の実験で確かめるのはこちらです。
- 見ている量が違う。単回帰では正の関係でも、他の変数を固定した重回帰では負になることがあります。これは推定の失敗ではなく、「他を固定した結果」という別の量を見ているためです。この記事の実験では扱いません。
この2点は混乱しやすい点なので、先に分けておきます。
実験
設定
- サンプル数は100です。X1は標準正規分布から作ります。
- X2は、X1との相関がrhoになるように作ります。rhoは0、0.5、0.9、0.99の4通りです。
- 目的変数は「Y = X1 + X2 + ノイズ」です。真の係数は、どちらも1です。ノイズの標準偏差は2にしました。
- 各条件で、データを作って当てはめる作業を1000回繰り返します。
予測精度は、1回ごとに新しく作った1000件のテストデータで、RMSE(2乗平均平方根誤差)を測ります。ノイズの標準偏差が2なので、どんなモデルでも、RMSEの平均は2がほぼ下限になります。2に近いほど、良い予測です。
テストデータは2つの場合を用意しました。
- 同じ相関:訓練データと同じrhoで作る
- 相関が崩れた:X1とX2を無相関(rho = 0)で作る
比べる手法は、次の4つです。
| 手法 | 内容 |
| 最小二乗法 | X1、X2の両方を入れた通常の重回帰 |
| Ridge | 同じ2変数で、係数を小さくする正則化を加えた回帰(強さは交差検証で自動選択) |
| X1のみ | X2を落とした回帰 |
| 2つの平均 | X1とX2の平均を1つの変数として入れた回帰 |
結果1:係数は、平均では当たるが、1回ごとのブレが大きくなる
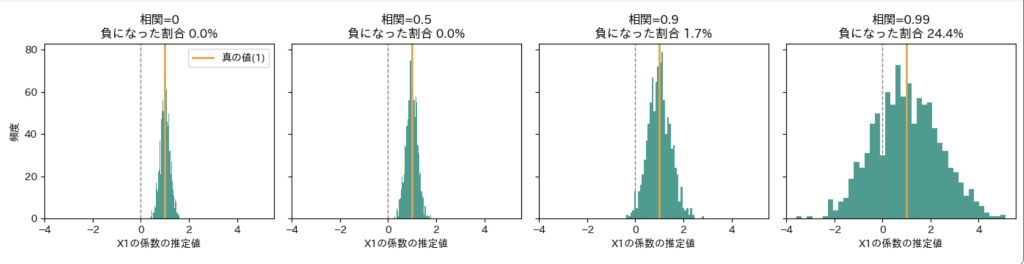
図1は、X1の係数の推定値を、相関ごとに1000回分並べたものです。橙の線が真の値(1)です。
| 相関 | 係数の平均 | 係数の標準偏差 | 標準誤差の平均 | VIFの平均 | 負になった割合 |
| 0 | 1.016 | 0.205 | 0.204 | 1.01 | 0.0% |
| 0.5 | 0.989 | 0.239 | 0.234 | 1.35 | 0.0% |
| 0.9 | 1.009 | 0.476 | 0.465 | 5.37 | 2 |
| 0.99 | 0.996 | 1.377 | 1.438 | 51.7 | 24.4% |
見えることは次の3つです。
- 係数の平均は、どの相関でも真の値(1)に近いです。多重共線性があっても、推定値が平均的に偏るわけではありません。
- 一方で、1回ごとのブレは相関が高いほど大きくなります。相関が0.99では、推定値がおおむね-3から5の範囲に広がり、4回に1回ほど、符号が負になりました。
- 標準誤差は、相関0に比べて、0.9で約2.3倍、0.99で約7倍です。先ほどの式の目安と合っています。また、標準誤差の平均は、実際のばらつき(標準偏差)とほぼ一致しています。
相関が0.99のとき、標準誤差(約1.4)は真の係数(1)より大きくなります。そのため、1回の分析では、この変数が「有意でない」と出やすくなります。
結果2:予測は壊れるのか。条件によって変わる
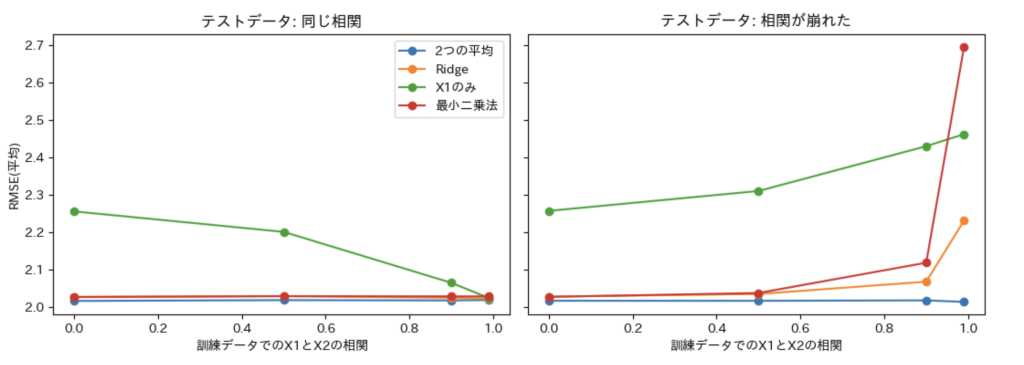
図2は、テストデータでのRMSE(平均)です。左がテストデータの相関が訓練データと同じ場合、右が相関が崩れた場合です。
| テストデータ | 手法 | 相関0 | 相関0.5 | 相関0.9 | 相関0.99 |
| 同じ相関 | 最小二乗法 | 2.027 | 2.030 | 2.029 | 2.029 |
| 同じ相関 | Ridge | 2.028 | 2.030 | 2.026 | 2.023 |
| 同じ相関 | X1のみ | 2.256 | 2.202 | 2.065 | 2.025 |
| 同じ相関 | 2つの平均 | 2.017 | 2.019 | 2.018 | 2.020 |
| 相関が崩れた | 最小二乗法 | 2.028 | 2.038 | 2.119 | 2.694 |
| 相関が崩れた | X | 2.029 | 2.036 | 2.068 | 2.231 |
| 相関が崩れた | X1のみ | 2.258 | 2.311 | 2.430 | 2.462 |
| 相関が崩れた | 2つの平均 | 2.018 | 2.017 | 2.019 | 2.015 |
左側(同じ相関)では、最小二乗法のRMSEは、相関によらず約2.03で変わりません。係数が1回ごとに大きくぶれていても、予測は当たっています。
右側(相関が崩れた)では、様子が変わります。最小二乗法のRMSEは、訓練データの相関が0.99のとき、2.694まで悪化しました。
この違いは、次のように説明できます。X1とX2がほぼ一緒に動く訓練データでは、「X1の係数とX2の係数の合計」はよく決まりますが、「両者の差」はほとんど決まりません。同じ相関のテストデータでは、X1とX2がほぼ一緒に動くので、差の誤差は予測に出ません。相関が崩れると、X1とX2が別々に動くので、差の誤差がそのまま予測の誤りになります。
Ridgeは、同じ条件(相関0.99)で最小二乗法より悪化が小さく(2.231)、抑えられていました。「X1のみ」は、相関が崩れると、訓練データの相関が高いほど悪化しました(2.258から2.462)。
「X1のみ」は、同じ相関のテストデータでは、相関が高いほど良くなっています。X2の情報の大半をX1が代わりに持っているためです。ところが、相関が崩れると、その代わりが効かなくなり、悪化します。
「2つの平均」は、どの条件でも約2.02と安定していました。ただし、これは真の係数がX1・X2ともに1という設定が、この手法に有利だったためです。
見分け方
次のような兆候があるときは、多重共線性を疑います。
- VIFが大きい。目安として、5や10を超えると疑う、と説明されることが多いです。ただし、絶対的な基準ではありません。この実験でも、相関0.9(VIF約5)で、すでに標準誤差は約2.3倍になっていました。
- 標準誤差が大きい。係数の大きさに比べて、標準誤差が極端に大きいときです。
- 変数を足し引きすると、係数が大きく変わる。データを少し減らして当てはめ直したときも、同じ兆候が出ます。
- 相関行列を見る。ただし、3つ以上の変数にまたがる共線性は、2変数ずつの相関では見落とすことがあります。VIFなら、他の全変数との関係をまとめて見られます。
対処法と使い分けの目安
最初に考えるのは、「何のために回帰を使うのか」です。
| 目的 | 多重共線性の影響 | 考え方 |
| 予測 | 小さいことが多い。ただし、新しいデータで相関が保たれている間だけ | 相関の構造が変わりうるなら、Ridgeや変数のまとめ方を検討する |
| 係数の解釈 | 大きい | 変数を減らす、まとめる、Ridgeで安定させる。係数を単独の「効果」として読まない |
対処の選択肢は、次のとおりです。
- 変数を落とす。同じ情報を持つ変数の片方を外します。ただし、外した変数の効果が、残した変数の係数に混ざります。(結果2の「X1のみ」)。
- 変数をまとめる。平均や合計、主成分などで一つにします。ただし、まとめ方が適切かは、変数の意味で判断が要ります。
- Ridgeなどの正則化を使う。係数を小さくする代わりに、安定させます。ただし、係数にバイアスが入るため、解釈は慎重に行います。
- データを増やす。標準誤差を小さくするには有効ですが、相関が高い状況そのものは変わりません。
自分は、係数を読むときは、まず変数同士の相関とVIFを確認しています。予測だけが目的のときは、それほど気にしません。
判断の流れは、次のようになります。
- 目的は予測か、係数の解釈か。
- 予測なら、新しいデータで、変数の相関が保たれる見込みはあるか。保たれない見込みがあるなら、Ridgeや変数のまとめ方を検討する。
- 解釈なら、VIFと標準誤差を確認する。大きければ、変数を減らす・まとめる・Ridgeで安定させる。それでも、係数を「効果」として読まず、傾向として扱う。
まとめ
最初の問いは、「相関の高い説明変数を入れると、回帰係数はどれだけ不安定になるのか。そのとき、予測は壊れるのか」でした。
係数は、平均的には真の値に近いままですが、1回ごとのブレは相関が高いほど大きくなります。この実験では、相関0.99で標準誤差が約7倍になり、4回に1回ほど符号が負になりました。
予測は、新しいデータでも変数の相関が保たれているうちは、この設定では、ほとんど壊れません。相関が崩れると、悪化が目立ちます。
だからこそ、多重共線性の影響は目的で変わります。予測だけなら小さいことが多く、係数を解釈するなら大きな問題になります。回帰を使う前に、「何のために使うか」と「新しいデータでも相関は保たれるか」を確かめておくことが大切です。