1. LLM(大規模言語モデル)が引き起こす二つの「間違い」
LLMはある程度自然な文章を書けるように進化してきました。その一方、存在しない事実をそれらしく語ったり、こちらの指示を無視したりすることが起こり得ます。以下の二つの例をご覧ください。
- 例A:事実の誤り;実在しない情報や結果を本物らしく出力する。
- 例B:文脈の無視;与えた指示が伝わらず、誤った形式で出力する。
いずれも一般的に「ハルシネーションといえば、」という具体的な例に当たりますが、研究では以下のように区別をされています。
| 種類 | どの部分が食い違うのか |
|---|---|
| factuality(事実性)の問題 | 世の中の事実 |
| faithfulness(忠実性)の問題 | 与えられた文脈・指示 |
本記事では以上の二つについて、原因と対策を整理します。
2. LLMの基本原理
ハルシネーションの原因を理解する前提として、まずはLLMがどのように出力を行っているのかを説明します。LLMは与えられた文脈から次に来るtoken(単語や節のイメージ)の確率分布を予測することで出力しています。ここで重要なのはプロンプトに対する答え全体を検索や予測しているわけではないということです。
それまでの文脈()をもとに次にどのtokenが来るのが最もらしいかを予測し、これを繰り返すことで文章が作られます。この性質はLLMの高度な文章生成能力を生み出していますが、その出力が確率的であることに問題があります。決定論的とは簡単に任意の数同じ試行を繰り返しても同一の出力が得られることを指しますが、LLMの出力はその出力の性質上非決定論的であることがポイントです。
3. ハルシネーションの原因1(factualityの問題)
前節でLLMは最もらしい情報を出力すると説明しましたが、「最もらしい」ことと「正しい」ことを区別する必要があります。人間が言葉を発する時「わからない」と言えば済む話ですが、LLMは「わからない」と言わずに回答を生成してしまいます。その理由については以下が挙げられます。
- 知識不足:学習データにほとんど含まれない事実(人物や論文の細かい情報)を正確に覚えていない。
- 学習や評価が回答の精度を評価する設計になっている:「分からない」と出力させるより、LLMの推論が当たる可能性に賭ける方が評価されやすい。([1])
4. ハルシネーションの原因2(faithfulnessの問題)
LLMが出力を行う際に、過去の文脈から次のtokenを予測しているという話を思い出してください。LLMと大量のやり取りをしているうちに、過去の情報がどんどん埋もれていきます。その結果正確な情報を出力するのに大切な情報まで失われていく、参照できなくなっていくことになります。
”Lost in the Middle: How Language Models Use Long Contexts” という論文においては、AIの出力に用いられる情報として、中間付近の情報がとりわけ使われにくいことが示唆されています。([2])最近のモデルでは改善傾向にありますが、その中の情報を全て等価に扱っているわけではありません。
以下は具体的なLLM(Claude; sonnet-5)の使用Context量を確認できる画面です。作業中に使用したContext量を都度確認することが重要です。
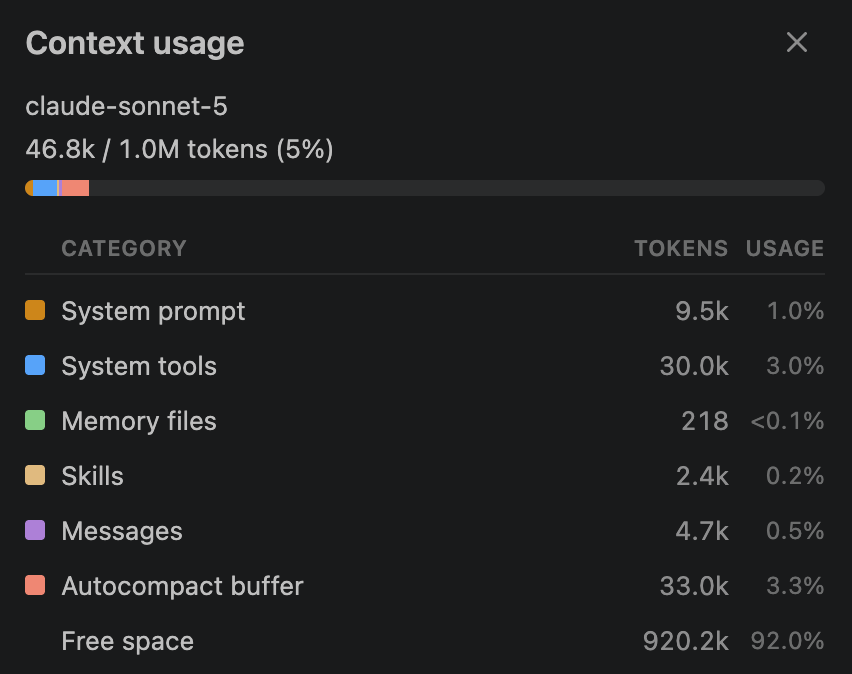
(図1: Context使用量の確認画面)
5. 対策
最後にハルシネーションの原因ごとの対策を説明します。ハルシネーションは完全に無くすことは難しいものの、発生しにくくする方法があります。
| 原因 | 主な対策 | 注意点・備考 |
|---|---|---|
| factuality(事実性)の問題 | 外部情報を使う(Web検索、RAG、ツール利用) | RAGでも、取得文書の誤要約や無関係な文書に引きずられる誤りは起こる。 |
| factuality(事実性)の問題 | 分からない場合は推測しないよう指示する | モデルは出力の確信度を正確に把握できていないため、効果には限界がある。 |
| faithfulness(忠実性)の問題 | 必要な情報だけを与える。 | 無関係な情報が多いほど、必要な情報が埋もれやすい。 |
| faithfulness(忠実性)の問題 | 重要な指示は冒頭か末尾に置く | Lost in the Middle への実用的な対応。 |
| faithfulness(忠実性)の問題 | 長い会話では、決定事項や前提条件を要約してから続ける | CodexやClaude Codeにおいては/compactを活用する。 |
6. まとめ
LLMは、過去の文脈をもとに次の情報を生成しています。そのため、「最もらしい」LLMの回答と「正しい」事実との間には少なからずズレが生じることになります。また会話を重ねるごとに情報が蓄積し、過去の大切な情報を参照しにくくなります。以上のことが原因で起こるハルシネーションですが、原因ごとに対策を講じるのが重要です。
参考文献
[1]: Adam Tauman Kalai (OpenAI), Ofir Nachum (OpenAI), Santosh S. Vempala (OpenAI), Edwin Zhang (OpenAI), “Why Language Models Hallucinate”, September 4, 2025, https://arxiv.org/pdf/2509.04664
[2]: Nelson F.Liu (Stanford University), Kevin Lin (University of California, Berkeley), John Hewitt (Stanford University), Ashwin Paranjape (Samaya AI), Michele Bevilacqua (Samaya AI), Fabio Petroni (Samaya AI), Percy Liang (Stanford University), “Lost in the Middle: How Language Model Use Long Contexts”, November 20, 2023, https://arxiv.org/pdf/2307.03172