イントロダクション
ランダム化比較試験(RCT)が組めない場面で、因果効果を推定するためによく使われる手法の一つが差分の差分法(Difference-in-Differences, DID)である。ある地域だけで新しい政策が始まった、ある店舗だけで新サービスを導入した、といった「自然実験」に近い状況で威力を発揮する。
例えば、あるECサイトが特定の都市でだけ送料無料キャンペーンを始めたとする。そのキャンペーンにどれだけ効果があったかを知りたいとき、素朴には「キャンペーン前後の売上を比べればよい」と思うかもしれない。しかしこれには落とし穴がある。DIDは、この落とし穴を回避するために生まれた手法である。
なぜ単純な比較ではダメなのか
先ほどの例で、キャンペーン前後の売上を単純に比べる方法を考えてみる。もし比較期間の途中でボーナス期に入っていたら、キャンペーンをしなくても売上は伸びていたはずである。つまり単純な前後比較は、時間とともに起きる他の変化(季節性、景気、競合の動きなど)と、施策の効果を混同してしまう。
では、キャンペーンをした都市と、しなかった都市を比べればよいのだろうか。これにも問題がある。2つの都市はそもそも施策と関係なく売上水準が違うかもしれない。この差を「施策の効果」と取り違えてしまう。
DIDのアイデアはシンプルである。「介入群の前後差」から「対照群の前後差」を引き算することで、時間トレンドの影響(両群に共通して乗る変化)と、そもそもの水準差(時間によらず一定の差)の両方を打ち消す。残るのが施策そのものの効果、というわけである。
基本の数式
DID推定量は、次のように定義される。
実務でよく使われるのは、これと数学的に同値な回帰式による表現である。
ここで $\mathrm{Treat}_i$ は個体 $i$ が介入群なら1、$\mathrm{Post}_t$ は時期 $t$ が介入後なら1を取るダミー変数である。この交差項の係数 $\beta_3$ がDID推定量そのものであり、コントロール変数を足したり、標準誤差をクラスタリングしたりといった拡張がしやすいため、回帰の形で実装されることが多い。
具体例で計算してみる
送料無料キャンペーンをA市(介入群)で実施し、似た規模のB市(対照群)は実施しなかったとする。それぞれの月間売上(単位:百万円)が次のようになったとしよう。
| 介入前 | 介入後 | 差(後−前) | |
|---|---|---|---|
| A市(介入群) | 50 | 90 | +40 |
| B市(対照群) | 60 | 70 | +10 |
| 差分の差(DID) | +30 |
A市の売上は40伸びているが、そのうち10は(B市も同じように伸びていることから分かる)市場全体の追い風によるものであり、キャンペーン自体による押し上げ効果は 40 − 10 = 30 と推定される。
グラフで見るDID
DIDは折れ線グラフに描くと直感的に理解しやすい。介入前の期間は両群とも同じ傾きで伸びており(平行なトレンド)、介入後に介入群だけが上に跳ね上がる。もし介入がなかったら介入群はどうなっていたか、という「反実仮想」を、対照群と同じ傾きの点線で延長すると、実測値との間にギャップが生まれる。このギャップがDID推定値である。
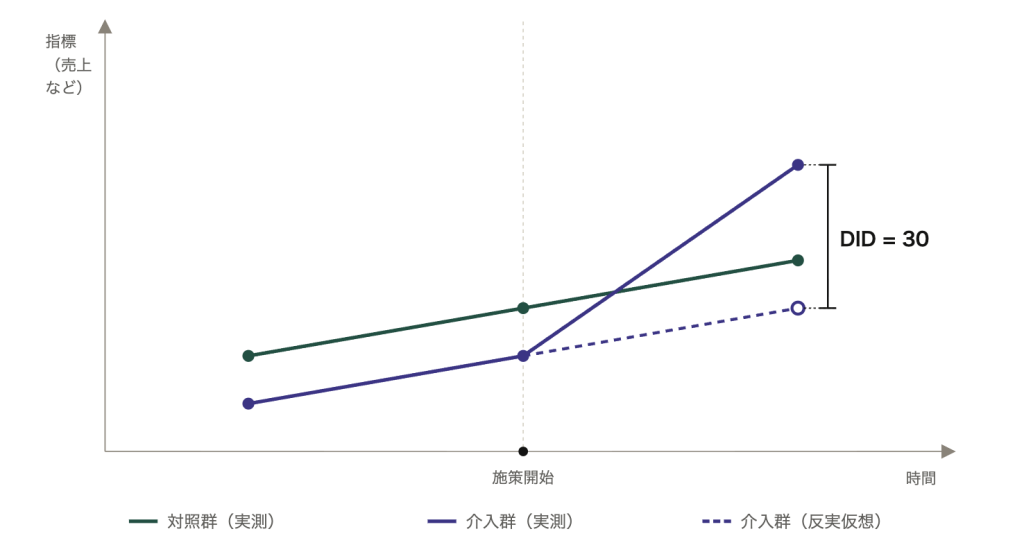
図1: 介入前は2群とも平行に推移する。介入群の実測値(紫の実線)と、対照群と同じ傾きで伸びたと仮定した反実仮想(紫の点線)とのギャップがDID推定値になる。
平行トレンドの仮定
DIDが成り立つための核心的な仮定は平行トレンドの仮定(Parallel Trends Assumption)である。「もし介入群が介入を受けなかったなら、対照群とまったく同じトレンドを辿っていたはずだ」という仮定であり、これが崩れていると図1の反実仮想の点線が誤った位置に引かれ、DID推定値にバイアスが乗る。
この仮定はデータから完全に証明することはできないが、間接的に裏付けることはできる。代表的なのが次の2つである。
- プレトレンドの確認: 介入前の複数期間について、介入群と対照群の推移が実際に平行だったかを確認する。図1でいえば「2期前→介入直前」の傾きが両群でそろっているかを見る。ここが平行でなければ、介入後の平行トレンド仮定も疑わしくなる。
- プラセボテスト: 実際には何も起きていない架空の時点を「介入時点」だと仮定してDIDを計算し、効果がゼロに近いことを確認する。有意な「効果」が出てしまう場合、平行トレンドの仮定に疑いが生じる。
拡張
前章で見た通り、DIDの成否は平行トレンドの仮定にかかっている。しかし現実には、使える対照群の推移が介入群の事前トレンドとぴったり平行とは限らない。この弱点に対応する拡張として近年注目されているのがSynthetic Difference-in-Differences(SDID)である。
合成コントロール法(Synthetic Control Method)
SDIDの土台には、合成コントロール法(Synthetic Control Method, SCM)という別の手法がある。SCMは、単一の対照群をそのまま使う代わりに、複数の候補地域(例えば介入のなかった他の都道府県)に重み $\omega_i$ を付けて足し合わせ、「介入前の推移が介入群と最もよく一致する合成対照群」を人工的に作り出す。平行でない対照群しか手元になくても、複数を組み合わせることで平行に近いトレンドを作れるのが利点である。
ただしSCMには弱点もある。SCMは水準(レベル)を合わせることに主眼を置いており、DIDのような「前後の差」を取る操作をしないため、介入群にもともと存在する時間不変のズレ(トレンドには影響しないが水準には効いてくる要因)が残ってしまう場合がある。
SDID:両者のいいとこ取り
SDID(Arkhangelsky et al., 2021)は、DIDの「差分を取ることで時間不変の要因を消す」という強みと、SCMの「重み付けで事前トレンドを揃える」という強みを組み合わせる。具体的には、対照群に対する個体の重み $\omega_i$(介入前の推移が介入群に近い対照群ほど大きな重みを持つ)と、時点の重み $\lambda_t$(介入後の期間と類似した推移をしている介入前の時点ほど大きな重みを持つ)の両方を推定した上で、重み付きのDID回帰を行う。
ここで $\alpha_i$・$\beta_t$ は個体・時点の固定効果、$W_{it}$ は介入を受けたかどうかのダミーである。重み $\hat{\omega}_i,\hat{\lambda}_t$ を通常のDID(全対照群・全期間を等しく扱う)から最適化し直すことで、素朴なDIDより事前トレンドのズレに頑健になり、かつSCMより変動(分散)の少ない安定した推定量になることが示されている。
- 向いている場面: 介入群が1つか少数で、候補となる対照群(都道府県、店舗、企業など)が多数あるケース。ミニマムウェイジの効果分析など、政策評価の文脈で特に使われる。
- 平行トレンドの仮定が緩和される: 手元の対照群がそのままでは平行でなくても、重み付けによって「介入群に似た動きをする合成対照群」を作れるため、仮定がやや緩くなる。
- 推論: プラセボ法やジャックナイフ法による標準誤差の推定方法が併せて提案されており、信頼区間の構築もサポートされている。
まとめ
- DIDは「介入群の前後差」から「対照群の前後差」を引くことで、時間トレンドと群間のもともとの水準差を同時に取り除く手法である。
- 回帰式では、Treat×Postの交差項の係数がDID推定量に対応する。
- 成立の鍵は平行トレンドの仮定であり、プレトレンドの確認やプラセボテストで間接的に裏付ける。
- 介入のタイミングが群ごとに異なる現実のデータでは、単純な二元固定効果モデルがバイアスを持つ場合があり、近年はより頑健な推定量が提案されている。