イントロダクション
機械学習モデルは、たいてい「来月の売上は100万円」のように1つの値(点予測)で答えを返す。しかし実務で本当に知りたいのは、「その予測はどれくらい外れうるのか」である。在庫の発注量を決めるときも、医療で予後を予測するときも、「80〜120万円の間に入る可能性が高い」といった幅のある答えのほうが意思決定に使いやすい。
予測の幅を出す従来の方法には、誤差が正規分布に従うと仮定するもの、ベイズモデルを組むもの、複数モデルのばらつきを使うものなどがある。しかしいずれも、置いた仮定やモデルそのものが正しいことに保証が依存している。
Conformal予測(Conformal Prediction)は機械学習の不確実性評価の手法として注目されている。次の3つの特徴を持つ。
- モデルに依存しない: ランダムフォレストでもニューラルネットでも、学習済みのモデルを一切いじらずに、外側から区間を作れる。
- 分布を仮定しない: 誤差が正規分布に従う、といった仮定が要らない。
- 有限サンプルで保証がある:「真の値が区間に入る確率は少なくとも90%」という保証が、データ数が少なくても成り立つ。
また予測区間と信頼区間は別物である。信頼区間は「平均などのパラメータ」の不確実性を表すのに対し、予測区間は「次に観測される1件の値」がどの範囲に入るかを表す。後者は個々のデータ自体のばらつきも含むため、一般に広くなる。Conformal予測が作るのは予測区間である。
基本のアイデア:過去のズレから区間の幅を決める
発想はとても素朴である。「このモデルは、過去のデータでどれくらい外していたか」を調べ、その外れ具合の実績をそのまま区間の幅に使う。たとえば、過去の予測の9割は誤差が12万円以内に収まっていたなら、新しい予測にも「±12万円」の区間をつければ、9割くらいは当たるだろう、という考え方である。
この「外れ具合」を数値にしたものを非適合度スコア(nonconformity score)と呼ぶ。回帰で最もよく使われるのは、予測値と実測値の差の絶対値である。
$$
s_i = |y_i – \hat{f}(x_i)|
$$
スコアが大きいほど、そのデータはモデルの予測と食い違っている(モデルにとって「意外なデータ」である)ことを表す。
Split Conformalの手順
最も基本的な実装がSplit Conformalである。データを2つに分け、片方でモデルを学習し、もう片方(キャリブレーション用データ)で外れ具合を測る。
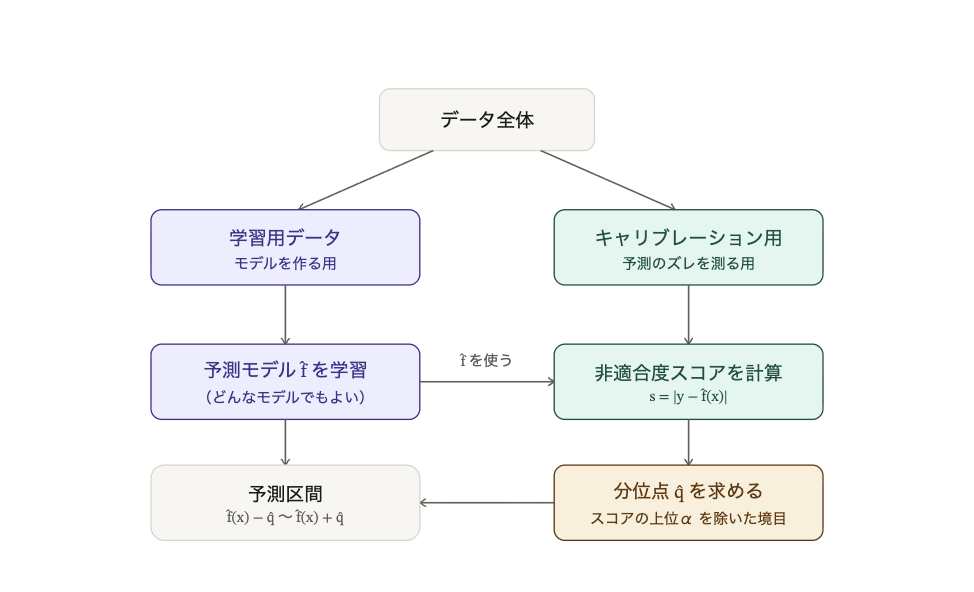
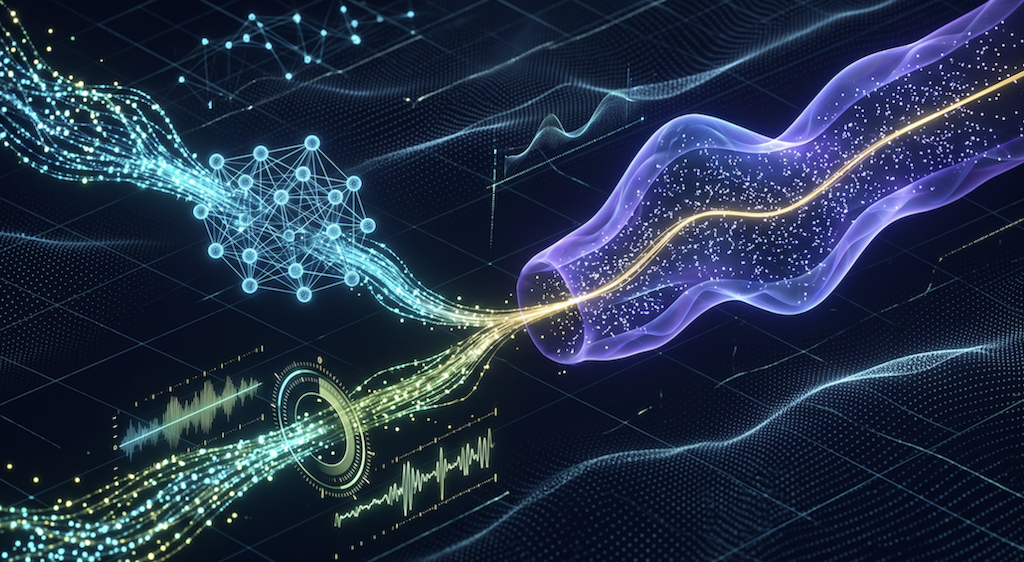
図1: モデルの学習(紫)とズレの測定(緑)を別々のデータで行い、そこから求めた分位点 $\hat{q}$(黄)を予測値の前後に足し引きして区間にする。
手順を式で書くと次のようになる。キャリブレーション用データの件数を $n$、欲しい被覆率を $1-\alpha$(例:$\alpha = 0.1$ なら90%)とする。
- 学習用データでモデル $\hat{f}$ を学習する。
- キャリブレーション用の各データについて、スコア $s_i = |y_i – \hat{f}(x_i)|$ を計算する。
- $n$ 個のスコアのうち、小さい方から $k = \lceil (n+1)(1-\alpha) \rceil$ 番目の値を $\hat{q}$ とする。
- 新しい入力 $x$ に対する予測区間を次のように定める。
$$
C(x) = \left[ \hat{f}(x) – \hat{q},\ \hat{f}(x) + \hat{q} \right]
$$
具体例
キャリブレーション用データが19件、90%の区間が欲しい($\alpha = 0.1$)とする。$k = \lceil (19+1) \times 0.9 \rceil = 18$ なので、スコア(単位:万円)を小さい順に並べて18番目の値を取る。
1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6, 7, 8, 8, 9, 10, 11, 12, 15
18番目は12なので $\hat{q} = 12$ となる。新しいデータに対するモデルの予測が100万円なら、予測区間は $[88,\ 112]$ である。
実装例
Split Conformalは数行で書ける。モデルは何でもよい。
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split

# 1. データを学習用とキャリブレーション用に分ける
X_tr, X_cal, y_tr, y_cal = train_test_split(X, y, test_size=0.5, random_state=0)

# 2. 任意のモデルを学習する
model = RandomForestRegressor().fit(X_tr, y_tr)

# 3. キャリブレーション用データで非適合度スコアを計算する
scores = np.abs(y_cal - model.predict(X_cal))

# 4. 分位点 q_hat を求める(alpha=0.1 なら90%区間)
alpha = 0.1
n = len(scores)
k = int(np.ceil((n + 1) * (1 - alpha)))
# k が n を超える場合(n が小さすぎる場合)は q_hat = 無限大(区間は無限幅)
q_hat = np.sort(scores)[k - 1]

# 5. 新しいデータの予測区間
pred = model.predict(X_new)
lower, upper = pred - q_hat, pred + q_hat
なぜ保証が成り立つのか
この方法がなぜ「真の値が区間に入る確率は少なくとも 1−α」と言えるのか。鍵になるのは交換可能性(exchangeability)という性質である。これは、データの並び順を入れ替えても同時確率が変わらないことを指し、i.i.d.(独立同分布)であれば満たされる。
新しいデータのスコア $s_{n+1}$ と、キャリブレーション用の $n$ 個のスコアを合わせた $n+1$ 個を考える。これらは交換可能なので、$s_{n+1}$ が小さい方から何番目に来るかは、どの順位も同じ確率 $1/(n+1)$ になる(同じ値が出ないとする)。したがって、$s_{n+1}$ が小さい方から $k$ 番目以内に入る確率は $k/(n+1)$ である。
ここで $k = \lceil (n+1)(1-\alpha) \rceil$ と選んでおけば、$k/(n+1) \geq 1-\alpha$ となる。そして「$s_{n+1}$ が小さい方から $k$ 番目以内」であることは、「$s_{n+1} \leq \hat{q}$」と同じ意味であり、これはまさに「真の値 $y_{n+1}$ が区間 $\left[ \hat{f}(x_{n+1}) – \hat{q},\, \hat{f}(x_{n+1}) + \hat{q} \right]$ に入る」ことと同値である。
$$
1 – \alpha \leq P\left( Y_{n+1} \in C(X_{n+1}) \right) \leq 1 – \alpha + \frac{1}{n+1}
$$
右側の不等式(上限)は、スコアに同じ値がないときに成り立つ。つまり被覆率は、目標の 1−α を下回らず、かつ大きく上回りすぎることもない。式の中に $n$ ではなく $n+1$ が現れるのは、新しいデータ自身も順位づけの対象に含めて数えているためである。
なお、キャリブレーション用データが少なすぎると、$(1-\alpha)$ に見合う順位 $k$ が $n$ を超えてしまい、区間が無限幅になる。また件数が少ないほど、実際の被覆率が目標値の周りで大きくブレやすい。
保証の限界:平均的には当たるが、どこでも当たるとは限らない
ここまでの保証は周辺カバレッジ(marginal coverage)、つまり「あらゆる $x$ をまとめて平均したときに90%」という保証である。「この特定のユーザーについて90%」という、$x$ ごとの条件付きの保証ではない点に注意が必要である。
たとえば、$x$ が大きいほど予測のばらつきが大きくなるデータを考える。区間の幅が $x$ によらず一定だと、全体としては9割近くを覆えても、ばらつきの小さい領域では必要以上に広く、ばらつきの大きい領域では外れが集中してしまう。
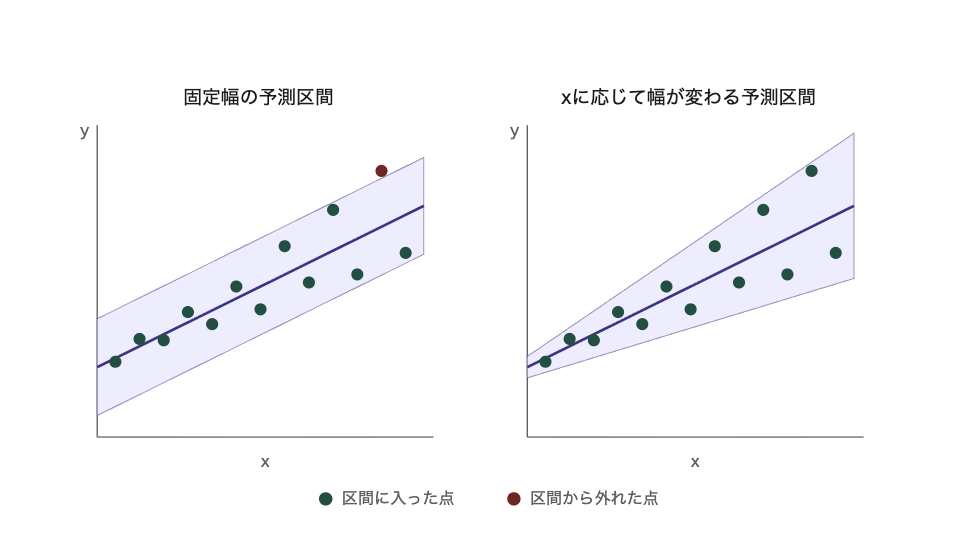
図2: 左は全体の約9割(13点中12点)を覆っているが、外れた点(赤)はばらつきの大きい右側に集中し、左側では必要以上に広い。右は区間の幅をxに応じて変えることで、どの領域でも同程度に覆えている。
この問題への対処として、区間の幅を x に応じて変える工夫が提案されている。代表的なのは、スコアを予測のばらつきの推定値 $\hat{\sigma}(x)$ で割って正規化する方法や、分位点回帰と組み合わせたConformalized Quantile Regression(CQR)である。ただし、分布を仮定しない限り、すべての $x$ で条件付きの保証を厳密に与えることは、有限サンプルでは原理的に難しいことが理論的に知られている。
分類への拡張:予測「集合」を返す
分類では、数値の区間ではなく予測集合を返す。非適合度スコアとして「正解クラスに割り当てた予測確率が低いほど大きくなる値」(例えば $1 – \hat{p}(y|x)$)を使い、回帰と同様に分位点 $\hat{q}$ を求める。新しいデータには、スコアが $\hat{q}$ 以下になるクラスをすべて集合に含めて返す。
たとえば画像分類で「{猫, 犬}」のように複数候補が返ることがある。モデルが自信を持てない入力では集合が大きくなり、自信がある入力では1つのクラスだけになる。「正解がこの集合に入る確率は90%以上」という保証つきで、モデルの迷いを表現できる。
交換可能性が崩れるとき
保証の前提である交換可能性は、現実には崩れることがある。
- 共変量シフト: 学習・キャリブレーション時と運用時で、x の分布が異なる場合。尤度比で各データに重みをつける重み付きConformal予測が提案されている。
- 時系列: データに時間的な依存があり、順序を入れ替えられない場合。実際の被覆率を見ながら目標の $\alpha$ を逐次調整するAdaptive Conformal Inferenceなどが提案されている。
実装
PythonではMAPIE(scikit-learn-contribの一つ)が広く使われている。scikit-learn互換のAPIで、回帰・分類・時系列に対応しており、PyTorchやTensorFlowのモデルもラッパー経由で使える。MAPIEはv1でAPIが大きく変更されているため、使うときは公式ドキュメントでバージョンごとの書き方を確認するのが安全である。
まとめ
- Conformal予測は、学習済みのどんなモデルにも後付けで、分布を仮定せずに予測区間(または予測集合)を与える手法である。
- キャリブレーション用データで測った予測の外れ具合(非適合度スコア)の分位点を、そのまま区間の幅に使う。
- 交換可能性のもとで、有限サンプルでも「真の値が区間に入る確率は 1−α 以上」が保証される。
- 保証されるのは全体として平均した被覆率であり、$x$ ごとの条件付きの被覆率ではない。幅を x に応じて変える工夫(CQRなど)が必要になる場面がある。
- 交換可能性が崩れる場面(共変量シフト、時系列)には、重み付きConformalやAdaptive Conformal Inferenceなどの拡張がある。