はじめに
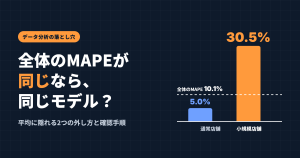
モデルに特徴量を一つ追加したら、テストデータのMAPEが0.5ポイント下がりました。この差は本物でしょうか。それとも、偶然によるものでしょうか。
こういうときに便利なのがブートストラップによる信頼区間です。数式で標準誤差を求めにくい指標でも、データを復元抽出し直すだけで区間を出せます。
ただし、出し方を誤ると区間が狭すぎたり、差があるのに「差はない」と判断したりします。この記事では、そうした落とし穴を3つ取り上げ、人工データの実験で確かめます。
ブートストラップとは
ブートストラップとは、手元のデータから復元抽出でサンプルを作り直し、統計量のばらつきを調べる手法です。手順は3ステップです。
- 手元のデータ(n件)から、同じn件を復元抽出する(同じデータが何度選ばれても良い)
- 抽出したデータで、知りたい統計量(平均、MAPEなど)を計算する
- 1と2を数千回くり返し、得られた統計量の分布から区間を作る
95%信頼区間は、例えば次のように作ります(パーセンタイル法)
95%CI = [B個の統計量の2.5パーセント点, B個の統計量の97.5パーセント点] (B:繰り返しの回数)
本当は「母集団からサンプルを取り直したら、統計量がどれだけばらつくか」を知りたいのです。しかし、母集団から取り直すことはできません。そこで、手元のデータを母集団の代わりとみなします。これをプラグイン原理と呼びます。
この考え方から、うまくいく条件も見えてきます。
- 手元のデータが、母集団をそれなりに代表していること
- 統計量が、データの小さな変化に対して滑らかに変わること(平均やMAPEは満たす。最大値は満たさない)
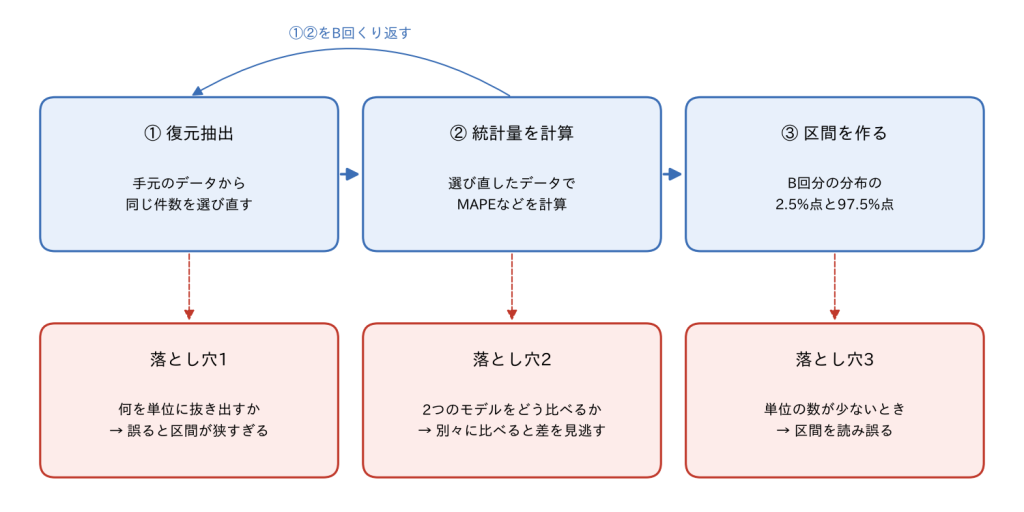
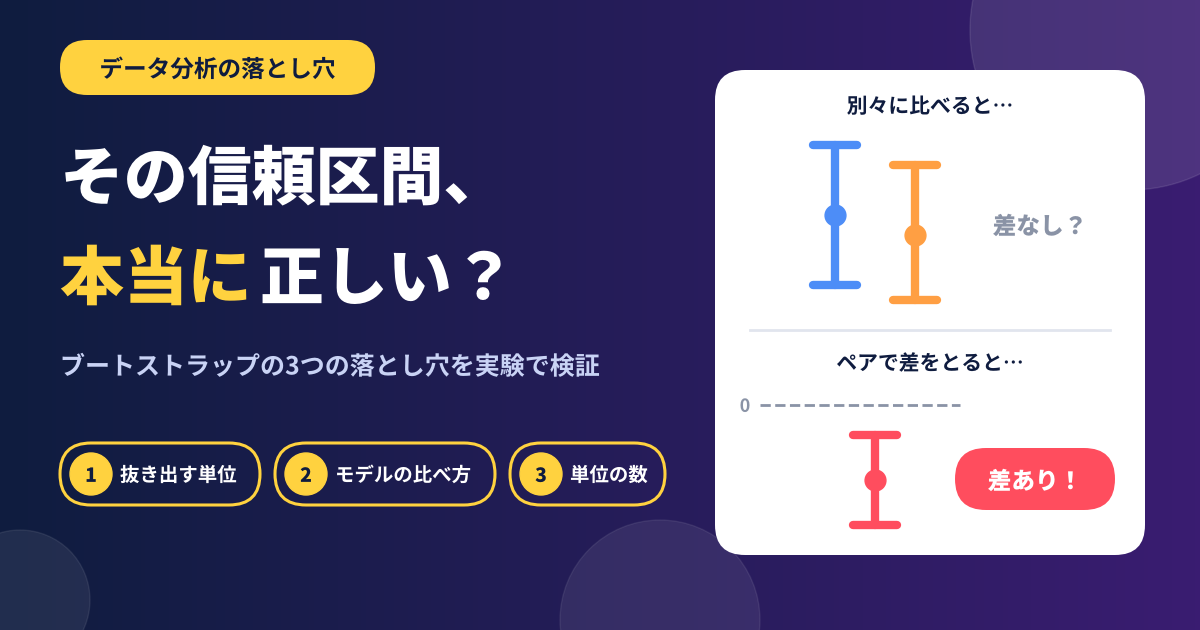
上の図は、手順のどこに落とし穴があるかを示したものです。落とし穴1は手順1の「何を単位に抜き出すか」、落とし穴2は手順2の「2つのモデルをどう比べるか」、落とし穴3は手順3の「単位の数が少ないときの区間の読み方」にあたります。
種類の整理
ブートストラップには、「何を単位に抜き出すか」と「どう区間を作るか」の2つの選択肢があります。まず、抜き出す単位を整理します。
| 抜き出す単位 | 向いているデータ | 単位を誤ると起きること |
| 行単位 | 各行が互いに独立なデータ | 相関のあるデータでは区間が狭くなりすぎる |
| クラスター単位 | 店舗・顧客・ユーザーなど、同じ単位内で相関があるデータ | 単位の数が少ないと区間が不安定になる |
| 層化(グループ内で抽出) | グループの構成比を保ちたいデータ | 少数グループが0件になったり増えすぎたりする |
| ブロック単位 | 自己相関の強い時系列データ | ブロックが短すぎると相関が切れ、長すぎると多様性がなくなる |
次に区間の作り方を説明します。
| 手法 | 考え方 | 計算コスト | 使いどころ |
| パーセンタイル法 | 分布の2.5%点と97.5%点をそのまま使う | 低い | 探索段階、分布がほぼ左右対称のとき |
| ベーシック法 | 推定値のずれを反転させて補正する | 低い | 偏りが小さい時 |
| BCa法 | 偏りと分散の変化を補正する | 中程度 | 分布が歪んでいるとき。迷ったらこれ |
| スチューデント化法 | t統計量の分布を作る | 高い(二重ブートストラップ) | 精度を最優先するとき |
この記事の実験では、仕組みを見やすくするためにパーセンタイル法を使います。PythonではSciPyのscipy.stats.bootstrapでmethod=’BCa’を指定すれば、BCa法も簡単に使えます。
実験
3つの落とし穴を、Google Colabで確かめます。データは人工的に作ります。60店舗の需要と、2つのモデル(ベースラインと改善版)の予測値です。店舗ごとに「予測が上振れしやすい」などの癖を持たせ、同じ店舗同士の行に相関が出るようにしました。60店舗のうち15店舗は「少数」のセグメントとし、実験Cで使います。
実験コード
import os
import numpy as np, pandas as pd, matplotlib.pyplot as plt
import japanize_matplotlib

# 人工データ:60店舗×90日。店舗ごとの癖(bias)で、同じ店舗の行どうしに相関を持たせる
rng = np.random.default_rng(42)
rows = []
for s in range(60):
    seg = "少数" if s < 15 else "通常"
    level, bias = rng.uniform(50, 300), rng.normal(0, 0.08)
    for d in range(90):
        y = max(1, level * (1 + rng.normal(0, 0.2)))
        base = y * (1 + bias + rng.normal(0, 0.12))        # ベースライン
        new = y * (1 + bias * 0.8 + rng.normal(0, 0.12))   # 癖が少し小さい改善版
        rows.append((s, seg, y, base, new))
df = pd.DataFrame(rows, columns=["store", "seg", "y", "pred_base", "pred_new"])
df["row"] = np.arange(len(df))

def boot_mape(d, unit, B=2000, seed=0):
    """unit列の単位で復元抽出し、2モデルのMAPEをB回計算する(同じ抽出を両方に使う=ペア)"""
    agg = lambda p: (abs(d[p] - d.y) / d.y).groupby(d[unit]).agg(["sum", "count"])
    a, b = agg("pred_base"), agg("pred_new")
    k = len(a)
    W = np.random.default_rng(seed).multinomial(k, np.ones(k) / k, size=B)  # 各単位が選ばれた回数
    mape = lambda t: W @ t["sum"].values / (W @ t["count"].values) * 100
    return mape(a), mape(b)

ci = lambda x: np.percentile(x, [2.5, 97.5])
point = lambda d, p: (abs(d[p] - d.y) / d.y).mean() * 100

# 実験A:行単位と店舗単位で、区間の幅を比べる
for unit in ["row", "store"]:
    a, _ = boot_mape(df, unit)
    lo, hi = ci(a)
    print(f"[A] {unit:5s} 単位: MAPE {point(df,'pred_base'):.2f}%  95%CI [{lo:.2f}, {hi:.2f}]  幅 {hi-lo:.2f}")

# 実験B:別々の区間と、ペアの差の区間を比べる(店舗単位)
a, b = boot_mape(df, "store")
diff_pt = point(df, "pred_new") - point(df, "pred_base")
for name, x, pt in [("ベースライン", a, point(df, "pred_base")),
                    ("改善版", b, point(df, "pred_new")),
                    ("差(改善版−ベース)", b - a, diff_pt)]:
    print(f"[B] {name}: 点推定 {pt:.2f}  95%CI [{ci(x)[0]:.2f}, {ci(x)[1]:.2f}]")
print(f"[B] 改善した割合 {np.mean(b - a < 0):.3f}")

# 実験C:店舗数が少ないセグメント(15店舗)で、差の区間を見る
small = df[df.seg == "少数"]
a_s, b_s = boot_mape(small, "store")
lo, hi = ci(b_s - a_s)
print(f"[C] 少数(15店舗): 差 {point(small,'pred_new')-point(small,'pred_base'):.2f}pt  95%CI [{lo:.2f}, {hi:.2f}]")

# 図2:別々の区間(左)とペアの差の区間(右)
fig, ax = plt.subplots(1, 2, figsize=(9, 3.5))
for i, (name, x, p) in enumerate([("ベースライン", a, "pred_base"), ("改善版", b, "pred_new")]):
    lo, hi = ci(x); pt = point(df, p)
    ax[0].errorbar(i, pt, yerr=[[pt - lo], [hi - pt]], fmt="o", capsize=8)
ax[0].set_xticks([0, 1], ["ベースライン", "改善版"]); ax[0].set_xlim(-0.5, 1.5)
ax[0].set_ylabel("MAPE(%)"); ax[0].set_title("別々の区間:重なって見える")
lo, hi = ci(b - a)
ax[1].errorbar(0, diff_pt, yerr=[[diff_pt - lo], [hi - diff_pt]], fmt="o", capsize=8, color="C3")
ax[1].axhline(0, color="gray", ls="--"); ax[1].set_xticks([0], ["改善版−ベースライン"])
ax[1].set_ylabel("MAPEの差(pt)"); ax[1].set_title("ペアの差の区間:0をまたがない")
plt.tight_layout(); os.makedirs("images", exist_ok=True); plt.savefig("images/fig2_paired.png", dpi=150)
plt.show()
実験A:抜き出す単位を間違えるとどうなるか
| 抜き出す単位 | ベースラインのMAPE | 95%信頼区間 | 区間の幅 |
| 行単位 | 11.45% | [11.22, 11.67] | 0.46 |
| 店舗単位 | 11.45% | [10.77, 12.26] | 1.49 |
点推定は同じでも、行単位の区間は店舗単位よりかなり狭く出ました(幅0.46と1.49で、約3分の1)。行単位では、同じ店舗の90日分を「90個の独立な情報として数えてしまいます。店舗間のばらつきが大きいデータほど、この差は開きます。
実験B:2つのモデルをどう比べれば良いか
| 対象 | 点推定 | 95%信頼区間 |
| ベースラインのMAPE | 11.45 | [10.77, 12.26] |
| 改善版のMAPE | 10.92 | [10.36, 11.62] |
| 差(改善版 – ベースライン) | -0.53 | [-0.86, -0.19] |
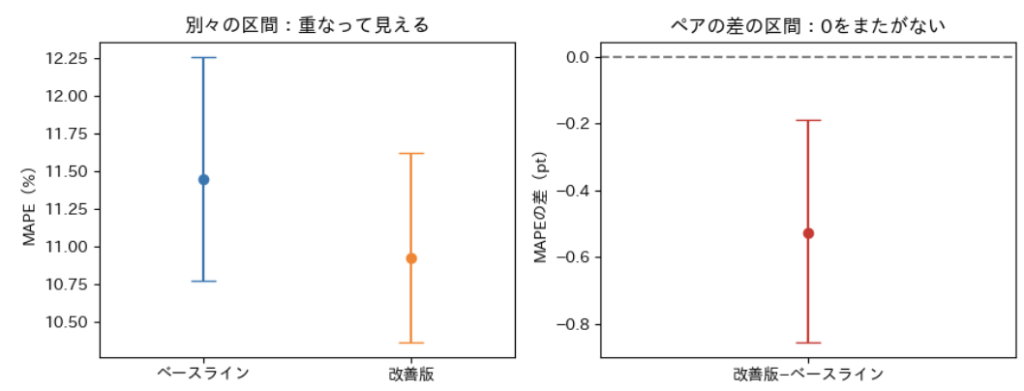
上の図の左のように、2つのモデルの区間は大きく重なっています。これだけを見ると「差はなさそう」と判断しがちです。一方、右の差の区間は0をまたいでいません。
この違いは、店舗の癖が両方のモデルに共通していることから生まれます。区間を別々に出すと、店舗の癖によるばらつきが両方の区間に入ります。差をとると、共通のばらつきが打ち消し合います。つまり、モデル間で誤差の傾向が似ている条件ほど、ペアで比べる効果が大きくなります。
リサンプル2000回のうち、改善版のMAPEの方が小さかった割合は99.8%でした。差の区間と合わせてみると、改善の方向がどれだけ安定しているかがわかります。ただしこれはあくまでリサンプルの中での割合で、「改善の方がいい確率」とは厳密には別物です。
実験C:店舗数が少ないと、どうなるか
| 対象 | 店舗数 | 差の点推定 | 差の95%信頼区間 |
| 少数セグメント | 15 | -0.26pt | [-0.80, 0.25] |
15店舗に絞ると、差の点推定は改善の方向でも、区間は0をまたいでいます。このとき「改善の効果はない」と書くのは誤りです。正しくは「この店舗数では、効果があるかどうかは判断できない」です。
見分け方
自分のデータでどう抜き出せばよいかは、次の4つの問いを上から順にたどると決められます。
Q1. 同じ単位(店舗・顧客など)のデータが複数行あるか?
はい → その単位で抜き出す(クラスター単位)
いいえ → 行単位でよい
Q2. 時系列で、前後の日の値が強く似ているか?
はい → 連続した期間をまとめて抜き出す(ブロック単位)
いいえ → Q3へ
Q3. 2つのモデルを比べたいか?
はい → 同じ抜き出しを両方に使い、差の区間を見る(ペア)
いいえ → 指標の区間を見る
Q4. 抜き出す単位の数は十分か?(目安:30以上)
はい → 区間をそのまま読む
いいえ → 区間が0をまたぐなら「判断できない」と報告する
目安の30は、あくまで出発点です。単位ごとのばらつきが大きいデータでは、もっと多くの単位が必要になることがあります。
対処法
3つの落とし穴への対処法を、効く条件と合わせてまとめます。
| 落とし穴 | 対処 | 効きやすい条件 | 効きにくい条件 |
| 1 単位を誤って区間が狭くなる | 相関のある単位で抜き出す | 単位間のばらつきが大きい | 単位内の相関がほぼない |
| 2 別々の区間で比べて差を見逃す | 同じ抜き出しで差の区間を見る | 2モデルの誤差の傾向が似ている | 2モデルの誤差がほぼ無関係 |
| 3 単位が少なく区間を読み誤る | 「判断できない」と報告し、単位を増やす | 単位を追加で集められる | 単位の数が構造的に限られている |
もう一つ気をつけたいのが、MAPEの性質です。実績値が0に近い行があると、その行の誤差率が極端に大きくなり、区間がそれに引っ張られます。ブートストラップ分布のヒストグラムを描き、歪みや山が2つある形になっていないかを確認しておくと安心です。
まとめ
最初の問いは「MAPEが0.5ポイント下がった。この差は本物か?」でした。
ブートストラップで答えを出すには、3つの点に気をつける必要があります。まず、相関のある単位で抜き出すことです。行単位で抜き出すと、区間が実際より狭く出て、差を過大に信じてしまいます。次に、2つのモデルを別々の区間で比べず、同じ抜き出しを使って差の区間を見ることです。モデル間で誤差の傾向が似ているときほど、別々の区間は重なって見えやすく、差を見逃しやすくなります。最後に単位の数が少ないときは、区間が0をまたいでも「効果なし」とは言えず、「判断できない」と読むことです。
この3点を押さえれば、ブートストラップの区間は、精度改善の効果を判断するための頼れる材料になります。