イントロダクション
「クーポンをもらった人のほうが、たくさん買っている」。これは、クーポンの効果と言えるでしょうか?
そうとは限りません。マーケティングチームが「もともとよく買ってくれる優良顧客」を狙って配っていた場合、クーポンをもらった人は、クーポンがなくても多く買っていた人たちです。単純に比べると、クーポンの効果と「もともと優良顧客だったこと」の効果が混ざってしまいます。
これを防ぐ一番確実な方法は、対象者をランダムに「あり」「なし」に振り分けるランダム化比較試験(RCT)です。しかし、倫理的に難しい、顧客への説明に困る、すでに施策が始まっている、といった理由で、RCTを組めないことも多くあります。そこで、手元の観測データから「RCTを行ったかのような比較」をつくる手法として、傾向スコアマッチング(PSM)と逆確率重み付け法(IPW)を紹介します。
傾向スコアとは
傾向スコア(Propensity Score)とは、「ある人の特徴が与えられたときに、その人が施策を受ける確率」のことです。
- 入力と出力: 購入頻度や会員歴などの特徴 $x$ から、0〜1の確率を出します(0.8なら、クーポンを受け取りやすい人)
- 求め方: 施策を受けたか($W$)を目的変数にした、ロジスティック回帰などで推定します
傾向スコアが同じなら、施策の有無によらず観測された特徴の分布がそろいます。つまり、購入頻度や会員歴などの特徴を、傾向スコアという1つの数字にまとめて比較することができます。
注意点:傾向スコアは「効果の大きさ」ではありません。傾向スコアが高い人は「クーポンを受け取りやすい人」であって、「クーポンの効果が大きい人」ではありません。
傾向スコアマッチング(PSM)
PSMは、「傾向スコアが近い人同士をペアにして、結果の差を比べる」手法です。介入群(クーポンあり)それぞれに、傾向スコアが近い対照群(なし)の人をペアにして、ペアごとの差を平均します。
$\hat{\tau}_{\mathrm{ATT}} = \frac{1}{N_1}\sum_{i: W_i=1}\left(Y_i – Y_{j(i)}\right)$
$N_1$ は介入群の人数、$j(i)$ は個体 $i$ のペアになった対照群の個体です。
数値例で理解する
架空の9人を使います。傾向スコアが近い順にペアを作り、同じ対照群の人は1回しか使いません。単位は千円です。
| 顧客 | クーポン | 傾向スコア | 月間購入額(千円) | ペア |
|---|---|---|---|---|
| A | あり | 0.80 | 12 | E |
| B | あり | 0.70 | 10 | F |
| C | あり | 0.40 | 6 | G |
| D | あり | 0.30 | 4 | H |
| E | なし | 0.78 | 10 | A |
| F | なし | 0.68 | 9 | B |
| G | なし | 0.42 | 5 | C |
| H | なし | 0.28 | 2 | D |
| I | なし | 0.10 | 1 | (使われない) |
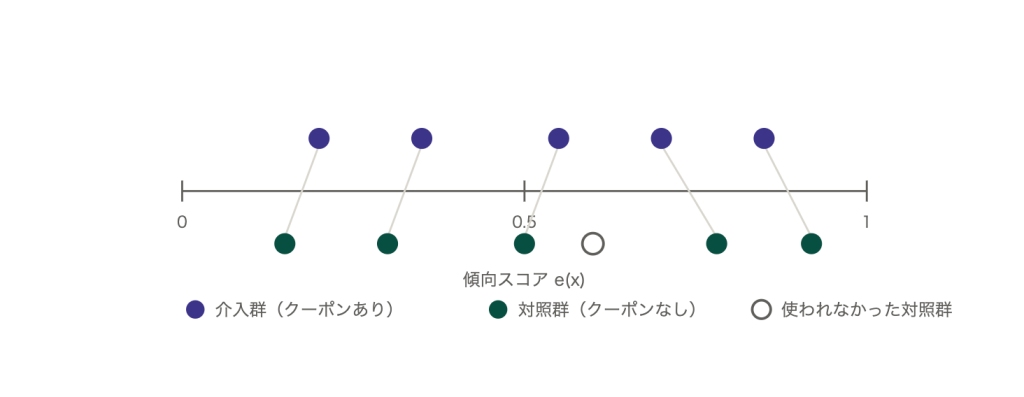
図1: 上の表の9人を、傾向スコアの数直線に並べた図。線で結ばれた組(A–E、B–F、C–G、D–H)がペア。傾向スコアが0.10と低い I には、近い介入群の人がいないので、使われない。
- ① 単純に比べると: あり $\frac{12+10+6+4}{4}=8.0$、なし $\frac{10+9+5+2+1}{5}=5.4$ → 差は $8.0-5.4=2.6$
- ② PSMで比べると: ペアごとの差は $2,\ 1,\ 1,\ 2$ → 平均 $\frac{2+1+1+2}{4}=1.5$
単純な比較では2,600円増えたように見えますが、PSMでは1,500円です。差の1.1千円は、「もともとよく買う人にクーポンが集中していた」ことによる見かけの効果です。
注意点:顧客Iのように、近い介入群の人がいない場合は、比較から外れます。PSMで推定しているのは、「クーポンを受け取った人にとっての効果(ATT)」です。この例は仕組みの理解用で、実際の分析ではずっと多くのデータを使います。
逆確率重み付け法(IPW)
IPWは、「全員のデータを使うが、その処置を受けにくかった人ほど大きな重みをつけて集計する」手法です。ペアを作る代わりに、重みで人数をそろえます。
$\hat{\tau}_{\mathrm{IPW}} = \frac{1}{n}\sum_{i=1}^{n}\left[\frac{W_iY_i}{\hat{e}(X_i)} – \frac{(1-W_i)Y_i}{1-\hat{e}(X_i)}\right]$
重みは、「自分が実際に受けた処置を受ける確率」の逆数です。クーポンを受け取った人は $\frac{1}{\hat{e}(X_i)}$、受け取っていない人は $\frac{1}{1-\hat{e}(X_i)}$ です($\hat{e}(X_i)$ は推定した傾向スコア)。
数値例で理解する
手計算しやすいように、顧客を2つの層に分けた単純な例を使います(架空のデータ、単位は千円)。
| 層 | 人数 | あり | なし | 傾向スコア | 平均購入額(あり) | 平均購入額(なし) |
|---|---|---|---|---|---|---|
| 低頻度層 | 100 | 20 | 80 | 0.2 | 3.0 | 2.0 |
| 高頻度層 | 100 | 80 | 20 | 0.8 | 9.0 | 8.0 |
それぞれの層の中だけで比べると、差はどちらも +1.0 です。
- ① 単純に比べると: あり $\frac{20\times3.0+80\times9.0}{100}=7.8$、なし $\frac{80\times2.0+20\times8.0}{100}=3.2$ → 差は $7.8-3.2=+4.6$
- ② 重みを計算する: 低頻度層は、あり $\frac{1}{0.2}=5$、なし $\frac{1}{0.8}=1.25$。高頻度層は、あり $\frac{1}{0.8}=1.25$、なし $\frac{1}{0.2}=5$。人数 × 重みは、$20\times5=80\times1.25=100$ となり、4つのグループすべてが 100人分になります
- ③ 重み付き平均で比べると: あり $\frac{100\times3.0+100\times9.0}{200}=6.0$、なし $\frac{100\times2.0+100\times8.0}{200}=5.0$ → 差は $6.0-5.0=+1.0$
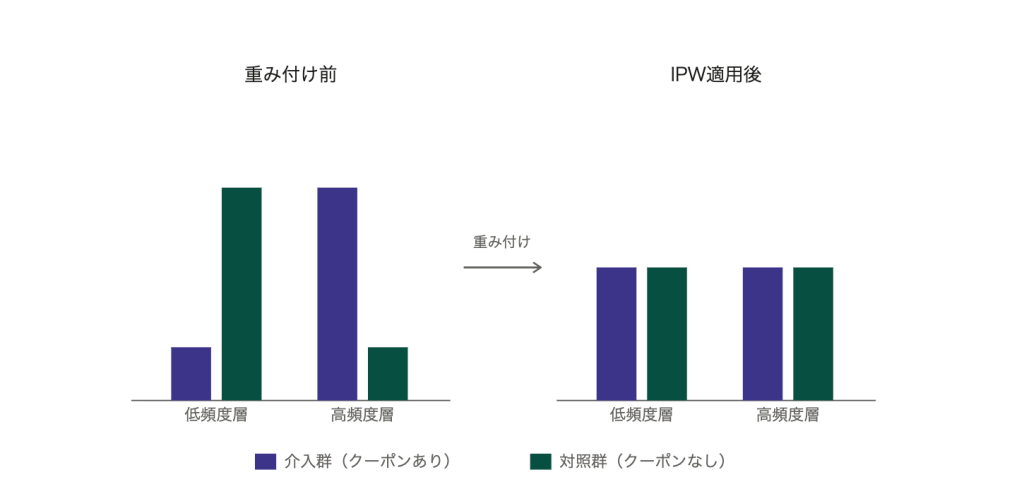
図2: 上の表の例を図にしたもの。重み付け前は、低頻度層ではクーポンをもらった人が少なく(20人)、高頻度層で多い(80人)。IPWで重み付けすると、4つのグループがすべて100人分にそろい、層の構成の違いが消える。
重みで「どの層にいたか」による偏りが消え、単純比較の+4.6が、各層の実際の効果である+1.0に戻ります。上の式に代入しても、$\frac{1200-1000}{200}=1.0$ と同じ値になります。なお、この式が推定するのは、PSMのATTと違い、「全員にとっての平均的な効果(ATE)」です。
注意点:傾向スコアが0.01の人が1人クーポンを受け取ると、重みは100になり、その1人が100人分として数えられます。推定が不安定になるので、重みに上限を設ける(トリミング)などで対処します。また、IPWと結果を予測する回帰モデルを組み合わせたAIPWは、どちらか一方のモデルが正しければよい(二重にロバスト)という性質を持ち、実務でよく使われます。
結果の確認と実務のポイント
調整のあとは、本当に特徴がそろったかを確認します。代表的な指標が**標準化平均差(SMD)**で、共変量の平均が2つのグループでどれだけ離れているかを、ばらつきを基準にした単位で表します。
$\mathrm{SMD} = \frac{\bar{x}_{\text{介入}} – \bar{x}_{\text{対照}}}{\sqrt{\frac{s_{\text{介入}}^2 + s_{\text{対照}}^2}{2}}}$
0に近いほど、特徴がそろっています。調整の前後で比べて、後のほうが小さくなっていれば、うまくいっています。傾向スコアのモデルが適切かどうかは、このバランスの確認で判断します。
| 確認すること | 目安・ポイント |
|---|---|
| 共通サポート | 傾向スコアの分布が、介入群と対照群で重なっているか。重ならない範囲は比較できない |
| バランス(SMD) | 0.1未満が目安(0.25を基準にする場合もある)。サンプルが少ないと、偶然の偏りで大きく出ることがある |
| キャリパー(PSM) | 傾向スコアのロジットの標準偏差の0.2倍が目安(平均の差を推定する場合) |
※ 目安は分野や目的によって調整が必要です。傾向スコアを使う手法には、PSM・IPWのほかに、層別化と共変量調整があります。
よくある誤解と注意点
- 観測していない要因は調整できません。 傾向スコアで調整できるのは、データに含まれている共変量だけです。「営業担当者の勘で配った」のに、その中身がデータにない場合、偏りは残ります。RCTのような保証はありません。
- 施策の後で測定された変数は入れません。 クーポン配布後の閲覧数のように、施策の結果として変わる変数を入れると、効果の一部を調整で消してしまいます。
まとめ
PSMは直感的で説明しやすい一方、ペアにならなかった人のデータは使われません。IPWは全員のデータを使えますが、極端な傾向スコアに弱いです。両方で推定して、結果が近いかを確認するのが安全です。
- 傾向スコア: 施策を受ける確率。効果の大きさではない
- PSM: 傾向スコアが近い人同士をペアにして比べる
- IPW: 受けた処置の起こりにくさの逆数で重みをつける。極端な傾向スコアに注意
- 限界: 調整できるのは観測した共変量だけ。調整のあとは、SMDなどで確認する
ATT(処置群における平均処置効果)やATE(平均処置効果)などの処置効果については、「処置効果入門:ATE・CATE・ITEの整理」をご参照ください。