イントロダクション
解約予測のモデルを作って、正解率を測ったら95%でした。優秀なモデルでしょうか?
実は、顧客1,000人のうち、解約するのが50人(5%)だけなら、「全員、解約しない」と予測するだけで、正解率は95%になります。ただしこのモデルは、解約する人を1人も見つけられません。
このように、一方のクラスが極端に少ないデータを、不均衡データと呼びます。この記事では、不均衡データへの対処法の1つであるSMOTE(Synthetic Minority Over-sampling Technique)を紹介します。SMOTEは、少数派のデータを増やすオーバーサンプリングの手法の1つです。
不均衡データとは
Chawla ら(2002)は、「分類するカテゴリが、おおよそ同じ数で現れていないデータ」を不均衡データと呼んでいます。現実のデータでは、「正常」な例が大半で、「異常」や「注目したい」例が、ごくわずかであることが多く、異常を正常と間違えるコストのほうが、その逆より大きいことも多いと指摘しています。解約、不正利用、故障、病気の検出などが、代表例です。
先ほどの例を、表にしてみます。
| 予測のしかた | 正解率 | 解約者を見つけた割合(再現率) |
|---|---|---|
| 全員「解約しない」と予測 | $95\%\,(950/1000)$ | $0\%\,(0/50)$ |
- 再現率: 実際の解約者のうち、見つけられた人の割合
- 適合率: 「解約する」と予測した人のうち、実際に解約した人の割合
意味:正解率だけを見ると、少数派を見つけられているかが分かりません。不均衡データでは、再現率、適合率、PR-AUC(適合率と再現率の関係を表す曲線の下の面積)などを見ます。
SMOTEとは
SMOTEは、「少数派のデータを、合成して増やし、クラスの数をそろえる」手法です。Chawla らが提案しました。
少数派を増やして、クラスの数をそろえる操作を、オーバーサンプリングと呼びます。反対に、多数派を減らす操作は、アンダーサンプリングと呼びます。SMOTEは、オーバーサンプリングの手法の1つです。
少数派を増やす一番単純な方法は、同じデータを複製することです(ランダムオーバーサンプリング)。しかし、複製では新しい情報が増えません。50人の解約者を950人にそろえるなら、同じ顧客が19回ずつ登場します。SMOTEは、複製ではなく、少数派の点と、その近くにある少数派の点を結ぶ線分の上に、新しい点(合成データ)を作ります。
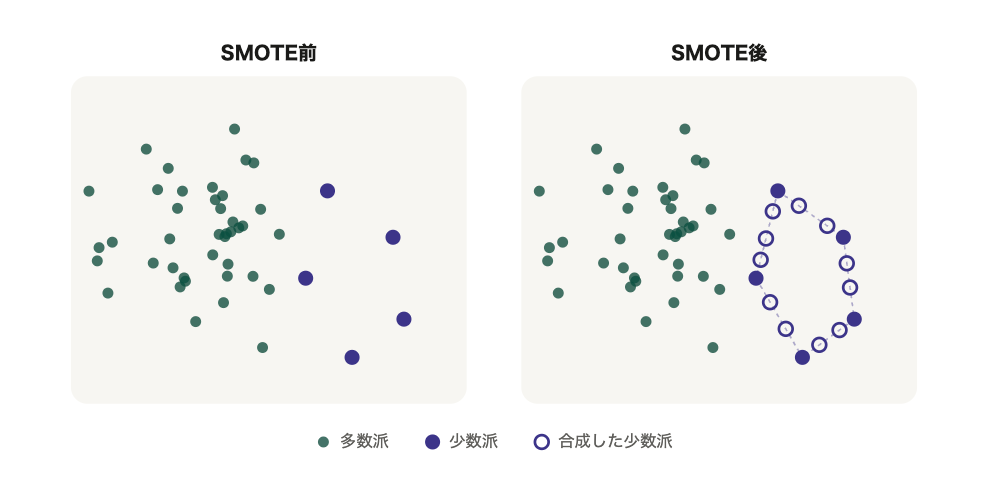
図1: SMOTEの前後。少数派(紫)の点と、その近くの少数派の点を結ぶ線(破線)の上に、合成データ(白抜きの丸)が加わる。
Chawla らは、SMOTEによる少数派の増加と、多数派を減らす操作(アンダーサンプリング)を組み合わせると、ROC空間での性能は、アンダーサンプリングだけの場合より良くなることを示しました。
SMOTEのしくみ
合成データは、次の4ステップで1つずつ作ります。
- 少数派のデータから、1つ選ぶ(点A)
- 少数派の中で、Aに近い順に k 個を探す(k 近傍。imbalanced-learn の既定値は $k=5$ です)
- その k 個から、ランダムに1つ選ぶ(点B)
- AとBを結ぶ線分上の、ランダムな位置に、新しい点を作る
新しい点は $x_{\mathrm{new}} = A + \lambda(B-A)$($\lambda \in [0,1]$ は一様乱数)です。
数値例で理解する
少数派が5人(A〜E)で、2つの特徴の値が次のようになっているとします(架空のデータ、$k=2$)。
| 点 | 特徴1 | 特徴2 | Aからの距離 |
|---|---|---|---|
| A | 2 | 3 | — |
| B | 4 | 3 | 2.00 |
| C | 3 | 6 | 3.16 |
| D | 1 | 1 | 2.24 |
| E | 6 | 5 | 4.47 |
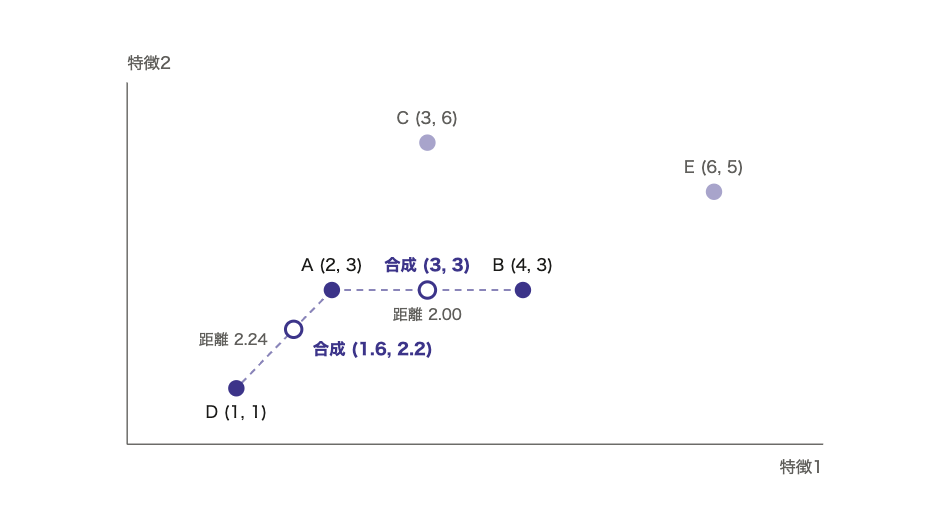
図2: 点Aから見て近い2点(B、D)のうち、Bを選んで $\lambda=0.5$ とすると (3, 3)、Dを選んで $\lambda=0.4$ とすると (1.6, 2.2) に、合成データができる。C、Eは、Aの近傍2点に入らない。
- ①② 点Aを選びます。Aに近い2点は、B(距離2.00)とD(距離2.24)です。
- ③④(Bを選んだ場合) $\lambda=0.5$ なら、$\left(2,3\right)+0.5\left((4,3)-(2,3)\right)=\left(3,3\right)$ です。
- ③④(Dを選んだ場合) $\lambda=0.4$ なら、$\left(2,3\right)+0.4\left((1,1)-(2,3)\right)=\left(1.6,2.2\right)$ です。
これを繰り返して、必要な数だけ合成データを作ります。件数は、次のように変わります。
| 多数派 | 少数派 | 合成データ | |
|---|---|---|---|
| 元のデータ | 950 | 50 | 0 |
| 多数派と同じ数にそろえる | 950 | 950 | 900 |
| $\frac{\text{少数派}}{\text{多数派}}=0.5$ にする | 950 | 475 | 425 |
imbalanced-learn の既定の設定では、少数派が多数派と同じ数になるまで増やします。比率を指定することもできます。
意味:合成データは、少数派の点の「あいだ」にできます。同じ点の複製と違って、少数派の点が、線分でつながれたように、領域として広がります。
注意点:合成データは、実在しない顧客のデータです。少数派の点が、離れていたり、多数派の点の中に紛れていたりすると、合成データが、多数派の領域に入り込むことがあります。
使うときの注意点
SMOTEは、データを分けてから、訓練データにだけ使います。全データにSMOTEをかけてから、訓練用とテスト用に分けると、テストデータの情報が、合成データを通じて訓練データに漏れます(データ漏洩)。imbalanced-learn のドキュメントでも、全データをリサンプリングしてから分割すると、性能が過大に見える、と説明されています。交差検証では、各分割の訓練側だけに適用します。
- テストデータは、元の分布のまま評価します。 現実のデータは不均衡なので、評価も、元の不均衡なデータで行います。
- 評価指標は、正解率ではなく、再現率・適合率・PR-AUCなどを使います。
- 予測した確率が、ゆがむことがあります。 ロジスティック回帰では、SMOTEなどの不均衡補正によって少数派に属する確率が大きく過大評価され(較正が悪化し)、AUCで測る識別性能は改善しなかったとの報告があります。確率そのものを使う場面(リスクの点数化など)では、特に注意が必要です。
- 強い分類器では、効果が小さいことがあります。 弱い分類器ではバランシングが性能を上げうる一方、XGBoostなどの強い分類器では、上がらなかったと報告しています。強い分類器では、バランシングと、しきい値の最適化は、同程度の性能でした。
- 数値でない特徴には、そのままでは使えません。 「点のあいだ」が意味を持たないためです。カテゴリが混ざるデータには、SMOTENCなどを使います。
SMOTEの仲間たち
SMOTEには、多くの派生手法があります。imbalanced-learn などで使える、代表的なものを挙げます。
| 手法 | 特徴 |
|---|---|
| Borderline-SMOTE | 少数派のうち、多数派との境界付近の点を中心に、合成データを作る |
| ADASYN | 学習が難しい少数派の点(周りに多数派が多い点)の周りに、より多く合成データを作る |
| SMOTENC / SMOTEN | SMOTENCは、数値とカテゴリが混ざったデータ、SMOTENは、カテゴリだけのデータに対応する |
| SMOTETomek / SMOTEENN | SMOTEで増やした後、境界付近の紛らわしい点を取り除く(それぞれ、Tomek links、ENNという方法を使う) |
| GraphSMOTE | グラフデータ(SNSの利用者どうしのつながりのような、ノードと辺でできたデータ)の、ノード分類向け。グラフニューラルネットワークで作った埋め込み空間で、少数派のノードを補間して合成し、合成したノードの辺(つながり)は、辺の生成器で予測する |
ほかの対処法との比較
SMOTEは、不均衡データへの唯一の対処法ではありません。
| 方法 | 内容 | ひとこと |
|---|---|---|
| しきい値の調整 | 「解約」と判定する確率のしきい値を、0.5から動かす | 学習データを変えずに済む。上の2つの研究で、SMOTEと同程度の改善が報告されている |
| クラス重み | 少数派の間違いを、より大きく罰する(scikit-learnの class_weight など) | データを増やさずに済む |
| ランダムオーバーサンプリング | 少数派のデータを、複製して増やす | 新しい情報は増えない。単純なランダムオーバーサンプリングが、SMOTEのような手法と同程度に有効だったとの報告があります |
| アンダーサンプリング | 多数派を減らす | 学習に使うデータが減る。Chawla らは、SMOTEと組み合わせている |
| 強い分類器を使う | 勾配ブースティングなどを使う | バランシングなしでも、弱い分類器のバランシング後より良かった |
| データを集める | 少数派の本物のデータを増やす | 合成ではなく、実際のデータが増える |
まとめ
- 不均衡データ: 正解率が高くても、少数派を見つけられているとは限らない。再現率などで見る
- SMOTE: オーバーサンプリングの手法の1つ。少数派の点と、その近くの少数派の点を結ぶ線分上に、合成データを作って増やす
- 使い方: データを分けてから、訓練データにだけ適用する。評価は、元の分布で行う
- 限界: 確率がゆがむことがある。強い分類器では、しきい値の調整と同程度の効果にとどまることがある
参考文献
- Chawla, N. V., Bowyer, K. W., Hall, L. O., & Kegelmeyer, W. P. (2002). SMOTE: Synthetic minority over-sampling technique. Journal of Artificial Intelligence Research, 16, 321–357. https://doi.org/10.1613/jair.953
- van den Goorbergh, R., van Smeden, M., Timmerman, D., & Van Calster, B. (2022). The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression. Journal of the American Medical Informatics Association, 29(9), 1525–1534. https://doi.org/10.1093/jamia/ocac093
- Elor, Y., & Averbuch-Elor, H. To SMOTE, or not to SMOTE? arXiv:2201.08528. https://arxiv.org/abs/2201.08528