はじめに
新しいモデルを評価したら、全体のMAPEは10.0%でした。今のモデルも10.1%です。数字だけを見ると、どちらを使っても同じに思えます。
ところが店舗の規模で分けてみると、片方は小さな店舗だけで30%も外していた、ということが起こり得ます。全体の数字は一つにまとめた平均なので、どこで外しているかまでは教えてくれません。
この記事で考える問いは次の1つです。
全体のMAPEが同じなら、2つのモデルは同じくらい使えると言えるか?
シミュレーションデータで実験し、MAPEの平均に隠れやすい2つのパターンと、それを見つけるための確認手順を紹介します。
前提:MAPEは「行ごとの誤差率」の平均
MAPE(平均絶対パーセント誤差)は、行ごとに実績値に対する誤差の割合を出し、それを平均した指標です。
y_i は実績値、ŷ_i は予測値です。データをいくつかのセグメント(店舗の規模、曜日など)に分けると、全体のMAPEは次のように書き直せます。
つまり全体のMAPEは、セグメント別のMAPEを行数で重み付けした平均です。行数の少ないセグメントの誤差は、全体の数字には小さくしか反映されません。
比較のため、WAPE(重み付き絶対パーセント誤差)も使います。
WAPEは誤差の合計を実績の合計で割るので、実績の大きい行ほど重く扱われます。
なお、実績値が0の行では割り算ができず、MAPEを計算できません。この記事の実験では、実績値が0にならないようにデータを作っています。
MAPEの平均に隠れる2つのパターン
全体のMAPEが重み付け平均であることから、次の2つのパターンが隠れやすくなります。
| パターン | 何が起きるか | 全体MAPEへの影響 |
| 1. 少数派で大きく外す | 行数が少ないセグメントだけで、誤差率が大きい | 薄まって見えにくい |
| 2. 実績値が大きい行で外す | 誤差の大きさが同じでも、実績値が小さい行ほど誤差率が大きくなる | 実績値の小さいセグメントに引っ張られる |
パターン1は「悪いところが隠れる」、パターン2は「悪く見えるところが偏る」と言い換えられます。どちらも、全体の数字1つだけでは区別ができません。
実験:全体のMAPEがほぼ同じ3つのモデル
設定
店舗×日の売り上げデータをシミュレーションで作りました。期間は100日で、合計5000行です。
- 通常店舗:40店、売上の平均は約500(行数の80%)
- 小規模店舗:10店、売上の平均は約50(行数の20%)
予測は次の3つを用意しました。
| モデル | 誤差の作り方 |
| A | どちらの店舗でも、誤差率10%前後 |
| B | 通常店舗で5%前後、小規模店舗で30%前後 |
| C | どの店舗でも、誤差の大きさ(個数)が同じくらい |
モデルBは、0.8×5% + 0.2×30% = 10%となるように設計しています。
結果
| モデル | 範囲 | 行数 | MAPE(%) | WAPE(%) |
| A | 全体 | 5000 | 10.0 | 10.0 |
| A | 通常店舗 | 4000 | 10.0 | 10.0 |
| A | 小規模店舗 | 1000 | 10.2 | 10.2 |
| B | 全体 | 5000 | 10.1 | 5.5 |
| B | 通常店舗 | 4000 | 5.0 | 5.0 |
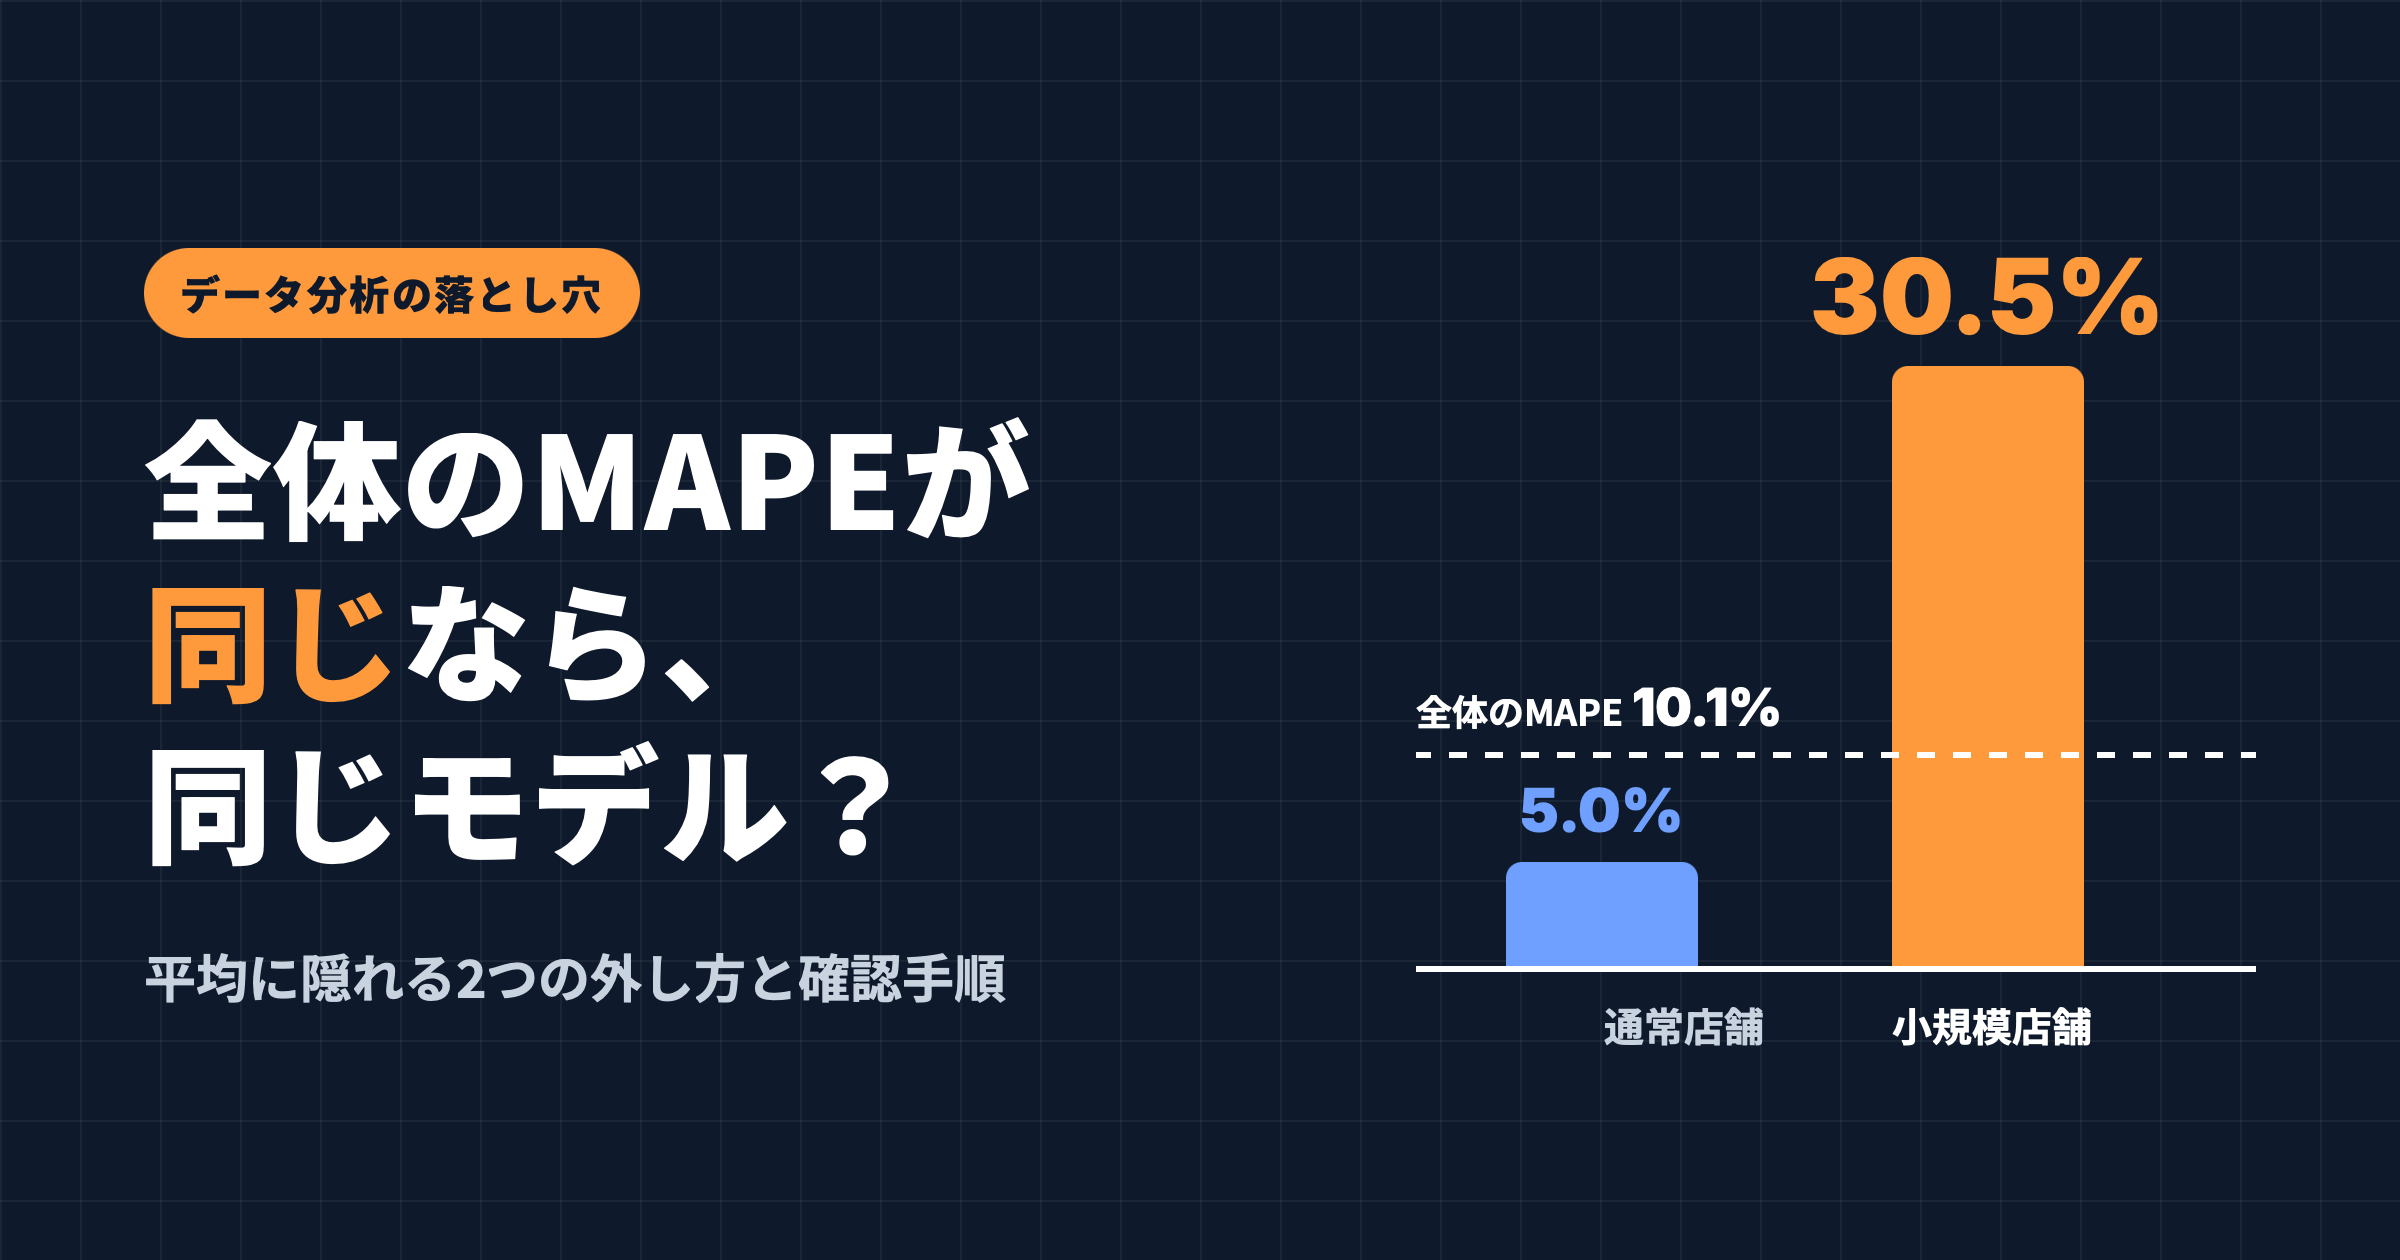
| B | 小規模店舗 | 1000 | 30.5 | 30.6 |
| C | 全体 | 5000 | 9.8 | 3.8 |
| C | 通常店舗 | 4000 | 3.2 | 3.1 |
| C | 小規模店舗 | 1000 | 36.0 | 34.4 |
全体のMAPEは、Aが10.0%、Bが10.1%、Cが9.8%で、ほぼ同じです。
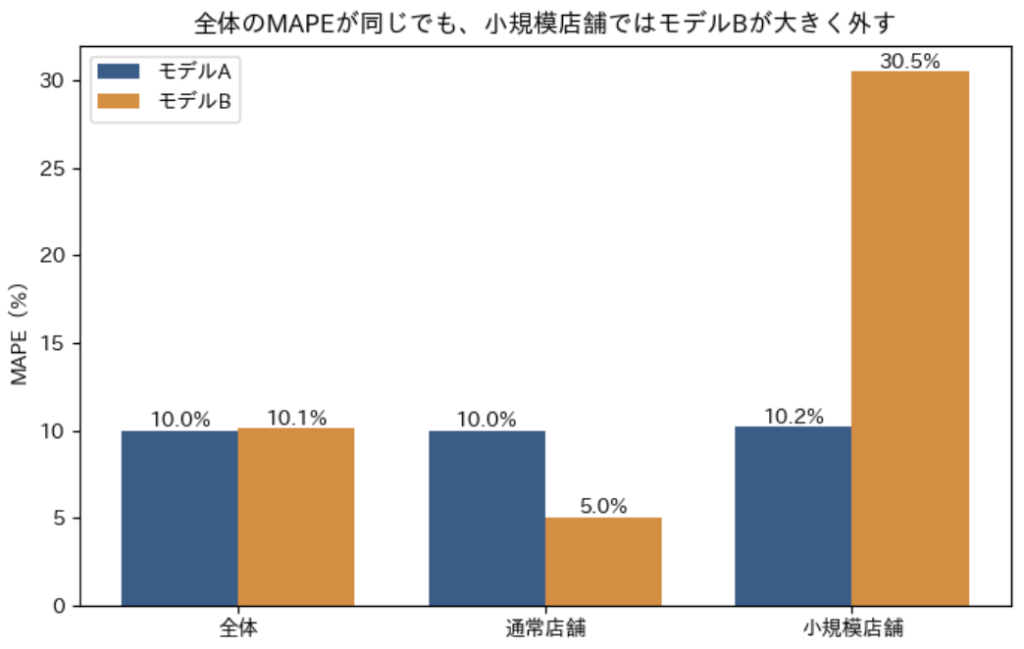
上の図は、モデルAとBのMAPEを、全体とセグメント別に並べたものです。全体では同じ高さですが、分けるとBは通常店舗で5.0%、小規模店舗で30.5%でした。小規模店舗は行数の20%しかないため、30.5%という大きな誤差が全体では薄まり、Aと区別がつかなくなっています(パターン1)。
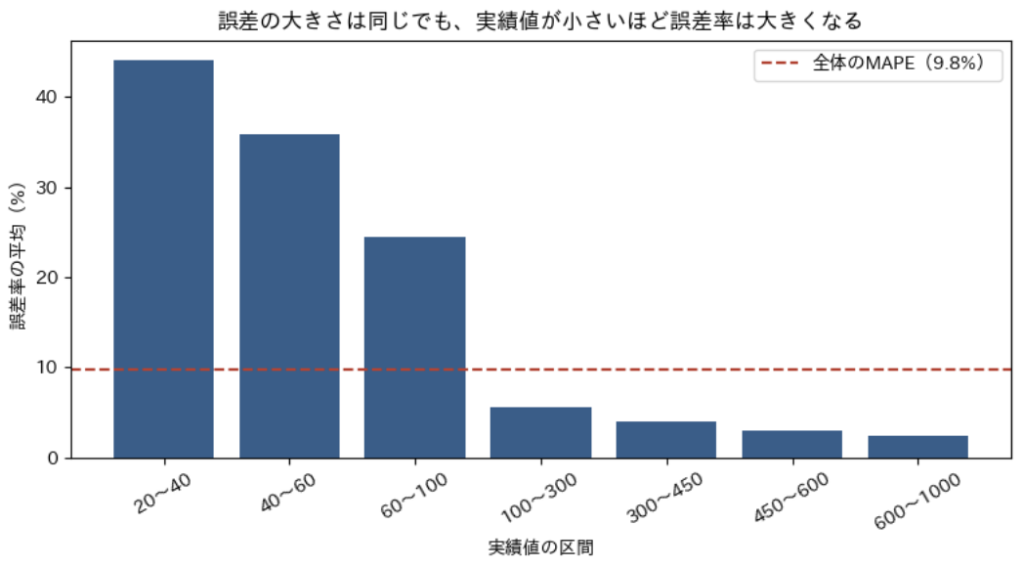
上の図は、モデルCの誤差率を、実績値の区間別に並べたものです。誤差の大きさの平均は、どの区間でも16前後でほぼ同じでした。それでも誤差率は、実績20〜40の区間で44.1%、600〜1000の区間で2.4%と大きく開いています(パターン2)。
モデルCは、通常店舗のMAPEが3.2%で、3つの中で最も低い値です。全体のMAPEを押し上げているのは、少数店舗の36.0%でした。 WAPEで見るとCは3.8%で、MAPEの9.8%と大きく食い違います。
一方で、モデルBの全体のWAPEは5.5%でした。WAPEは実績値の小さい行を軽く扱うので、小規模店舗で外していることは、MAPEよりさらに見えにくくなります。
見分け方:4つの確認手順
実験の結果から、全体のMAPEを見たあとに確認したい手順を4つにまとめます。
- 全体のMAPEを出す。 まずは比べるための基準の数字です。
- セグメント別のMAPEを、行数と一緒に並べる。 行数を添えると、そのセグメントが全体にどれだけ効いているかがわかります。切り口の例は、店舗の規模、曜日、開店からの期間、地域などです。
- 実績値の大きさ別に、誤差率と誤差の大きさを並べる。 誤差の大きさがそろっているのに誤差率だけが跳ねるなら、原因は実績値の小ささです(パターン2)。
- WAPEを併記し、MAPEとの差を見る。 差が大きければ、実績値の小さい行の影響を疑います。ただしWAPEは実績値の小さい行を軽く扱うので、パターン1の確認には向きません。手順2と組み合わせて使います。
対処法と使い分け
見つけた外し方への対処は、次の流れで判断できます。
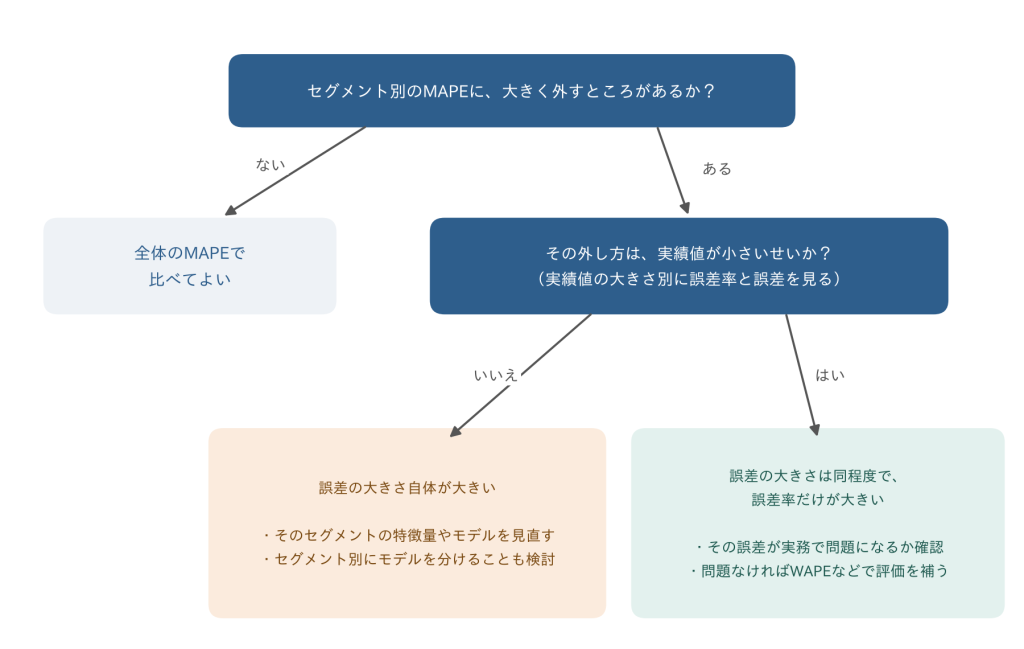
実験のモデルBは、上の流れでは「いいえ」に進むケースです。通常店舗ではAより良いので、どちらを選ぶかは使い方次第です。小規模店舗の予測も使うならA、通常店舗が中心ならBという判断になります。両方のいいところを取るなら、セグメントでモデルを使い分ける方法もあります。
モデルCは「はい」に進むケースです。小規模店舗での16個前後の誤差が、在庫や人員の計画で問題になるかどうかで判断が変わります。
自分が精度を報告するときは、全体の数字にセグメント別の表を必ず添えるようにしています。同じ10%でも、中身が違えば次にやるべきことが変わるからです。
まとめ
最初の問いは「全体のMAPEが同じなら、2つのモデルは同じくらい使えると言えるか?」でした。答えは「言えない」です。
今回の実験では、全体のMAPEがほぼ10%でそろった3つのモデルが、セグメント別に見ると全く違う姿をしていました。モデルBは小規模店舗で30.5%外し、モデルCは実績値の小さい行で誤差率が跳ね上がっていました。全体のMAPEは行ごとの誤差率の平均なので、少数派の大きな誤差は薄まり、実績値の小さい行の誤差率は大きく出ます。
全体の数字を見たら、セグメント別のMAPEを行数と並べ、実績値の大きさ別の誤差率とWAPEも合わせて確認する。この手順を挟むだけで、平均に隠れた「外しているところ」が見つけやすくなります。
なお、今回の結果では、2つのセグメントを持つ人工データで、誤差の大きさを人為的に設定した条件でのものです。