隠れマルコフモデルとは
隠れマルコフモデル(Hidden Markov Model, HMM)は、時間とともに変化するデータを確率的に表現するモデルです。観測可能なデータの背後に、直接は観測できない「隠れ状態」が存在すると仮定します。
時系列データを扱う現実の問題では、観測値そのものより、それを生み出している内部状態に関心があることが少なくありません。HMMは、このような状況を数理的に扱うための枠組みです。
HMMの基盤には、確率過程としてのマルコフ過程があります。マルコフ過程では、「現在の状態が分かれば、将来の状態は過去全体に依存しない」と仮定します。HMMは、このマルコフ性を持つ状態が直接観測できない場合を扱えるように拡張したモデルです。
時刻 $t=1,2,\ldots,T$ における隠れ状態を $X_t$、観測値を $Y_t$ とします。観測系列 $Y_1,Y_2,\ldots,Y_T$ は与えられていますが、状態系列 $X_1,X_2,\ldots,X_T$ は直接観測できない確率変数として扱います。
HMMが長年にわたって利用されてきた理由は、時間構造を持つデータを解釈しやすい形でモデル化できるためです。観測と状態を分けることで、データ生成の仕組みを明示的に表現できます。また、尤度計算・状態推定・パラメータ学習を効率的に行うアルゴリズムが確立されており、音声認識や自然言語処理などの分野で標準的なモデルとして利用されてきました。
隠れ状態と観測の関係
HMMでは、時間とともに変化する状態系列と、その状態から生成される観測系列を区別します。
- 状態は、直前の状態のみに依存して遷移する
- 観測値は、その時刻の状態に依存して確率的に生成される
この構造により、状態の時間的な変化と、状態から観測が生まれる仕組みを分離して表現できます。観測データしか得られない状況でも、その背後にある状態の遷移を確率的に推定できることが、HMMの中核的なアイデアです。
例:傘から天気を推定する
窓のない部屋にいて、外の天気(隠れ状態:晴れ/雨)を直接確認できないとします。一方、毎朝、同僚が傘を持って出社したかどうか(観測値:傘あり/傘なし)は分かります。
ここで、次の2つを仮定します。
- 天気は前日の天気に依存して変化する
- 傘を持ってくる確率は、その日の天気に依存する
「3日間、毎日傘を持ってきた」という観測系列は、次のように表せます。
$$
Y_1=\text{傘あり},\quad
Y_2=\text{傘あり},\quad
Y_3=\text{傘あり}
$$
この観測だけから、実際の天気の系列 $(X_1,X_2,X_3)$ がどのような状態だった可能性が高いかを推定することが、HMMの典型的な使い方です。
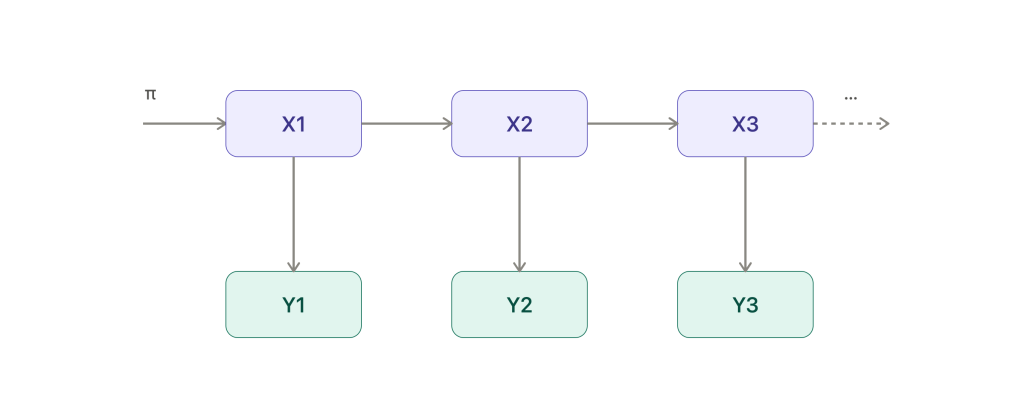
図1:紫が隠れ状態、緑が観測値。各時刻の観測値は、その時刻の隠れ状態のみに依存して生成される。
マルコフ性と状態遷移
HMMでは、状態系列がマルコフ性を満たすと仮定します。つまり、現在の状態が分かれば、次の状態はそれ以前の状態に依存しません。
任意の状態 $i,j$ に対する状態遷移確率を、次のように定義します。
各 $a_{ij}$ を要素とする行列 $A=(a_{ij})$ が、状態遷移のルールを表します。
傘の例で、状態の順序を「晴れ、雨」とすると、遷移行列は次のようになります。
$$
A=
\begin{pmatrix}
0.7 & 0.3\\
0.4 & 0.6
\end{pmatrix}
$$
行は現在の天気、列は翌日の天気を表します。例えば、晴れの翌日も晴れである確率は $a_{\mathrm{晴れ},\mathrm{晴れ}}=0.7$、雨に変わる確率は $a_{\mathrm{晴れ},\mathrm{雨}}=0.3$ です。
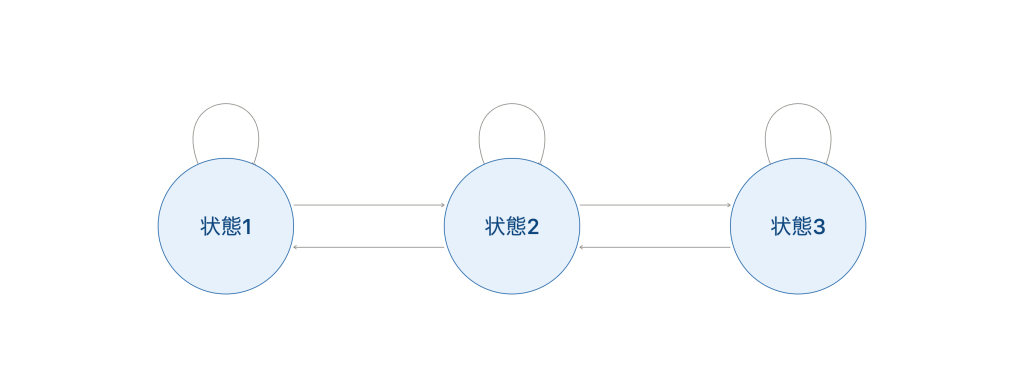
図2:円上のループは自己遷移確率 $a_{ii}$、円同士を結ぶ矢印は状態間の遷移確率 $a_{ij}$($i\neq j$)を表す。
観測生成モデル
HMMでは、各時刻の観測値は、その時刻の隠れ状態のみに依存して生成されると仮定します。この条件付き独立性は、次のように表せます。
状態 $X_t=j$ のときに観測 $Y_t=y$ が得られる確率を、出力確率または観測確率と呼びます。
観測値が離散値の場合はカテゴリ分布、連続値の場合は正規分布などがよく用いられます。
傘の例で、状態の順序を「晴れ、雨」、観測の順序を「傘あり、傘なし」とすると、観測確率行列は次のようになります。
$$
B=
\begin{pmatrix}
0.1 & 0.9\\
0.8 & 0.2
\end{pmatrix}
$$
例えば、雨の日に傘を持ってくる確率は $b_{\mathrm{雨}}(\mathrm{傘あり})=0.8$ です。
初期状態分布とモデルの定義
時系列の開始時点における状態も確率的に定義します。初期状態分布は、次のように表されます。
$$
\pi_i=P(X_1=i)
$$
以上から、HMMは次の3要素で定義されます。
- 初期状態分布:$\boldsymbol{\pi}$
- 状態遷移確率:$A$
- 観測生成確率:$B$
モデル全体を、まとめて次のように表すこともあります。
$$
\lambda=(\boldsymbol{\pi},A,B)
$$
観測系列と状態系列の同時分布
HMMの重要な特徴は、状態系列と観測系列の同時分布を単純な形に分解できることです。
状態系列を $X_{1:T}=(X_1,\ldots,X_T)$、観測系列を $Y_{1:T}=(Y_1,\ldots,Y_T)$ とすると、同時確率は次のように表せます。
この分解構造により、時系列全体の確率計算、状態推定、パラメータ学習を効率的に実行できます。図1は、この依存関係を図示したものです。
HMMで解く3つの代表的な問題
HMMでは、主に次の3種類の問題を扱います。
尤度計算
与えられたモデル $\lambda$ のもとで、観測系列 $Y_{1:T}$ が得られる確率を計算します。
$$
P(Y_{1:T}\mid\lambda)
$$
これは、モデルが観測データにどの程度適合しているかを評価するために重要です。
状態系列の推定
観測系列が与えられたとき、最も確からしい状態系列を求めます。
パラメータ学習
観測データから、モデルパラメータ $\boldsymbol{\pi},A,B$ を推定します。典型的には、観測系列の尤度を最大化する問題として定式化します。
| 問題 | 代表的なアルゴリズム |
|---|---|
| 尤度計算 | 前向き・後向きアルゴリズム |
| 最も確からしい状態系列の推定 | ビタビアルゴリズム |
| パラメータ学習(教師なし) | バウム・ウェルチアルゴリズム(EMアルゴリズムの一種) |
まとめ
隠れマルコフモデルは、時間とともに変化する隠れ状態と観測データを、マルコフ性と条件付き独立性の仮定によって結びつけた確率モデルです。
要点は次の3つです。
- 隠れ状態は、直前の状態に依存して遷移する
- 観測値は、その時刻の隠れ状態から確率的に生成される
- この構造を利用して、尤度計算・状態推定・パラメータ学習を効率的に行える
HMMは比較的単純な構造を持ちながら、時系列データの背後にある状態を解釈可能な形で推定できます。時系列解析や確率モデルを学ぶうえで、理論と応用をつなぐ基礎的なモデルです。